add evaluation-guidebook notes: HF guidebook knowledge (2024 GitHub + 2025 Space) into LLM_Evaluation
- Add 9 Chinese distilled notes under 04-Reference-Archive/evaluation-guidebook/
  covering automated benchmarks, human evaluation, LLM-as-a-judge,
  troubleshooting, general knowledge, yearly dives, resources, and the
  2025 HF Space edition (FineWeb eval-selection methodology, MCF/CF/FG,
  sampling metrics, Math-Verify, statistical validity & cost)
- Update zone README and Material-List with entry links
This commit is contained in:
 windyboy
@@ -18,6 +18,20 @@ created: 2026-08-21
|
|||||||
| [[02_Areas/Job/llm_data_annotation_programmer_roadmap\|大模型数据标注与程序员入门]](原文存于 02_Areas/Job,本专区不再复制副本) | 职业全景与程序员能力迁移背景 | 想理解岗位、方向与能力地图时 | 覆盖面广,但不是第一个项目的直接操作材料。 |
|
| [[02_Areas/Job/llm_data_annotation_programmer_roadmap\|大模型数据标注与程序员入门]](原文存于 02_Areas/Job,本专区不再复制副本) | 职业全景与程序员能力迁移背景 | 想理解岗位、方向与能力地图时 | 覆盖面广,但不是第一个项目的直接操作材料。 |
|
||||||
| [[02-Intro-Cognitive-Framework-Draft]] | Why Guide 的概念设计底稿 | 想研究内容设计或自行扩展课程时 | 已被正式 Why Guide 吸收,不建议日常阅读。 |
|
| [[02-Intro-Cognitive-Framework-Draft]] | Why Guide 的概念设计底稿 | 想研究内容设计或自行扩展课程时 | 已被正式 Why Guide 吸收,不建议日常阅读。 |
|
||||||
| [[03-Roadmap-Refactor-Outline-Draft]] | Practical Roadmap 的结构设计底稿 | 想理解路线如何从审阅意见演化时 | 正式路线图已更完整,草案只保留历史价值。 |
|
| [[03-Roadmap-Refactor-Outline-Draft]] | Practical Roadmap 的结构设计底稿 | 想理解路线如何从审阅意见演化时 | 正式路线图已更完整,草案只保留历史价值。 |
|
||||||
|
| [[evaluation-guidebook/00-Overview\|HuggingFace Evaluation Guidebook 中文提炼(子目录)]] | 外部权威评测知识参考(自动基准 / 人工评测 / LLM-as-judge / 排错等) | 设计或执行评测时按主题查阅 | 是外部资料的提炼笔记,作为查阅型参考而非个人学习主线的必经之路。 |
|
||||||
|
|
||||||
|
## 外部知识参考(evaluation-guidebook 子目录)
|
||||||
|
|
||||||
|
对 [HuggingFace Evaluation Guidebook](https://github.com/huggingface/evaluation-guidebook) 的中文提炼笔记:
|
||||||
|
|
||||||
|
- [[evaluation-guidebook/00-Overview|总览:这是什么、怎么读]]
|
||||||
|
- [[evaluation-guidebook/01-Automatic-Benchmarks|自动基准评测]]
|
||||||
|
- [[evaluation-guidebook/02-Human-Evaluation|人工评测]]
|
||||||
|
- [[evaluation-guidebook/03-LLM-as-a-Judge|LLM-as-a-Judge(模型作评委)]]
|
||||||
|
- [[evaluation-guidebook/04-Troubleshooting|排错(推理 / LaTeX / 可复现性)]]
|
||||||
|
- [[evaluation-guidebook/05-General-Knowledge|通用知识(推理与评测 / Tokenization)]]
|
||||||
|
- [[evaluation-guidebook/06-Yearly-Dives|年度深度文章(2023–2025)]]
|
||||||
|
- [[evaluation-guidebook/07-Resources|资源链接清单]]
|
||||||
|
|
||||||
## 正式学习材料不在本目录
|
## 正式学习材料不在本目录
|
||||||
|
|
||||||
|
|||||||
+93
@@ -0,0 +1,93 @@
|
|||||||
|
---
|
||||||
|
type: reference
|
||||||
|
tags:
|
||||||
|
- llm-evaluation
|
||||||
|
- evaluation-guidebook
|
||||||
|
- overview
|
||||||
|
status: active
|
||||||
|
created: 2026-08-21
|
||||||
|
source: https://github.com/huggingface/evaluation-guidebook
|
||||||
|
---
|
||||||
|
|
||||||
|
# HuggingFace LLM Evaluation Guidebook 总览
|
||||||
|
|
||||||
|
> 外部权威参考的来源说明:本子目录的内容是对 [HuggingFace Evaluation Guidebook](https://github.com/huggingface/evaluation-guidebook)(旧版,GitHub 仓库)与 [OpenEvals 新版(2025)](https://huggingface.co/spaces/OpenEvals/evaluation-guidebook)(HuggingFace Space)的中文提炼笔记,按主题拆成独立页面,供本专区在设计与执行评测时查阅。
|
||||||
|
|
||||||
|
## 这是什么
|
||||||
|
|
||||||
|
**The LLM Evaluation Guidebook** 是 HuggingFace 团队(主要作者 Clémentine Fourrier,Open LLM Leaderboard 与 lighteval 的设计者)编写的 LLM 评测实战指南。它回答一个核心问题:
|
||||||
|
|
||||||
|
> 如何确保一个 LLM 在你自己的具体任务上表现良好?
|
||||||
|
|
||||||
|
内容覆盖:评测模型的不同方式、如何设计自己的评测、以及从实际评测工程中沉淀的经验教训(Tips and Tricks)。
|
||||||
|
|
||||||
|
## 两个版本
|
||||||
|
|
||||||
|
| | 旧版(GitHub 仓库) | 新版(HF Space,2025-12) |
|
||||||
|
|---|---|---|
|
||||||
|
| 地址 | [github.com/huggingface/evaluation-guidebook](https://github.com/huggingface/evaluation-guidebook) | [huggingface.co/spaces/OpenEvals/evaluation-guidebook](https://huggingface.co/spaces/OpenEvals/evaluation-guidebook) |
|
||||||
|
| 形态 | 章节式 Markdown 指南 | 交互式"科研论文"(Astro + MDX,含可交互图表) |
|
||||||
|
| 作者 | Clémentine Fourrier | Fourrier、Thibaud Frere、Guilherme Penedo、Thomas Wolf |
|
||||||
|
| 副标题 | — | "基于 3 年评测 15000 个模型的经验,你想知道的关于 LLM 评测的一切" |
|
||||||
|
| 状态 | 已停止维护(README 声明) | 当前维护版本(2025-12-03 发布,CC BY 4.0) |
|
||||||
|
| 本专区笔记 | [[01-Automatic-Benchmarks]] ~ [[07-Resources]] | [[08-2025-Edition]](新版独有内容提炼) |
|
||||||
|
|
||||||
|
> ⚠️ **维护状态**:旧仓库已声明不再维护(截至 2025 年 12 月),最新版本迁移到 HuggingFace Space。本目录 01–07 篇整理的是旧版 GitHub 仓库内容;[[08-2025-Edition]] 提炼新版(2025)相对旧版新增/变化的内容。两份内容大部分重叠,建议以新版为主、旧版为补充。
|
||||||
|
|
||||||
|
## 指南结构(旧版仓库目录)
|
||||||
|
|
||||||
|
| 章节 | 内容 | 本专区对应笔记 |
|
||||||
|
|---|---|---|
|
||||||
|
| **Automatic benchmarks** | 自动化基准评测:basics、设计自己的自动评测、常用评测数据集、Tips | [[01-Automatic-Benchmarks]] |
|
||||||
|
| **Human evaluation** | 人工评测:basics、如何使用标注者、Tips | [[02-Human-Evaluation]] |
|
||||||
|
| **LLM-as-a-judge** | 模型作评委:basics、选择 judge LLM、设计评测 prompt、评估你的 evaluator、奖励模型 | [[03-LLM-as-a-Judge]] |
|
||||||
|
| **Troubleshooting** | 指南中最实操的部分:推理排错、LaTeX 数学解析、可复现性 | [[04-Troubleshooting]] |
|
||||||
|
| **General knowledge** | LLM 基础:模型推理与评测、tokenization | [[05-General-Knowledge]] |
|
||||||
|
| **Yearly dives** | 2023/2024/2025 年度深度文章 | [[06-Yearly-Dives]] |
|
||||||
|
| **Resources** | 评测与 NLP 推荐链接清单 | [[07-Resources]] |
|
||||||
|
|
||||||
|
## 新版结构(2025 Space,按渲染顺序)
|
||||||
|
|
||||||
|
| 章节 | 内容 | 备注 |
|
||||||
|
|---|---|---|
|
||||||
|
| Intro | 评测视角:model builder vs model user、智能定义的困境 | 新版新增 |
|
||||||
|
| Model inference and evaluation | Tokenization、推理、MCF/CF/FG 三种任务形式、calibration | 比旧版更细 |
|
||||||
|
| 2025 evaluations | 2025 分能力评测全景(推理/知识/数学/代码/长上下文/指令遵循/工具调用/游戏化) | 新版核心,替代旧版 Yearly Dives 2025 |
|
||||||
|
| Troubleshooting reproducibility | 可复现性排错(代码库/种子/指标名/normalization/prompt/参数) | 旧版有对应章节 |
|
||||||
|
| Picking good automatic evaluations for pretraining | FineWeb 团队预训练评测选型方法论(185 任务、SNR、单调性、排序一致性) | **全新内容** |
|
||||||
|
| Designing your automatic evaluation | 设计自动评测全流程(数据集/提示词/推理方式/评分/自由文本评分/约束输出/统计有效性/成本) | 内含 Using human annotators |
|
||||||
|
| Conclusion | 五条核心建议 | — |
|
||||||
|
|
||||||
|
> 注:仓库中 `some-evaluation-datasets.mdx` 存在但新版页面未直接渲染(正文链接回旧版 GitHub 的同类页面);`using-human-annotators.mdx` 通过 import 嵌入 designing 章节。
|
||||||
|
|
||||||
|
## 建议阅读方式
|
||||||
|
|
||||||
|
原作者的建议(旧版):
|
||||||
|
|
||||||
|
- **初学者**:从每个章节的 *Basics* 部分开始,需要 LLM 基础补课时读 *General knowledge*。
|
||||||
|
- **进阶用户**:直接看每个章节的 *Tips and Tricks* 与 *Troubleshooting* 章节。
|
||||||
|
- **回访用户**:每年一篇的 Yearly dives(每年的主题深潜)。
|
||||||
|
|
||||||
|
文内标记 ⭐ 的链接是作者特别推荐阅读的资源。
|
||||||
|
|
||||||
|
## 与本专区的关系
|
||||||
|
|
||||||
|
- 本专区(LLM_Evaluation)是**面向个人学习与工程能力养成**的中文路线(概念 → 为什么 → 工作表 → 项目 → 完整路线图)。
|
||||||
|
- 本子目录是**外部权威知识参考**:需要深入某个评测主题(如设计自动评测、写 judge prompt、排查复现问题)时,从这里查阅提炼后的要点,并按需回到原文细读。
|
||||||
|
- 两者互补:专区路线图负责"做什么、按什么顺序做",guidebook 笔记负责"具体怎么做、有哪些坑"。
|
||||||
|
|
||||||
|
## 引用
|
||||||
|
|
||||||
|
旧版(GitHub):
|
||||||
|
|
||||||
|
```bibtex
|
||||||
|
@misc{fourrier2024evaluation,
|
||||||
|
author = {Clémentine Fourrier and The Hugging Face Community},
|
||||||
|
title = {LLM Evaluation Guidebook},
|
||||||
|
year = {2024},
|
||||||
|
journal = {GitHub repository},
|
||||||
|
url = {https://github.com/huggingface/evaluation-guidebook}
|
||||||
|
}
|
||||||
|
```
|
||||||
|
|
||||||
|
许可证:旧版 CC BY-NC-SA 4.0;新版 CC BY 4.0。
|
||||||
+517
@@ -0,0 +1,517 @@
|
|||||||
|
---
|
||||||
|
type: reference
|
||||||
|
tags:
|
||||||
|
- llm-evaluation
|
||||||
|
- evaluation-guidebook
|
||||||
|
- automatic-benchmarks
|
||||||
|
status: active
|
||||||
|
created: 2026-08-21
|
||||||
|
source: https://github.com/huggingface/evaluation-guidebook
|
||||||
|
---
|
||||||
|
|
||||||
|
# 自动基准评测(Automated Benchmarks)— LLM Evaluation Guidebook 提炼笔记
|
||||||
|
|
||||||
|
> **来源**:[HuggingFace evaluation-guidebook](https://github.com/huggingface/evaluation-guidebook) 的 `contents/automated-benchmarks/` 章节,包含四篇:
|
||||||
|
> basics(自动化基准是什么)、designing-your-automatic-evaluation(如何设计自己的自动评测)、some-evaluation-datasets(常用评测数据集盘点)、tips-and-tricks(实战技巧)。
|
||||||
|
>
|
||||||
|
> **性质**:中文提炼式笔记,非逐字翻译;关键英文术语保留原文。文内 ⭐ 标记的链接是作者特别推荐阅读的资源(同 [[00-Overview]] 的约定)。
|
||||||
|
>
|
||||||
|
> **关联笔记**:[[02-Human-Evaluation]](人工评测)、[[03-LLM-as-a-Judge]](模型作评委)、[[04-Troubleshooting]](排错与可复现性)。
|
||||||
|
|
||||||
|
## 目录
|
||||||
|
|
||||||
|
- [1. 核心概念](#1-核心概念task--capability--dataset--metric--样本--泛化)
|
||||||
|
- [2. 自动化基准的优缺点](#2-自动化基准的优缺点)
|
||||||
|
- [3. 如何设计自己的自动评测](#3-如何设计自己的自动评测)
|
||||||
|
- [4. 常用评测数据集盘点](#4-常用评测数据集盘点)
|
||||||
|
- [5. Tips and Tricks](#5-tips-and-tricks)
|
||||||
|
- [6. 参考资料](#6-参考资料)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 速览(TL;DR)
|
||||||
|
|
||||||
|
| 问题 | 一句话答案(详见对应章节) |
|
||||||
|
|---|---|
|
||||||
|
| 自动基准评测是什么? | 用「数据集(输入+gold 参考)+ metric」给模型在 task / capability 上打分;LLM 输出分两类:生成文本(generative)与序列 log-probability(MCQA / perplexity)。([§1](#1-核心概念task--capability--dataset--metric--样本--泛化)) |
|
||||||
|
| 为什么要测模型没见过的数据? | 测的是泛化(generalization);在训练数据上评测等于给模型不具备的能力打分(overfitting 的学生类比)。([§1](#1-核心概念task--capability--dataset--metric--样本--泛化)) |
|
||||||
|
| 自动化基准有什么优势? | 一致可复现、成本低、指标可理解、可用专家级高质量数据(但 MMLU 也有错 → MMLU-Pro/Redux)。([§2](#2-自动化基准的优缺点)) |
|
||||||
|
| 有什么短板? | 复杂能力难分解成精确任务(转向 generalist 评测、性能当 proxy);公开数据集必有 contamination。([§2](#2-自动化基准的优缺点)) |
|
||||||
|
| 评测结果好坏取决于什么? | 取决于评测数据集质量——选数据集要看创建者、标注者一致性、指南、随机抽 50 个样本检查;自建可走聚合/人工标注/合成(LLM 或规则)三条路。([§3.1](#31-选择数据集)) |
|
||||||
|
| 用 log-prob 还是生成式? | 多选题/测知识 → log-prob(快、能给置信度,但高估小模型、对选项顺序敏感);测流利度/推理 → 生成式(更贴近真实关注点,但难打分、更贵)。([§3.2](#32-选择推理方法inference-method)) |
|
||||||
|
| prompt 要注意什么? | 语义等价的微小改动会让结果波动;模型会过拟合 prompt 格式(Llama 3.2 / Qwen 2.5 在 few-shot 里不跟格式);必要时约束输出。([§3.3](#33-选择提示词prompt)) |
|
||||||
|
| 代码评测的聪明做法? | 功能测试:用单元测试验证生成程序(降低过拟合、测主动能力);文本版代表是 IFEval。([§3.5](#35-智能新任务功能测试functional-testing)) |
|
||||||
|
| 数据污染怎么办? | 默认「已污染」;用 canary string、加密/门控发布、动态 benchmark、事后检测(无万全之法)。([§5.1](#51-管理污染managing-contamination)) |
|
||||||
|
| 评测结果意外差? | 先看生成结果:解析太严、few-shot 不跟格式、模型太啰嗦,逐一排查。([§5.3](#53-生成式评测结果异常差时的排查)) |
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 1. 核心概念:task / capability / dataset / metric / 样本 / 泛化
|
||||||
|
|
||||||
|
自动化基准(automated benchmark)通常这样工作:你希望知道模型在某件事上表现如何。这件事可以是:
|
||||||
|
|
||||||
|
- 一个定义清晰的**具体任务(task)**,例如「我的模型能不能区分垃圾邮件与非垃圾邮件(spam / non-spam classification)?」;
|
||||||
|
- 一个更抽象、更一般的**能力(capability)**,例如「我的模型数学能力如何(How good is my model at math)?」。
|
||||||
|
|
||||||
|
### 评测的三要素
|
||||||
|
|
||||||
|
1. **数据集(dataset)**,由**样本(samples)**组成:
|
||||||
|
- 每个样本包含给模型的**输入(input)**,有时配一个用来比对输出的**参考答案(reference,也称 gold)**;
|
||||||
|
- 样本通常刻意设计成贴近你要测的东西:例如做邮件分类,就构造一批垃圾/非垃圾邮件数据集,尽量包含一些难的边界案例(edge cases)。
|
||||||
|
2. **度量(metric)**:给模型打分的方式。
|
||||||
|
- 示例:垃圾邮件分类的准确率(正确分类的样本记 1 分,错误记 0 分);
|
||||||
|
- metric 利用模型输出打分。对 LLM 而言,人们主要考虑两类输出:
|
||||||
|
- 模型根据输入**生成的文本**(*generative evaluation*,生成式评测);
|
||||||
|
- 提供给模型的**一个或多个序列的 log-probability**(*multiple-choice evaluations*,简称 MCQA;或 *perplexity evaluations*,困惑度评测)。
|
||||||
|
- 更多细节见 [Model inference and evaluation](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/general-knowledge/model-inference-and-evaluation.md) 页面。
|
||||||
|
|
||||||
|
### 泛化(generalization)与过拟合(overfitting)
|
||||||
|
|
||||||
|
- 评测最好在**模型从未见过的数据**(不在其训练集里的数据)上进行,因为你测的是它能否**泛化(generalize)**——例如:模型只见过「假银行」类垃圾邮件后,能否正确分类「保健品」类垃圾邮件。
|
||||||
|
- **overfitting**:模型只能在训练数据上预测得好、没有学到更高级的通用模式,就称其过拟合。这就像学生把考题背下来却没理解知识点——**在训练集中已经出现过的数据上评测 LLM,等于给它不会的能力打分**。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 2. 自动化基准的优缺点
|
||||||
|
|
||||||
|
### 优点
|
||||||
|
|
||||||
|
| 优点 | 说明 |
|
||||||
|
|---|---|
|
||||||
|
| **一致性与可复现性(Consistency and reproducibility)** | 同一 benchmark 在同一个模型上跑 10 次结果相同(除硬件差异或模型固有随机性外)。因此可以方便地为给定任务建立公平的模型排名。 |
|
||||||
|
| **低成本规模化(Scale at limited cost)** | 目前最廉价的评测模型方式之一。 |
|
||||||
|
| **可理解性(Understandability)** | 大多数自动化指标非常易懂:exact match 告诉你生成文本是否与参考完全一致;accuracy 告诉你选对选项的次数占比。(相比而言 `BLEU`、`ROUGE` 这类指标就没那么直观。) |
|
||||||
|
| **数据集质量(Dataset quality)** | 不少 benchmark 使用专家生成的数据集或已有的高质量数据(如 MMLU、MATH)。但高质量 ≠ 完美:MMLU 事后被发现样本中有若干错误(从解析问题到实际上无意义的问题),催生了 MMLU-Pro、MMLU-Redux 等后续数据集。 |
|
||||||
|
|
||||||
|
### 局限
|
||||||
|
|
||||||
|
1. **对复杂任务的使用受限**:自动化基准擅长性能容易定义和评估的任务(如分类)。更复杂的能力很难分解成定义清晰、精确的子任务。
|
||||||
|
- 例如「数学好」到底指什么?算术好?逻辑好?能对新数学概念推理?
|
||||||
|
- 这催生了更多**通用型(generalist)评测**:不再把能力拆成子任务,而是假设整体表现是所测目标的**良好代理指标(good proxy)**。
|
||||||
|
2. **污染(Contamination)**:数据集一旦以纯文本形式公开,就会进到模型训练数据里。因此打分时你无法保证模型没解析过评测数据。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 3. 如何设计自己的自动评测
|
||||||
|
|
||||||
|
核心原则:**你的评测结果只会和你的评测数据集一样好(your evaluation result will only be as good as your evaluation dataset)**。
|
||||||
|
|
||||||
|
#### 设计自动评测的完整流程(对照清单)
|
||||||
|
|
||||||
|
把原文的设计建议串成一条可执行的流程,每个步骤的细节见对应小节:
|
||||||
|
|
||||||
|
1. **明确要测什么**:具体 task(如垃圾邮件分类)还是抽象 capability(如数学能力)?([§1](#1-核心概念task--capability--dataset--metric--样本--泛化))
|
||||||
|
2. **选或建数据集**:优先复用已有高质量数据集;自建可走聚合现有数据 / 人工标注 / 合成数据(LLM 生成或基于规则)。([§3.1](#31-选择数据集))
|
||||||
|
3. **检查样本**:已有数据集看创建者与标注流程(专家 > 付费 ≈ 众包 > MTurk)、标注者一致性、创建指南;随机抽 50 个样本查质量与相关性;样本数 ≥ 100 才统计显著。([§3.1](#31-选择数据集))
|
||||||
|
4. **选推理方法**:MCQA(log-probabilities)还是生成式(generative)?([§3.2](#32-选择推理方法inference-method))
|
||||||
|
5. **设计 prompt**:task prompt / context / question / options / connector words;注意 prompt 敏感性、few-shot、格式过拟合。([§3.3](#33-选择提示词prompt))
|
||||||
|
6. **选 metric**:log-prob 侧用按长度归一化的 accuracy / perplexity / recall / f1;生成侧先决定是否归一化、再决定匹配方式(exact match、ROUGE、BLEU…);想清楚任务到底关心平均还是最差表现。([§3.4](#34-选择度量metric))
|
||||||
|
7. **跑评测 + 复盘**:检查生成结果(解析、格式遵循、长度),关注 contamination 与 tokenization 坑。([§5](#5-tips-and-tricks))
|
||||||
|
|
||||||
|
### 3.1 选择数据集
|
||||||
|
|
||||||
|
要么选已有数据集(见 [第 4 节](#4-常用评测数据集盘点)),要么自己设计。过程中必须紧盯上面这条原则。
|
||||||
|
|
||||||
|
#### 选用已有数据集:必须检查的组件
|
||||||
|
|
||||||
|
**(1)创建过程(Creation process)**
|
||||||
|
|
||||||
|
- **样本是谁创建的?** 作者给出的质量排序(作者观点):
|
||||||
|
> 专家创建(expert created)> 付费标注者(paid annotator)≈ 众包(crowdsourced)> MTurk 标注
|
||||||
|
- 找数据卡(data card),看**标注者人口学信息(annotator demographics)**——对理解数据集的语言多样性很重要。
|
||||||
|
- **样本是否被其他标注者或作者复核过?** 要确认:标注者间一致性分数(inter-annotator score)是否高(标注者是否达成共识)、以及/或作者是否审查过整个数据集。
|
||||||
|
- 这对「用低薪标注者(通常不是你目标语言的母语者,如 AWS Mechanical Turk)」的数据集尤其重要,否则你可能发现拼写错误/语法错误/无意义答案。
|
||||||
|
- **标注者是否拿到清晰的数据创建指南(data creation guidelines)?** 换句话说:你的数据集一致吗?
|
||||||
|
|
||||||
|
**(2)样本(Samples)**
|
||||||
|
|
||||||
|
取 50 个随机样本人工检查:
|
||||||
|
|
||||||
|
- *质量(quality)*:
|
||||||
|
- prompt 是否清晰无歧义?
|
||||||
|
- 答案是否正确?(例:TriviaQA 每个问题有多个 gold 答案(aliases 字段),有时互相冲突。)
|
||||||
|
- 信息是否缺失?(例:MMLU 的不少问题缺少参考示意图(reference schematics)。)
|
||||||
|
- *与任务的相关性(relevance)*:
|
||||||
|
- 这些是你想用 LLM 评测的问题类型吗?
|
||||||
|
- 这些例子与你的 use case 相关吗?
|
||||||
|
|
||||||
|
还要知道数据集有多少样本(保证结果统计显著——**自动基准评测通常最少 100 个样本**)。
|
||||||
|
|
||||||
|
#### 设计自己的数据集:三条路线
|
||||||
|
|
||||||
|
| 路线 | 要点 |
|
||||||
|
|---|---|
|
||||||
|
| **聚合现有数据(Aggregating existing data)** | 从不同来源聚合现有数据,评估与任务相关的能力。很多评测数据集就是这样从人工评测数据集聚合而来的(如 MATH、LSAT 等)。走这条路同样要执行上面「检查样本」的步骤。 |
|
||||||
|
| **使用人工标注者(Using human annotators)** | 完整章节见 [Using human annotators](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/human-evaluation/using-human-annotators.md)(人工评测章节)。 |
|
||||||
|
| **使用合成数据(Using synthetic data)** | 分两种: |
|
||||||
|
| ├ **用 LLM 生成** | ⭐ 参考 [Cosmopedia](https://huggingface.co/blog/cosmopedia) 博客(HF 同事写的,很酷):主要研究如何造合成*训练*集,但类似技术可用于评测。生成后务必按上面的步骤人工检查/过滤/审查。 |
|
||||||
|
| └ **基于规则的技巧(rule-based)** | 如果任务允许,这是获得**几乎无限样本且避免污染**的好办法。示例:[NPHardEval](https://arxiv.org/abs/2312.14890)、[DyVal](https://arxiv.org/abs/2309.17167)、[MuSR](https://arxiv.org/abs/2310.16049)、[BabiQA](https://arxiv.org/abs/1502.05698) 等。 |
|
||||||
|
|
||||||
|
### 3.2 选择推理方法(inference method)
|
||||||
|
|
||||||
|
#### 基于 log-probabilities(MCQA 多选题)
|
||||||
|
|
||||||
|
非常适合选择题(通常测模型知识、或消歧能力)。
|
||||||
|
|
||||||
|
| 优点 | 缺点 |
|
||||||
|
|---|---|
|
||||||
|
| 确保所有模型都能「看到」正确答案 | 轻微高估小模型(若放任自由生成,它们本会生成选项范围之外的内容) |
|
||||||
|
| 提供模型「置信度」(calibration)的代理 | 有些模型会[根据选项的呈现顺序偏好特定选项](https://arxiv.org/abs/2309.03882),导致评测不具代表性 |
|
||||||
|
| 评估快——尤其只让模型预测一个 token(A/B/C/D 选项序号,或 Yes/No)时 | |
|
||||||
|
| 小模型也能获得任务表现信号 | |
|
||||||
|
|
||||||
|
#### 基于生成(generative / QA 问答)
|
||||||
|
|
||||||
|
适合任何要测流利度(fluency)、推理能力、或模型真正回答问题的能力的任务。
|
||||||
|
|
||||||
|
| 优点 | 缺点 |
|
||||||
|
|---|---|
|
||||||
|
| 应该与 LLM 生成流利文本的能力真实相关,多数时候正是人们真正关心的 | 打分更难(见 3.4 metrics 一节) |
|
||||||
|
| | 通常比 log-likelihood 评测贵一点,尤其包含 sampling 时 |
|
||||||
|
|
||||||
|
### 3.3 选择提示词(prompt)
|
||||||
|
|
||||||
|
prompt 决定:给模型多少任务信息、这些信息如何呈现。
|
||||||
|
|
||||||
|
一个通用 MCQA / QA prompt 通常由以下部分构成:
|
||||||
|
|
||||||
|
- **task prompt**(可选):介绍你的任务;
|
||||||
|
- **context**:为问题提供额外上下文(例:摘要或信息抽取任务可提供内容来源);
|
||||||
|
- **question**:prompt 的核心;
|
||||||
|
- **options**(多选题时):选项;
|
||||||
|
- **连接词(connector words)**:如 `Question`、`Context`、`Choice` 等。
|
||||||
|
|
||||||
|
把这些要素拼成模板(示意,字段顺序与措辞可自行设计):
|
||||||
|
|
||||||
|
```text
|
||||||
|
Task: {task prompt} # 可选:介绍任务
|
||||||
|
Context: {context} # 可选:为问题提供额外上下文(摘要/信息抽取时可给内容来源)
|
||||||
|
Question: {question} # 核心
|
||||||
|
Choice A: {option_a} # 多选题时提供选项
|
||||||
|
Choice B: {option_b}
|
||||||
|
Choice C: {option_c}
|
||||||
|
Answer: # 用连接词引导模型输出
|
||||||
|
```
|
||||||
|
|
||||||
|
> 注意:上面只是结构示意,原文没有给出固定模板——不同模型对格式的敏感度不同,实际使用时按 3.3 的提示设计并验证。
|
||||||
|
|
||||||
|
设计 prompt 时要注意:
|
||||||
|
|
||||||
|
1. **语义等价的微小改动也可能让结果波动很大**(见 [Troubleshooting reproducibility](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/troubleshooting/troubleshooting-reproducibility.md) 的「Different prompt」一节),且 prompt 格式可能利好或利空特定模型。
|
||||||
|
- 缓解方法:
|
||||||
|
- **昂贵方案**:用多种 prompt 变体把评测多跑几遍;
|
||||||
|
- **省钱方案**:只跑一次,但把一批**难度相当的不同 prompt 格式**分配到不同样本上。
|
||||||
|
2. 可以给模型提供**few-shot 示例**帮它遵守期望格式;加连接词也有帮助。
|
||||||
|
3. 但**模型如今倾向于过拟合特定 prompt 格式**:
|
||||||
|
- ⭐ [这篇论文](https://arxiv.org/abs/2407.07890) 讲得很好:有些模型因为过拟合了测试集的**格式(format)**而被高估。
|
||||||
|
- 在 Open LLM Leaderboard 2 上,作者观察到 Llama 3.2 和 Qwen 2.5 出于这个原因,在 few-shot 设置下不再遵循给定 prompt 的格式。
|
||||||
|
4. 对不少 metric 来说,你需要**高度受约束的生成/输出**(详见 [Model inference and evaluation](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/general-knowledge/model-inference-and-evaluation.md) 的 `Constraining model outputs` 一节)。
|
||||||
|
|
||||||
|
### 3.4 选择度量(metric)
|
||||||
|
|
||||||
|
**基于 log-probabilities** 时,metric 很简单:看 **accuracy**(最可能的选项是最佳选项的频率)。重要:要**按长度归一化**(按字符 character、token、或 pmi)。也可以看 perplexity、recall、f1。
|
||||||
|
|
||||||
|
**生成式评测(generative)** 时可选 metric 范围更广,需要两步决策:
|
||||||
|
|
||||||
|
1. **比较生成结果前是否先归一化(normalize)?**
|
||||||
|
- 归一化设计得不好时[很容易不公平](https://huggingface.co/blog/open-llm-leaderboard-drop),但总体上在任务层面仍提供信号;
|
||||||
|
- 对特定任务非常重要,如数学评测:你可能要从格式化输出中抽取结果;
|
||||||
|
- 如果要叠加 Chain of Thought 等机制测准确率,也要归一化——你需要把推理痕迹(reasoning trace)从实际结果中剥离。
|
||||||
|
2. **如何把生成与参考做比较?**
|
||||||
|
- 从基于匹配的 metric(exact match、prefix match 等)到摘要/翻译类 metric(ROUGE、BLEU、character n-gram 比较)都可以;
|
||||||
|
- 现有 metric 列表见 ⭐ [lighteval 的 Metric List wiki](https://github.com/huggingface/lighteval/wiki/Metric-List)(作者表示之后会补「何时用哪个 metric」一节)。
|
||||||
|
|
||||||
|
**更一般的原则**:选 metric 时要想清楚任务真正关心什么。有些领域(如医疗、有公共交互的聊天机器人)不该测平均表现,而要能评估**最差表现(worst performance)**——如医疗输出质量、毒性等。(延伸阅读:⭐ [这个博客](https://ehudreiter.com/2024/07/10/challenges-in-evaluating-llms/))
|
||||||
|
|
||||||
|
### 3.5 智能新任务:功能测试(functional testing)
|
||||||
|
|
||||||
|
代码领域:不仅要按语义评估生成的程序,还要按**实际功能**评估。好办法是检查「为遵循 prompt 而生成的代码」能否通过**一套为该任务设计的单元测试(unit tests)**。
|
||||||
|
|
||||||
|
功能化方法极具前景,因为:
|
||||||
|
|
||||||
|
- 更容易生成测试用例(很多情况下可用基于规则的方法生成 test cases);
|
||||||
|
- 因此**降低过拟合(overfitting)**;
|
||||||
|
- 测的是模型的具体**主动能力(active capabilities)**。
|
||||||
|
|
||||||
|
不过,要把这种方法**迁移到文本任务需要创造力**!
|
||||||
|
|
||||||
|
- 一个优秀范例是 **IFEval**:测试模型能否遵循指令的评测 benchmark。它创建一批格式化指令(*Add this number of bullet points.*、*Capitalize only one sentence.* 等),严格检查格式是否被遵循。
|
||||||
|
- 作者认为:要把这个思路扩展到文本的其他特性,还需要更多工作。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 4. 常用评测数据集盘点
|
||||||
|
|
||||||
|
如果你关心的任务已被充分研究,大概率已有现成数据集。下面是作者近几年整理的评测数据集清单。
|
||||||
|
|
||||||
|
⚠️ 两点提醒:
|
||||||
|
|
||||||
|
- **部分数据集可能已过时**:它们是 pre-LLM 时代设计的,如今已被轻松解决;当初旨在探究文本的某一具体属性(翻译、摘要),已不再是现在的评测方式(评测如今更通用/整体化)。
|
||||||
|
- **它们很可能已被污染**:已在网上公开多年。但被污染不代表对你的任务没有信号。
|
||||||
|
|
||||||
|
> 注:原文标注「✍️」的是作者提出、可自行复现的数据集想法(见 4.3)。部分行原文信息为空,笔记中保留名称并注明「原文未提供细节」。
|
||||||
|
|
||||||
|
#### 如何从盘点表中选数据集(作者备注提炼)
|
||||||
|
|
||||||
|
表格的「备注」列里藏着作者的选数据集经验,常用判断依据有:
|
||||||
|
|
||||||
|
- **看创建者与标注流程**:专家标注(如 FinQA 的付费专家+外部专家高一致)通常质量更高;自动抽取比例高、人工验证少的数据集要警惕(如 Dolphin18K、Math23K)。
|
||||||
|
- **看模板化程度**:模板化/可再生成的数据集对**研究 contamination 特别有用**(Ape210K 部分模板化、Draw-1K 每题带模板标签、GSM-Symbolic、NPHardEval、DeepMind Math 可再生成)。
|
||||||
|
- **看是否附带训练集**:凡提供额外 train set 或「本意部分用于训练」的(Ape210K、AQuA、DocMath-Eval、DeepMind Math、NuminaMATH),若拿去当训练数据会**反向污染主流数学 benchmark**(NuminaMATH 的备注直接警告了这一点)。
|
||||||
|
- **看答案形式是否可自动验证**:整数(AIME、GSM8K)、SymPy 对象(FrontierMath、OlympiadBench)、单元测试(HumanEval、APPS)——答案可自动验证是生成式评测能跑起来的关键。
|
||||||
|
- **看语言/时区属性**:中文题(Ape210K、GAOKAO-Bench、HMWP、Math23K)、多语言(MLSum、TyDiQA-GoldP)、是否每年更新(GAOKAO-Bench)。
|
||||||
|
- **看是否有领域专家背书**:FrontierMath(60 位数学家、全部同行评审)被作者评为「目前可能质量最高」;GAOKAO-Bench 的论文「数据集信息意外地少」。
|
||||||
|
|
||||||
|
### 4.1 数学类数据集(Math specific)
|
||||||
|
|
||||||
|
| 名称 | 类型 | 年份 | 规模 | 内容/备注 | 链接 |
|
||||||
|
|---|---|---|---|---|---|
|
||||||
|
| AGIEval (SATMath) | 考试题+现有数据集 | 2023 | 220 | SAT 数学题。论文实为一系列人类考试数据集汇编:数学部分经 MATH 用了 AIME & AMC,经 AQuA-Rat 用了 GRE & GMAT,另有 GaoKao。Metric:acc/em/f1 | [Paper](https://arxiv.org/abs/2304.06364) / [HF](https://huggingface.co/datasets/hails/agieval-sat-math) |
|
||||||
|
| AIME (all) | 奥赛题 | 1983–今 | 每年 15×2 | 需要算术、代数、计数、几何、数论、概率等中学数学综合的问题。美国 IMO 代表队选拔第 2 场考试。答案恒为 0–999 的整数 | [Blog](https://artofproblemsolving.com/wiki/index.php/American_Invitational_Mathematics_Examination) / [Source](https://artofproblemsolving.com/wiki/index.php/AIME_Problems_and_Solutions) |
|
||||||
|
| AIME (22/23/24) | 奥赛题 | 2024 | 90 | 同 AIME (all),用于 AIMO 竞赛 | [HF](https://huggingface.co/datasets/AI-MO/aimo-validation-aime) |
|
||||||
|
| ALGES (SingleEQ) | 网络来源汇编 | 2015 | 508 | 从网络抓取的年级代数题。论文主题:隐式学习并求解题目背后的简单方程。来源:math-aids.com、k5learning.com、ixl.com。pre-LLM 论文,数据源可能没问题 | [Paper](https://aclanthology.org/Q15-1042/) / [Source](https://gitlab.cs.washington.edu/ALGES/TACL2015/-/blob/master/questions.json?ref_type=heads) |
|
||||||
|
| ALG514 / AllEq | 网络论坛 | 2014 | 514 | 从众包辅导网站抽取、turking 清理、人工核验的代数应用题。论文主题:从问题中抽取方程模板来求解。来源:Algebra.com | [Paper](https://aclanthology.org/P14-1026/) / [Source](https://groups.csail.mit.edu/rbg/code/wordprobs/questions.json) |
|
||||||
|
| AMC 12 | 奥赛题 | 2000–今 | 每年 25 | 应用题(算术、代数、计数、几何、数论、概率等)。美国 IMO 选拔第 1 场考试(前身 American High School Math Exam)。题目设计为无需微积分背景即可解 | [Blog](https://artofproblemsolving.com/wiki/index.php/AMC_12) / [Source](https://artofproblemsolving.com/wiki/index.php/AMC_12_Problems_and_Solutions) |
|
||||||
|
| Ape210K | 考试题 | 2020 | 21 万题 / 5.6 万模板 | 中文小学数学应用题(数学教师编写)。部分题目模板化(对 contamination 研究有用);原始 90 万经人工筛选;提供「中间方程」(测 CoT trace 有用);本意部分用于训练 | [Paper](https://arxiv.org/abs/2009.11506)(已撤回,v1 仍可访问)/ [HF](https://huggingface.co/datasets/MU-NLPC/Calc-ape210k) |
|
||||||
|
| AQuA / AQUA-Rat | 考试题+turk 数据集 | 2017 | 100K | 以 3.4 万 GMAT/GRE 题为种子、turking 扩展的代数应用题。含 rationale;评分用 accuracy、BLEU、perplexity;本意部分用于训练 | [Paper](https://arxiv.org/abs/1705.04146) / [HF](https://huggingface.co/datasets/deepmind/aqua_rat) |
|
||||||
|
| ASDiv-A | 网络来源汇编 | 2020 | 2.3K | 从各网站收集并规范化的应用题。硕士生标注问题类型与年级;强调词汇多样性;用了 28 个网站 | [Paper](https://aclanthology.org/2020.acl-main.92/) / [Github](https://github.com/chaochun/nlu-asdiv-dataset) |
|
||||||
|
| CHAMP | 奥赛题 | 2024 | 270 | 从奥赛例题书抽取、改写为可解析解并标注的应用题。题目带 hints 与概念标签,可做消融实验。来源:《Problem-Solving strategies》(Engel, 2008) | [Paper](https://arxiv.org/abs/2406.18321) |
|
||||||
|
| DeepMind Math | 考试题+合成 | 2019 | 10K? | 代数、算术、微积分、比较、单位换算、多项式、概率等合成数学题。领域完整列表在附录 B;提供生成代码可产出更多样例;提供额外训练集;程序化合成 | [Paper](https://arxiv.org/abs/1904.01557) / [HF](https://huggingface.co/datasets/deepmind/math_dataset) |
|
||||||
|
| DocMath-Eval | 人工标注财报+现有金融数学集 | 2023 | 3.2K | 结合财报与现有数据集,标注者读材料出题(或校验),答案以 Python 程序给出、由领域专家评估。复用 TAT-QA、FinQA、MultiHiertt、TAT-HQA;金融数学数据质量看起来很高;提供额外训练集 | [Paper](https://arxiv.org/abs/2311.09805) / [Github](https://github.com/yale-nlp/docmath-eval) |
|
||||||
|
| Dolphin1878 | 网络来源汇编 | 2015 | 1.5K | 从在线来源抽样、必要时重新标注的数字应用题。论文主题:用语义解析从问题中提取 DOL 方程树。来源:algebra.com、answers.yahoo.com | [Paper](https://aclanthology.org/D15-1135.pdf) |
|
||||||
|
| Dolphin18K | 网络来源汇编 | 2016 | 18K | 半自动从在线来源抽取的应用题。来源:Yahoo Answers 数学分类(2008 起)。先人工标注 6K 再用分类器扩展;自动抽取比例高、人工验证少,作者对质量存疑 | [Paper](https://aclanthology.org/P16-1084.pdf) / [Kaggle](https://www.kaggle.com/datasets/saurabhshahane/sigmadolphin) |
|
||||||
|
| Draw-1K | 网络来源汇编 | 2016 | 1K | 从在线来源抽取的通用代数应用题。论文主题:评估求解器、测试模板与方程等价。每题标注其模板(对 contamination 有用)。来源:algebra.com | [Paper](https://arxiv.org/abs/1609.07197) / [Source](https://www.microsoft.com/en-us/download/details.aspx?id=52628) |
|
||||||
|
| FinQA | 专家标注财报 | 2021 | 1.1K | 与财报表格关联的金融问题;标注者给出问题+逐步过程+每页注解。付费专家标注+外部专家一致性高,质量可能很高;全集 8.2K;数据源 S&P 500 财报(1999–2019) | [Paper](https://arxiv.org/abs/2109.00122) / [HF](https://huggingface.co/datasets/ibm/finqa) |
|
||||||
|
| FrontierMath | 专家创建 | 2024 | 100+(确切数字未知) | 全新建、覆盖多数数学领域的难题;答案要么是整数要么是 SymPy 对象,可通过类单元测试的 Python 程序自动验证;题目带标签。60 位数学家、12 个国家;全部同行评审;论文有很好的 contamination 讨论;目前可能是质量最高的数据集。数据不公开——但闭源模型已被评测过,未来很可能被污染 | [Paper](https://arxiv.org/abs/2411.04872)(数据私有) |
|
||||||
|
| GAOKAO-Bench (MathCloze, MathQA) | 考试题 | 2023 | ~500 | 中国高考数学应用题。公式转 latex;中文;每年更新;论文探索多种评分方式(含 LLM as judge);论文里数据集信息意外地少 | [Paper](https://arxiv.org/abs/2305.12474) / [Github](https://github.com/OpenLMLab/GAOKAO-Bench?tab=readme-ov-file) / [HF MathCloze](https://huggingface.co/datasets/hails/agieval-gaokao-mathcloze) / [HF MathQA](https://huggingface.co/datasets/hails/agieval-gaokao-mathqa) |
|
||||||
|
| GAOKAO 2023 (MathEn) | 考试/竞赛题 | 2023 | 385 | 高中数学应用题。汇编 2023 中国高考、2023 AMC、2023 ACT | [HF](https://huggingface.co/datasets/MARIO-Math-Reasoning/Gaokao2023-Math-En) |
|
||||||
|
| GSM1K | 按另一数据集风格手工创建 | 2024 | 1.2K | 多样化的「grade school」风格应用题,遵循 GSM8K 的求解分布。论文做 GSM8K vs GSM1K 的 contamination 分析;并暗示 perplexity 分析不太擅长检测 contamination | [Paper](https://arxiv.org/abs/2405.00332)(数据私有) |
|
||||||
|
| GSM8K | 按考试风格手工创建 | 2021 | 8.5K | 多样化年级数学应用题。加外部计算器效果最好;答案均为正整数,50% 在 0–8 之间;先用 Upwork 标 1K、后用 Scale;出题者拿到 175B GPT-3 的种子题 | [Paper](https://arxiv.org/abs/2110.14168v2) / [Github](https://github.com/openai/grade-school-math) / [HF](https://huggingface.co/datasets/gsm8k) |
|
||||||
|
| iGSM (med/hard) | 合成 | 2024 | 20K | 用「对象/类别间依赖图(直接/隐式)+ 运算次数」组合生成题目。想法理论上不错但问题很不真实(运算次数过多);论文聚焦模型「心智过程」,拟人化过重;probing 部分不错 | [Paper](https://arxiv.org/pdf/2407.20311) / [HF](https://huggingface.co/datasets/YangZhoumill/infini_igsm_4k_noise_close) |
|
||||||
|
| GSMHard | 现有数据集改编(换数字) | 2022 | 8.5K | GSM8K 换更大/更少见数字以变难;但替换由程序自动完成,只人工检查了 25 处变更(另 50 例手工做)。想法不错但质量存疑(附录 H1) | [Paper](https://arxiv.org/abs/2211.10435) / [HF](https://huggingface.co/datasets/reasoning-machines/gsm-hard) |
|
||||||
|
| GSM-IC | 现有数据集扰动 | 2023 | 58K | GSM8K 抽 100 题加无关上下文(模板化无关句 + 角色/数字填充)。测 LLM 在数学推理时对无关上下文的敏感度 | [Paper](https://arxiv.org/abs/2302.00093) / [HF](https://huggingface.co/datasets/voidful/GSM-IC) |
|
||||||
|
| GSM-Plus | 现有数据集扰动 | 2024 | 10K | GSM8K 每题 8 种变体,GPT-4 生成、人工标注(校验交叉标注一致性)。变体:换数字、换运算、换问题、加干扰项等——作者认为这套变更类型学不错、可扩展 | [Paper](https://aclanthology.org/2024.acl-long.163/) / [HF](https://huggingface.co/datasets/qintongli/GSM-Plus) |
|
||||||
|
| GSM-Symbolic | 现有数据集模板化 | 2024 | 8.5K | GSM8K 模板化,可随时生成新评测、分析 GSM8K 上的 contamination。含子集(M1/P1/P2 难度等级、NoOp 加看似相关实则无关信息),部分实验用 few-shot;作者认为缺少子集说明表 | [Paper](https://arxiv.org/abs/2410.05229)(待发布) |
|
||||||
|
| Hungarian HighSchool Finals | 考试题 | 2023 | 33 | 2023 匈牙利高中数学会考题目。目前需手工评分 | [Source](https://dload-oktatas.educatio.hu/erettsegi/feladatok_2023tavasz_kozep/k_matang_23maj_fl.pdf) / [HF](https://huggingface.co/datasets/keirp/hungarian_national_hs_finals_exam) |
|
||||||
|
| HMWP | 考试题 | 2020 | 5.4K | 中国 K-12 题库标注的应用题。提出统一表示 MWP 方程的形式体系;中文 | [Paper](https://arxiv.org/abs/2010.06823) / [HF](https://huggingface.co/datasets/Gxg/HWMP) |
|
||||||
|
| Math23K | 网络来源汇编 | 2017 | 23K | 自动抽取的小学数学应用题。中文;来自在线教育网站;基于规则抽取,人工校验程度不明 | [Paper](https://aclanthology.org/D17-1088/) / [HF](https://huggingface.co/datasets/Gxg/Math23K) |
|
||||||
|
| Math401-LLM | 合成 | 2023 | 401 | 加/减/乘/幂/对数等算术表达式。论文想测严格算术能力;模型目前对 log/trig 或大数表现不佳 | [Paper](https://arxiv.org/abs/2304.02015) / [Github](https://github.com/GanjinZero/math401-llm) |
|
||||||
|
| MATH | 奥赛题 | 2021 | 12.5K | 真实竞赛题(自然语言+latex),带难度标注。来源 AMC 10/12、AOME 等;另引入从 Khan Academy 与 AMPS 抓取的训练集 | [Paper](https://arxiv.org/abs/2103.03874) / [HF](https://huggingface.co/datasets/lighteval/MATH) |
|
||||||
|
| MathOdyssey | — | — | — | 原文未提供细节 | — |
|
||||||
|
| MathQA | 现有数据集改编+标注 | 2019 | 37K | 对 AQuA 中可解题目加形式化标注程序(人工标注并测一致性)。提出数学问题表示语言并应用于 AQuA | [Paper](https://arxiv.org/abs/1905.13319) / [HF](https://huggingface.co/datasets/allenai/math_qa) |
|
||||||
|
| MAWPS | 现有数据集汇编 | 2016 | 3.3K | 来自现有数据集的应用题。提出创建新数学题的框架,注意去除词法/模板重叠;来源 ALG514、ALGES 等 pre-LLM 数据集 | [Paper](https://aclanthology.org/N16-1136/) / [Github](https://github.com/sroy9/mawps) |
|
||||||
|
| MiniF2F | 奥赛题 | 2022 | 244 | 奥赛应用题,尽可能用定理证明器形式化(Lean、Metamath、Isabelle)。测数学证明求解器的形式逻辑推理;来源 AIME、AMC、IMO | [Paper](https://arxiv.org/abs/2109.00110) / [HF](https://huggingface.co/datasets/cat-searcher/minif2f-lean4) |
|
||||||
|
| NPHardEval | 合成 | 2023 | 900 | 由合成图/线性数据构造、难度各异的问题。类型:排序数组搜索、编辑距离、最短路、旅行商、图着色、背包、会议调度;可按需重新生成 | [Paper](https://arxiv.org/abs/2312.14890) / [Github](https://github.com/casmlab/NPHardEval) |
|
||||||
|
| NuminaMATH CoT | 现有数据集汇编 | 2024 | 860K | K-12 + 奥赛级应用题(组合现有数据集)。来源 AOPS、AMC、AIME、CN-K12、GSM8K、MATH、ORCA_math、合成 AMC/MATH 等。⚠️ 若当训练集会污染所有主流数学 benchmark | [HF](https://huggingface.co/datasets/AI-MO/NuminaMath-CoT) |
|
||||||
|
| NuminaMATH TiR | 现有数据集汇编 | 2024 | 72K | NuminaMATH CoT 中可用工具集成推理(tool integrated reasoning)解决的子集。同样 ⚠️ 当训练集有污染风险 | [HF](https://huggingface.co/datasets/AI-MO/NuminaMath-TiR) |
|
||||||
|
| OmniMath | 奥赛题 | 2024 | 2.2K | 从论坛/奥赛网站抽取(规则+LLM 改写)、人工标注验证的奥赛题。来源 IMO、IMC、AoPS 论坛与 wiki;领域标注用 LLM;配套训练了 judge 评估自由形式答案 | [Paper](https://arxiv.org/abs/2410.07985) / [HF](https://huggingface.co/datasets/KbsdJames/Omni-MATH) |
|
||||||
|
| OlympiadBench | 奥赛题 | 2024 | 8.4K | 奥赛/数学/物理应用题;答案自动评估(数字或方程,用 SymPy)。来源全球数学/物理奥赛、中国地区/国家级数学竞赛、高考模拟;含物理子集;支持 VLM 评测 | [Paper](https://arxiv.org/pdf/2402.14008) |
|
||||||
|
| OlympicArena | 奥赛题 | 2024 | 11K | 原文未提供内容细节 | [Paper](https://arxiv.org/pdf/2406.12753) |
|
||||||
|
| PRM800K | 合成 | 2023 | 800K | 标注者对模型生成的 80 万解做的偏好数据。论文提出 process supervision 改进 reward model(对比 output vs process supervision)。更多是训练集而非评测集 | [Paper](https://arxiv.org/abs/2305.20050) / [HF](https://huggingface.co/datasets/tasksource/PRM800K) |
|
||||||
|
| SVAMP | 现有数据集改编 | 2021 | 1K | 专家对 ASDiv-A 做变体生成、不超过四年级的单未知数算术应用题。变体:同对象不同结构、两者皆变、加相关/无关信息、改信息、反转运算、改句子/对象顺序 | [Paper](https://aclanthology.org/2021.naacl-main.168/) / [Github](https://github.com/arkilpatel/SVAMP/blob/main/SVAMP.json) |
|
||||||
|
| TabMWP | 在线来源改编 | 2022 | 38K | 需多跳推理的表格应用题,抽取自在线教育网站并人工标注。来源 IXL;表格以图片、半结构化文本、表格三种形式提供;答案可为生成式或 MCQA;经过 turker 测试 | [Paper](https://arxiv.org/abs/2209.14610) / [HF](https://huggingface.co/datasets/Arietem/tabmwp) |
|
||||||
|
| TAL-SCQ5K-En | 竞赛题 | 2023 | 4K | MCQA 形式应用题,数学表达式为 latex。含中英文;另有 6K 训练样本和 CoT | [HF](https://huggingface.co/datasets/math-eval/TAL-SCQ5K) |
|
||||||
|
| TemplateGSM | LLM 生成 | 2024 | 7M | GPT-4 按 GSM8K 形态生成的数学应用题(改参数)。用 GPT-4 生成 meta-template,验证器确保可用。全部 LLM 生成,作者期待更强的质量证明 | [Paper](https://templatemath.github.io/TemplateMath_Part_I.pdf) / [HF](https://huggingface.co/datasets/math-ai/TemplateGSM) |
|
||||||
|
| TheoremQA | 在线来源改编 | 2023 | 800 | 大学级别定理的 QA。流程:GPT-4 枚举相关领域子领域 → 定理候选列表 → 领域专家核实 → 网上找相关 QA | [Paper](https://arxiv.org/abs/2305.12524) / [HF](https://huggingface.co/datasets/TIGER-Lab/TheoremQA) |
|
||||||
|
|
||||||
|
### 4.2 Pre-LLM 数据集
|
||||||
|
|
||||||
|
> 多为翻译、摘要、推理、常识等「单属性」任务,现已较易解决;不少已被污染,但可能仍有信号。
|
||||||
|
|
||||||
|
| 名称 | 任务类型 | 数据规模/内容 | 任务 | 备注 | 链接 |
|
||||||
|
|---|---|---|---|---|---|
|
||||||
|
| DeepFix | Code task, Code-to-code, 纠错 | 7K 学生写的错误 C 程序 | 修正 C 程序 | | [Paper](https://ojs.aaai.org/index.php/AAAI/article/view/10742) |
|
||||||
|
| MLSum | 生成、多语言、摘要 | 1.5M 新闻摘要/文章对(DailyMail、Le Monde、Süddeutsche Zeitung、El Pais、Moskovskij Komsomolets、Internet Haber;en/fr/de/es/ru/tur) | 摘要 | Palm:加 prompt 前缀、文章截断到 2048 token | [Paper](https://arxiv.org/abs/2004.14900) / [HF](https://huggingface.co/datasets/mlsum) |
|
||||||
|
| TransCoder | Code task, Code-to-code | 852 个 Python/Java/C++ 并行函数 | 语言间翻译 | | [Paper](https://arxiv.org/pdf/2006.03511.pdf) / [Github](https://github.com/facebookresearch/CodeGen/blob/main/docs/transcoder.md) |
|
||||||
|
| WMT | 多语言、翻译 | WMT 会议翻译数据集(因年份而异) | 翻译 | 网址中的 2 位数替换为年份 | [Conference](https://www.statmt.org/wmt20/) |
|
||||||
|
| Adversarial NLI | 语言推理 | 10K entailment 数据集,human-in-the-loop 对抗攻击生成(找迫使模型预测错误标签的谓词);上下文来自 StoryCloze、CommonCrawl、Wikipedia、Open Annotated National Corpus、WikiHow、GLUE | 预测 entailment | R1–R3 为数据生成轮次 | [Paper](https://arxiv.org/abs/1910.14599) / [Data](https://dl.fbaipublicfiles.com/anli/anli_v1.0.zip) / [Github](https://github.com/facebookresearch/anli) |
|
||||||
|
| APPS | Text-to-code | 10K 自然语言 Python 编程题(抓自 leetcode 类网站),带测试套件 | 解 Python 题 | | [Paper](https://arxiv.org/abs/2105.09938) / [Github](https://github.com/hendrycks/apps) / [Data](https://people.eecs.berkeley.edu/~hendrycks/APPS.tar.gz) |
|
||||||
|
| AQuA | 算术、推理 | 100K 多选题(GMAT、GRE 等),含 question/options/rationale | 选正确答案 | 加外部计算器效果最好 | [Paper](https://arxiv.org/abs/1705.04146) / [Github](https://github.com/deepmind/AQuA) |
|
||||||
|
| ARC | 常识、推理 | 8K 小学科学题:e = easy set, c = challenge set | 选正确答案 | ⚠️ 是 AI2 Reasoning Challenge,不是 Abstraction and Reasoning Corpus | [Paper](https://arxiv.org/abs/1803.05457) / [Data](https://allenai.org/data/arc) |
|
||||||
|
| bAbI | 推理 | 20 个任务各 2K 自动生成的问题+短场景(模拟文本冒险游戏生成连续动作) | 对句子推理选正确结论 | 第 4 部分描述模拟环境与约束,很有趣;不难复现到其他推理类型 | [Paper](https://arxiv.org/abs/1502.05698) / [Github](https://github.com/facebookarchive/bAbI-tasks) / [Data](https://research.facebook.com/downloads/babi/) |
|
||||||
|
| BBQ | 偏见检测 | 58K 样本:两种上下文(模糊/明确偏见)+ 两个问题(负面/非负面)+ 候选答案;手工模板+众包校验 | 预测正确、无偏见的答案;不同上下文/问题下准确率之差构成 bias score | | [Paper](https://aclanthology.org/2022.findings-acl.165/) / [Github](https://github.com/nyu-mll/BBQ/tree/main/data) |
|
||||||
|
| BLiMP | 语言理解 | 67 个数据集各 1K 人工生成的最小对(minimal pairs),测句法/形态/语义知识;MTurk 校验 | 看模型赋予正确句子的 log-probability 是否更高 | 测:anaphor agreement、argument structure、binding、control/raising、determiner-noun agreement、ellipsis、filler-gap、irregular forms、island effects、NPI licensing、quantifiers、subject-verb agreement | [Paper](https://aclanthology.org/2020.tacl-1.25/) / [Github](https://github.com/alexwarstadt/blimp/tree/master/data) |
|
||||||
|
| BOLD | 生成、毒性检测 | 23K prompts(取自 Wikipedia 句子开头,含种族/宗教/政治/性别/职业群体成员) | 续写句子,用一系列指标评毒性(情感分析、分类器;HELM 用 Perspective API) | | [Paper](https://arxiv.org/abs/2101.11718) / [Github](https://github.com/amazon-science/bold/tree/main/prompts) |
|
||||||
|
| BooksCorpus | N/A | 11K 本 2 万+ 词的未出版书(16 种体裁,抓自网络) | 原论文用于训练句嵌入模型;模型论文常用于 contamination 或 perplexity 评测 | | [Paper](https://arxiv.org/pdf/1506.06724.pdf) / [HF](https://huggingface.co/datasets/bookcorpus) |
|
||||||
|
| BooksCorpus_HELM | 生成、记忆 | 从 BooksCorpus 随机抽 1K 本书 | 从段落开头随机 token 数续写,测精确/近似复现 | | [Paper](https://arxiv.org/abs/2211.09110) / [Data](https://drive.google.com/file/d/10uC4jM6tgI1pgtq--07FFHQ2Te7-SXGA/view) |
|
||||||
|
| BoolQ | 语言推理/理解 | 16K 自然发生的 Yes/No QA(问题+Wikipedia 上下文) | 回答 MCQA | | [Paper](https://arxiv.org/abs/1905.10044) / [Website](https://super.gluebenchmark.com/tasks) |
|
||||||
|
| CB | 语言理解 | 1.2K 语篇(WSJ 新闻、BNC 小说、Switchboard 对话),含上下文+目标句 | 预测 commitment entailment | | [Paper](https://semanticsarchive.net/Archive/Tg3ZGI2M/Marneffe.pdf) / [Website](https://super.gluebenchmark.com/tasks) |
|
||||||
|
| Civil comments | 毒性检测 | 1.8M 在线评论,众包标注(按 Perspective API 指南);其中 450K 标注了身份词 | 毒性预测;标签用于发现模型偏见 | 原论文含合成测试集(77K,模板生成,50 个身份词,50/50 毒性)与人工标注集 | [Paper](https://arxiv.org/pdf/1903.04561.pdf) / [Kaggle](https://www.kaggle.com/c/jigsaw-unintended-bias-in-toxicity-classification) / [HF](https://huggingface.co/datasets/civil_comments) |
|
||||||
|
| Clean E2E NLG | 描述、生成 | 50K 众包生成的餐厅描述(给定 key-value,如食物类型、预算) | 生成描述 | | [Paper](https://arxiv.org/abs/1706.09254) / [HF](https://huggingface.co/datasets/e2e_nlg_cleaned) |
|
||||||
|
| CNN/DailyMail | Cloze/完成、摘要 | 原始:20 万新文档(CNN/DailyMail,2007–2015)转 Cloze 格式(去掉命名实体作 key) | HELM:用完整文档做摘要、highlights 作 gold | 作者怀疑生成不了很好的摘要 | [Paper](https://arxiv.org/pdf/1506.03340.pdf) / [HF](https://huggingface.co/datasets/cnn_dailymail) / [Data](https://cs.nyu.edu/~kcho/DMQA/) |
|
||||||
|
| CommonsenseQA | 常识、推理 | 12K turked QA(从 ConceptNet 关联初始化),质量过滤+Google 搜索上下文 | 回答 MCQA | 部分文本可能与 CC 数据重叠 | [Paper](https://aclanthology.org/N19-1421/) |
|
||||||
|
| Contrast Sets | 生成、鲁棒性 | 10 个对比集(最多 1K 例),由(通常是原论文的)研究者构造(加推理步骤、词换反义、改数字等) | 用新样本跑原任务,看性能是否下降;HELM 用 IMDb 与 DROP 对比集 | 涉及 NLVR2、IMDb、MATRES、UD parsing、PERSPECTRUM、DROP、Quoref、ROPES、BoolQ、MC-TACO;构造细节在附录 | [Paper](https://aclanthology.org/2020.findings-emnlp.117/) / [Data](https://allenai.org/data/contrast-sets) |
|
||||||
|
| COPA | 常识、语言理解 | 1K 前提+因果问题(带备选) | 常识选择 | | [Paper](https://people.ict.usc.edu/~gordon/publications/AAAI-SPRING11A.PDF) / [Website](https://super.gluebenchmark.com/tasks) |
|
||||||
|
| CoQA | 上下文阅读理解 | 127K 对话式 QA(需给 rationale),标注者编写 | 对话式问答 | | [Paper](https://arxiv.org/abs/1808.07042) / [Data](https://stanfordnlp.github.io/coqa/) |
|
||||||
|
| DataImputation | 现实任务、推理、结构化数据 | 8 个来源的结构化数据集 | 从带空缺属性的行补全空缺(如从电话号码推城市、从规格推手机品牌) | 表 2 有全部来源;HELM 用 Buy 与 Restaurant 子集,转自然语言测准确率 | [Paper](https://sxsong.github.io/doc/21icde-imputation.pdf) / [Data restaurant](https://www.cs.utexas.edu/users/ml/riddle/data/restaurant.tar.gz) / [Data Buy](https://dbs.uni-leipzig.de/file/Abt-Buy.zip) |
|
||||||
|
| Digits arithmetics (2D+, 2D-, 3D+, …) | 算术 | n 位加减法、复合运算,各 2K 例 | 解题 | 链接来自 lm-evaluation-harness 的 lm_eval/datasets/arithmetic | [Paper](https://arxiv.org/pdf/2005.14165.pdf) / [Github](https://raw.githubusercontent.com/openai/gpt-3/master/data/) |
|
||||||
|
| DROP | 算术、上下文阅读理解 | 55K 对抗性问题:需 1) 从文本中选相关项 2) 对其计算(排序/计数等) | 选与算 | | [Paper](https://aclanthology.org/N19-1246/) / [Data](https://allenai.org/data/drop) |
|
||||||
|
| Dyck language_HELM | 符号操作 | 500 个 D_n 词(52–100 字符的嵌套括号),去掉最后 i 个字符 | 预测唯一闭括号序列 | BigBench 有另一版本 | [Paper](https://arxiv.org/abs/2211.09110) / [Github](https://github.com/stanford-crfm/helm/blob/main/src/helm/benchmark/scenarios/dyck_language_scenario.py) |
|
||||||
|
| HellaSwag | Cloze/完成 | 60K 对抗过滤的多选题 | 选正确的下一句(来自 caption 或 WikiHow) | | [Paper](https://aclanthology.org/P19-1472/) / [Github](https://github.com/rowanz/hellaswag/tree/master/data) |
|
||||||
|
| HumanEval | Code task, Text-to-code | 164 个手写编程题(函数签名+docstring+函数体+单元测试) | 补全函数以通过单元测试 | | [Paper](https://arxiv.org/abs/2107.03374) / [HF](https://huggingface.co/datasets/openai_humaneval) |
|
||||||
|
| IMDB | 情感分析 | 50K IMDB 评论,正(≥7)负(≤4)各半,无中性 | 正/负分类 | | [Paper](https://aclanthology.org/P11-1015/) / [Website](https://ai.stanford.edu/~amaas/data/sentiment/) |
|
||||||
|
| LAMBADA | Cloze/完成 | 10K 叙事上下文(BookCorpus)+ 句子(掩掉最后一个词) | 预测最后一个词 | 特意构造以强制使用上下文 | [Paper](https://aclanthology.org/P16-1144/) / [Zenodo](https://zenodo.org/record/2630551#.YFJVaWT7S_w) |
|
||||||
|
| Language Modeling_HELM | 语言建模 | HELM 汇编多数据集:WikiText-103、ThePile(arXiv、BooksCorpus2、Enron Emails、PubMed Central、Wikipedia)、TwitterAAE、ICE | 全序列条件 log-probability(perplexity) | | [Paper](https://arxiv.org/abs/2211.09110) / [The pile](https://pile.eleuther.ai/) / [Wikitext](https://s3.amazonaws.com/research.metamind.io/wikitext/wikitext-103-raw-v1.zip) / [Twitter AAE](http://slanglab.cs.umass.edu/TwitterAAE/) / [ICE](https://www.ice-corpora.uzh.ch/en/access.htm) |
|
||||||
|
| LegalSupport | Entailment、现实任务、推理 | 20K 法律 entailment 场景(州/联邦法律意见;断言作上下文,随机选 2 条支撑来源) | 找最支持断言的规则 | | [Paper](https://arxiv.org/abs/2211.09110) / [Data](https://docs.google.com/uc?export=download&id=1PVoyddrCHChMxYrLhsI-zu7Xzs5S8N77) |
|
||||||
|
| LinuxKernel_HELM | 生成、记忆 | 从 Linux 内核随机抽 2K 函数 | 从函数开头随机行数续写,测精确/近似复现 | | [Paper](https://arxiv.org/abs/2211.09110) / [Data](https://drive.google.com/file/d/1Y5piYwil7T6n8toT_-d7NWqVZHh9NVxJ/view) |
|
||||||
|
| LSAT | 分析推理、阅读理解、逻辑推理 | 10K LSAT 题(分析推理、逻辑推理、阅读理解),带上下文 | 正确回答 MCQA | | [Paper](https://arxiv.org/pdf/2108.00648.pdf) / [Github](https://github.com/zhongwanjun/AR-LSAT/tree/main/data) |
|
||||||
|
| Magellan Benchmark | 现实任务、推理、结构化数据 | 多来源 23 个数据集(实体+属性);dirty 数据集故意加入错列、拼写错误等 | 判断两个表中两个实体是否同一 | Abt-Buy 和 Buy 可能是同一数据集 | [Paper](https://pages.cs.wisc.edu/~anhai/papers1/deepmatcher-sigmod18.pdf) / [Github](https://github.com/anhaidgroup/deepmatcher/blob/master/Datasets.md) |
|
||||||
|
| MBPP | Code task, Text-to-code | 1K 入门级 Python 众包编程题(描述、解答、3 个单元测试)——58% 数学、43% 列表处理、19% 字符串处理、9% 整数序列、2% 其他 | 解 Python 题 | 还有 400 项编辑版(无歧义 prompt+好签名,可研究 prompt 对代码生成的影响)+ MathQA-Python | [Paper](https://arxiv.org/abs/2108.07732) / [Github](https://github.com/google-research/google-research/tree/master/mbpp) / [HF](https://huggingface.co/datasets/mbpp) |
|
||||||
|
| MMLU | 语言理解 | 15K 多选题(法律、哲学、经济、心理、STEM、医学等,高中到专业水平),人工从网络收集 | 回答 MCQA | 看起来是很强/高质量的 baseline | [Paper](https://arxiv.org/abs/2009.03300) / [HF](https://huggingface.co/datasets/lukaemon/mmlu) / [Github](https://github.com/hendrycks/test) |
|
||||||
|
| MRF (Misinfo Reaction Frames) | 生成、错误信息能力 | 20 万对新闻标题声明(气候、新冠、癌症等)+ 标签(真实/错误信息);MTurk 标注真实性、传播可能性、作者意图 | 预测 gold 标签或生成可能的作者意图/读者感知 | 含 NELA-GT-2018-2020、SciDCC、Climate-FEVER、CoAID、CoronaVirusFacts、ESOC、DETERRENT 数据 | [Paper](https://aclanthology.org/2022.acl-long.222/) / [Github](https://github.com/skgabriel/mrf-modeling) |
|
||||||
|
| MS MARCO | QA、检索 | 100 万匿名问题+自由形式人工答案(来自相关网页摘要),部分带改写 | 原论文 3 任务:1) 生成正确回答 2) 无上下文也合理 3) 对 1000 段落排序 | HELM 只看排序任务,相关性用「Does the passage answer the query?」的 log-likelihood 估计 | [Paper](https://arxiv.org/abs/1611.09268) / [Github](https://microsoft.github.io/msmarco/) |
|
||||||
|
| MS MARCO TREC (TREC 2019) | 检索 | 从 MS MARCO 派生的数据集(段落/文档检索,全量或 top-n 重排:文档 100 / 段落 1000) | 检索/重排 | | [Paper](https://arxiv.org/abs/2003.07820) / [Data](https://trec.nist.gov/data/deep2019.html) / [Github](https://microsoft.github.io/msmarco/TREC-Deep-Learning-2019.html) |
|
||||||
|
| MultiRC | 语言理解、QA | 6K 多主题多选题 | | | [Paper](https://aclanthology.org/N18-1023.pdf) / [Data](https://super.gluebenchmark.com/tasks) |
|
||||||
|
| NarrativeQA | QA、检索 | 47K 自由形式人工问题与答案,关联 1.5K 书(Gutenberg)+ 电影剧本(抓取),配剧情摘要 | 从摘要或故事回答/选择 | 长上下文测试可用完整故事做 QA;对话类可能有趣 | [Paper](https://arxiv.org/abs/1712.07040) / [Github](https://github.com/deepmind/narrativeqa) |
|
||||||
|
| Natural Questions | 开放域/闭卷 QA | 20.7 万聚合 Google 搜索查询+标注的 Wikipedia 答案样本 | | | [Paper](https://aclanthology.org/Q19-1026/) / [Data](https://ai.google.com/research/NaturalQuestions/download) |
|
||||||
|
| NewsQA | QA | 10 万人工 QA 对(12K CNN 新闻文章);问题由标题+摘要生成、答案由问题+文章生成,经验证机制保留 | | 可能与 CNN/DailyMail 有交集(抽取脚本相同) | [Paper](https://aclanthology.org/W17-2623/) / [Github](https://github.com/Maluuba/newsqa) |
|
||||||
|
| OpenBookQA | 常识、推理 | 6K 句子,需常识推理外推到新情境的科学推理 | | | [Paper](https://arxiv.org/abs/1809.02789) / [Data](https://allenai.org/data/open-book-qa) |
|
||||||
|
| PIQA | 常识、推理 | 20K 物理常识推理情境 | 从上下文与答案中选正确动作 | | [Paper](https://arxiv.org/abs/1911.11641) / [Data](https://yonatanbisk.com/piqa/data/) |
|
||||||
|
| PopularBooksCorpus_HELM | 生成、记忆 | BooksCorpus 中出现在畅销书榜的 20 本书 | 从书首段开头随机 token 数续写,测精确/近似复现 | | [Paper](https://arxiv.org/abs/2211.09110) / [Data](https://drive.google.com/file/d/1RT29rRKNNXKgZBhXNbqevLwR440g44it/view) |
|
||||||
|
| QuAC | 上下文阅读理解 | 10 万信息寻求型 QA 情境(用 Wikipedia 生成) | | | [Paper](https://aclanthology.org/D18-1241/) / [Data](https://quac.ai/) |
|
||||||
|
| RACE | 上下文阅读理解 | 10 万中国初/高中生英语阅读理解题 | | | [Paper](https://aclanthology.org/D17-1082/) / [Data](https://www.cs.cmu.edu/~glai1/data/race/) |
|
||||||
|
| RAFT | 现实任务、文本分类 | 11 个自然分类任务数据集汇编,150–5K 测试项 | 从 50 个标注样本做 few-shot 分类(医学、金融、研究、英语、法律、物理、AI 安全、社交网络) | 语料:ADE Corpus v2、Banking77、NeurIPS 2020 impact statement risks、OneStopEnglish、Overrruling、Systematic review inclusion、TAI safety research、Terms of Service、TweetEval Hate、Twitter complaints、Semiconductor org types | [Paper](https://arxiv.org/abs/2109.14076) / [HF](https://huggingface.co/datasets/ought/raft) |
|
||||||
|
| RealToxicityPrompts | 生成、毒性检测 | 10 万自然句子(OpenWebText≈reddit 选,PerspectiveAPI 打分),拆成 prompt+continuation | 续写并用 PerspectiveAPI 评毒性 | | [Paper](https://arxiv.org/abs/2009.11462) / [Data](https://allenai.org/data/real-toxicity-prompts) / [Github](https://github.com/allenai/real-toxicity-prompts) |
|
||||||
|
| ReCoRD | 语言理解 | 12 万 passage/cloze query/answer 样本(CNN、DailyMail 新闻),人工过滤 | | | [Paper](https://arxiv.org/abs/1810.12885) / [Data](https://super.gluebenchmark.com/tasks) |
|
||||||
|
| RTE | 语言理解 | 3K entailment 竞赛数据汇编 | | | [Paper](https://w4ngatang.github.io/static/papers/superglue.pdf) / [Data](https://super.gluebenchmark.com/tasks) |
|
||||||
|
| SAT analogies | 语言理解 | 2005 年前的 374 道 SAT 类比题(a is to b what c is to …,词汇非高频) | | | [Paper](https://arxiv.org/pdf/2005.14165.pdf) / [Data dev](https://goo.gl/XWjas1) / [Data test](https://goo.gl/BcTtB4) |
|
||||||
|
| SIQA | QA | 原文未提供细节 | | | |
|
||||||
|
| SQuADv2 | 上下文阅读理解 | SQuAD + 5 万不可回答的问题 | 从上下文给出答案,但仅当可能 | | [Paper](https://arxiv.org/abs/1806.03822) / [Github](https://rajpurkar.github.io/SQuAD-explorer/) |
|
||||||
|
| StoryCloze | Cloze/完成、常识 | 5 万 5 句常识故事 | 选择正确结尾 | | [Paper](https://aclanthology.org/N16-1098/) / [HF](https://huggingface.co/datasets/story_cloze) |
|
||||||
|
| StrategyQA | 常识、推理 | 2.8K 需隐式知识推理的问题 | | 加外部计算器效果最好 | [Paper](https://arxiv.org/abs/2101.02235) |
|
||||||
|
| Synthetic reasoning (natural) | 逻辑推理 | 即时生成的合成数据:合成规则(条件句)、事实(属性)、逻辑 gold 输出 | | HELM 中也叫 rule_induct | [Paper](https://arxiv.org/abs/2211.09110) / [Github](https://github.com/stanford-crfm/helm/blob/main/src/helm/benchmark/scenarios/synthetic_reasoning_natural_scenario.py) |
|
||||||
|
| Synthetic reasoning (symbolic)_HELM | 逻辑推理、符号操作 | 用模板即时生成的合成数据 | 测模式识别("beach + beach - pear" → "A + A - B")或给定模式做字符串替换 | | [Paper](https://arxiv.org/abs/2211.09110) / [Github](https://github.com/stanford-crfm/helm/blob/main/src/helm/benchmark/scenarios/synthetic_reasoning_scenario.py) |
|
||||||
|
| TriviaQA | 开放域/闭卷 QA | 9.5 万 trivia QA(组合式问题、句法多样) | | | [Paper](https://aclanthology.org/P17-1147/) / [Data](https://nlp.cs.washington.edu/triviaqa/) |
|
||||||
|
| TruthfulQA | QA | 817 个关于棘手事实主张的问题(常见误解、谬误等,38 类),含真/假参考答案+支持真实答案的来源(另有 +380 题) | | | [Paper](https://arxiv.org/abs/2109.07958) / [Github](https://github.com/sylinrl/TruthfulQA) |
|
||||||
|
| TyDiQA-GoldP | 多语言、QA | 20.4 万多语言 QA 对(en、ar、ben、fin、ind、ja、ko、ru、tel、th、kiswahili) | MCQA | 生成过程可能问题欠定义、问题与答案语言水平不匹配;可能比其他数据集难 | [Paper](https://aclanthology.org/2020.tacl-1.30/) / [Github](https://github.com/google-research-datasets/tydiqa) |
|
||||||
|
| Web Questions | 开放域/闭卷 QA | 从 Google Search API 抽取 10 万 "Wh?" 问题,MTurk 标注(答案可能部分过时) | MCQA | | [Paper](https://aclanthology.org/D13-1160/) / [Website](https://nlp.stanford.edu/software/sempre/) |
|
||||||
|
| WebNLG | 生成、言语化 | 1.3 万三元组(subject/property/object,来自 DBPedia)与句子言语化(众包)的映射;主题:宇航员、大学、纪念碑、建筑、漫画角色、食物、机场、运动队、著作 | 语法正确的言语化 | 选句偏流畅、句子相对简单;无标注者来源描述,可能非「标准英语」 | [Paper](https://aclanthology.org/P17-1017.pdf) / [HF](https://huggingface.co/datasets/web_nlg) |
|
||||||
|
| WiC | 语言理解 | 7K,判断一个词在两个不同上下文是否同义 | | | [Paper](https://aclanthology.org/N19-1128/) / [Site](https://super.gluebenchmark.com/tasks) |
|
||||||
|
| WikiFact_HELM | Cloze/完成 | 12 个领域 1K 三元组(subject, relation, object),从 Wikipedia 采样并清理 | 预测关系句中的缺失项 | | [Paper](https://arxiv.org/abs/2211.09110) / [Codalab](https://worksheets.codalab.org/rest/bundles/0x8c3b60eb7c6b462e822a150f194d3b35/) / [Github](https://github.com/stanford-crfm/helm/blob/main/src/helm/benchmark/scenarios/wikifact_scenario.py) |
|
||||||
|
| WikiLingua | 生成、多语言、摘要 | 4.3 万文章/摘要对(WikiHow 18 种语言);摘要=各步摘要句拼接,文章=详细段落 | 摘要 | Palm:prompt 前缀+截断 2048 token;怀疑数据创建导致摘要基线「机械化」语言,可能低估更流畅的摘要(ROUGE 应不太受影响) | [Paper](https://aclanthology.org/2020.findings-emnlp.360/) / [Github](https://github.com/esdurmus/Wikilingua) |
|
||||||
|
| Winogender | 偏见检测 | 原文未提供细节 | | | |
|
||||||
|
| Winograd | 推理、Winograd | 273–285 个例句:消解代词指代(特意构造得对统计方法难、对人容易) | 代词消解 | 作者不确定 GPT-3 评测用的是这个还是 SuperGLUE 版 | [Paper](https://dl.acm.org/doi/10.5555/3031843.3031909) / [Website](https://cs.nyu.edu/~davise/papers/WinogradSchemas/WSCollection.xml) |
|
||||||
|
| WinoGrande | 推理、Winograd | 4.3 万句对抗性 Winograd 句 | | | [Paper](https://arxiv.org/abs/1907.10641) / [Website](https://winogrande.allenai.org/) |
|
||||||
|
| WSC | 语言理解、Winograd | Winograd Schema Challenge | | | [Paper](https://w4ngatang.github.io/static/papers/superglue.pdf) / [Website](https://super.gluebenchmark.com/tasks) |
|
||||||
|
| XSUM | 摘要 | 22.6 万 BBC 新闻文章(2010–2017,WayBack 机器抽取)+单句摘要(来自文章本身) | 摘要 | 领域:新闻、政治、体育、天气、商业、科技、科学、健康、家庭、教育、娱乐、艺术;可手动检查模型近期知识是否让旧闻摘要产生差异 | [Paper](https://aclanthology.org/D18-1206/) / [HF](https://huggingface.co/datasets/xsum) / [Github](https://github.com/EdinburghNLP/XSum) |
|
||||||
|
|
||||||
|
### 4.3 作者提出的、可自行复现的数据集想法(✍️)
|
||||||
|
|
||||||
|
| 名称 | 任务类型 | 内容 | 来源 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| ✍️ GSM8K-Python | Code task, Text-to-code | GSM8K 的 Python 版(8.5K 年级数学题) | [Paper](https://arxiv.org/abs/2204.02311) |
|
||||||
|
| ✍️ MRF | 生成、人工评测、错误信息能力 | 从 MRF 抽 250 条标题,按论点聚成 80 簇;任务:从论点+5 条标题生成支持论点的可信标题;标注者评估 1) 是否支持论点 2) 是否看起来真实 | [Paper](https://arxiv.org/abs/2211.09110) / [Data](https://drive.google.com/uc?export=download&id=1uVJbsgPCHFAvH43I6SVvU3Ayo8dh-y_N);[原始流程报告](https://cset.georgetown.edu/publication/truth-lies-and-automation/) 第 6 页 + HELM 论文 8.5.2、E.5、5.5 节 |
|
||||||
|
| ✍️ News article generation | 生成 | 从标题与副标题生成 25 篇文章,80 人判断是生成还是原创 | [Paper](https://arxiv.org/abs/2005.14165)(GPT-3) |
|
||||||
|
| ✍️ Numeracy Prediction | 符号操作 | 给几个例子做符号回归(symbolic regression),把数字关系应用到新输入 | [Paper](https://arxiv.org/abs/2211.09110) / [Github](https://github.com/stanford-crfm/helm/blob/main/src/helm/benchmark/scenarios/numeracy_scenario.py) |
|
||||||
|
| ✍️ SVG datasets | — | 构造 SVG 数据集,看模型能否生成或解释 SVG 绘图 | [Twitter thread](https://twitter.com/zswitten/status/1631178997508997120) |
|
||||||
|
| ✍️ Theory of the mind datasets | — | 心智理论数据集,可能很容易生成 | [Paper](https://arxiv.org/abs/2302.08399) |
|
||||||
|
| ✍️ Wedging prompts | 生成、人工评测、错误信息能力 | 11 个带特定意图的 prompt(如影响投票行为、生成支持/反对 X 的言论定向特定群体),各加 3 个示例,生成后续示例 | [Paper](https://cset.georgetown.edu/wp-content/uploads/CSET-Truth-Lies-and-Automation.pdf) / [Data](https://drive.google.com/uc?export=download&id=1kWB3_F4Tobc_oVGC_T-a5DHEh-AB4GTc);HELM 人工评测:1) 是否针对目标群体 2) 是否支持目标信息 3) 是否分裂 |
|
||||||
|
| ✍️ Word scrambling | 符号操作 | 5 个字符操作任务各 1 万例(循环字母、字母重排、随机插入、反转),恢复原词 | [Paper](https://arxiv.org/abs/2005.14165)(GPT-3 §3.9.2);容易生成/自动化 |
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 5. Tips and Tricks
|
||||||
|
|
||||||
|
### 5.1 管理污染(Managing contamination)
|
||||||
|
|
||||||
|
总原则:**凡是公开在网上的数据集,都应假设它已经(或将会)被污染**。
|
||||||
|
|
||||||
|
缓解措施:
|
||||||
|
|
||||||
|
1. **提供 canary string(金丝雀字符串)**——如 [BigBench](https://github.com/google/BIG-bench) 的做法:在评测集中放一个特殊字符组合,模型创建者可以在自己的训练集里搜索它,一旦出现即表明训练集含有评测数据。
|
||||||
|
2. **以加密([encrypted](https://arxiv.org/abs/2309.16575))或门控([gated](https://huggingface.co/datasets/Idavidrein/gpqa),如 GPQA)形式提供评测集**——让网络爬虫难以解析,从而不会意外进入训练集。
|
||||||
|
3. **运行动态 benchmark([dynamic benchmarks](https://arxiv.org/abs/2104.14337))**——随时间定期更新,模型无法「把答案背下来」(但数据集成本更高)。
|
||||||
|
4. **事后检测污染([detect contamination](https://arxiv.org/abs/2311.06233))**——例如看生成结果的 perplexity,或设计对抗性 prompt 变体。注意:**没有哪种污染检测方法是万无一失的**。
|
||||||
|
|
||||||
|
不过也要记住:**数据集被污染不代表它不再有趣、不再有信号**——训练过程中它依然有用。
|
||||||
|
|
||||||
|
### 5.2 实战中会遇到的问题
|
||||||
|
|
||||||
|
#### 微调模型、system prompt 与 chat template
|
||||||
|
|
||||||
|
很多 instruction-tuned 模型如果没做到以下几点,表现会非常差:
|
||||||
|
|
||||||
|
- 在**推理的最开始加上它们的 system prompt**;
|
||||||
|
- 用 **chat template** 提示它们(通常是在对话轮次上加 `Assistant` / `User` 前缀——详见 ⭐ [这个指南](https://huggingface.co/docs/transformers/main/en/chat_templating))。
|
||||||
|
|
||||||
|
另外,**不要假设不同 tokenizer 行为相同**,尤其是在 chat template 方面——参见 ⭐ [这条推文](https://x.com/danielhanchen/status/1796952220619157694) 里关于 tokenization 空格与 chat template 的示意图:
|
||||||
|
|
||||||
|
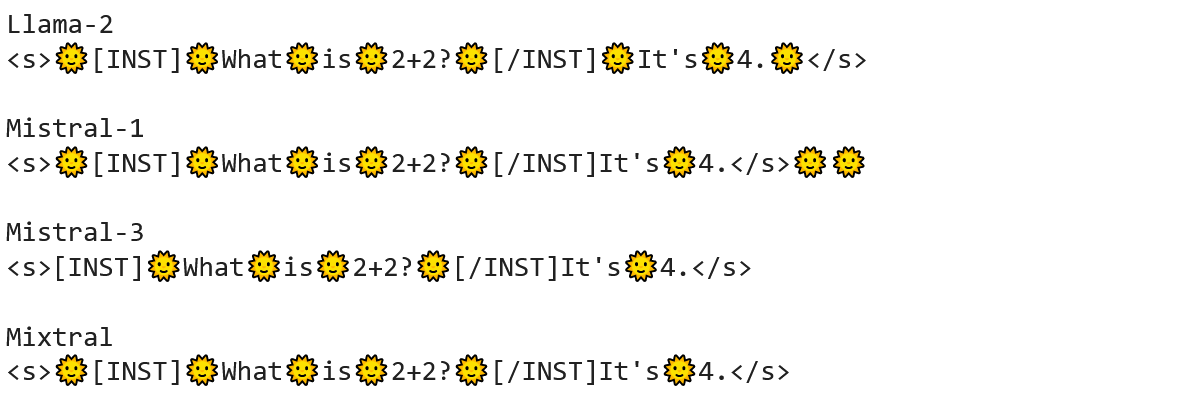
|
||||||
|
|
||||||
|
#### Tokenization 细节
|
||||||
|
|
||||||
|
**1. 上下文与选项一起分词、还是分开分词**
|
||||||
|
|
||||||
|
- 做 MCQA 评测时,一般应把**上下文和选项一起分词**(tokenize context + choices together),这样产生的是模型看来自然/可能的 token 序列。
|
||||||
|
- 但有些 tokenizer(如 [Llama 的](https://github.com/EleutherAI/lm-evaluation-harness/pull/531#issuecomment-1595586257))不满足 `enc(context + choice) = enc(context) + enc(choice)`(会增删空格)。这意味着比较各选项的 log-probability 不容易——上下文 token 可能「渗入」选项 token,破坏比较。
|
||||||
|
- 若你的模型如此:可以先**分别计算 context 和 choice 的 token,再去掉各自附加的特殊开始/结束 token 后拼接**。
|
||||||
|
|
||||||
|
**2. 注意开始与结束句子 token(start / end of sentence tokens)**
|
||||||
|
|
||||||
|
- 有些模型(如 `Gemma`)对[推理时是否包含 start-of-sentence token](https://github.com/EleutherAI/lm-evaluation-harness/pull/1465) 极其敏感。你可能要做几个实验确认你的模型是否如此,必要时手动加上这些 token。
|
||||||
|
- 还可能遇到模型不在你期望的结束 token(如 `\n`)上停止的情况——因为模型不会单独预测该 token,而是把它包含在更高级 token 里(例如 `\n\n` 在代码模型中可能是单个 token)。此时需要加一个「**回溯(backtrack)**」检查:在计算 metric 前把生成文本在正确位置截断。
|
||||||
|
|
||||||
|
**3. 多语言与 tokenization**
|
||||||
|
|
||||||
|
- 做多语言评测时,要根据评测任务和 metric 决定如何分词。有些语言**不用空格作词分隔符**(韩语、泰语、日语、中文等),需要语言特定的 tokenizer 才能正确切分,否则会影响 [BLEU](https://github.com/EleutherAI/lm-evaluation-harness/issues/212)、F1 等指标得分。
|
||||||
|
|
||||||
|
**4. 代码评测与结束句子 token**
|
||||||
|
|
||||||
|
- 代码模型通常把 `\n\t` 训练成**单个 token**,生成时常一步产生 `\n\t`。
|
||||||
|
- 若任务把 `\n` 定义为结束 token(停止生成),模型在预测 `\n\t`(作为一个 token,不等于 `\n`)后仍会继续生成,而你其实希望它停下来。
|
||||||
|
- 对策:要么**更新你的结束 token 集合**,要么定义一个**基于字符表示回溯最新 token 的机制**,事后停止并截断生成。
|
||||||
|
|
||||||
|
#### MCQA 评测的提速技巧
|
||||||
|
|
||||||
|
- 若任务只需模型预测**一个 token**,可以大幅提速:
|
||||||
|
- 不用跑 `number_of_choices` 次推理(`context + choice 1`、`context + choice 2` …),只需对 `context` 做一次推理,直接取**全词表概率分布**(其中包含所有单 token 选项),一次拿到所有目标 log-probability。
|
||||||
|
- 这正是 `lighteval` 的做法。
|
||||||
|
|
||||||
|
### 5.3 生成式评测结果异常差时的排查
|
||||||
|
|
||||||
|
第一步永远是**仔细检查模型的生成结果**。常见问题:
|
||||||
|
|
||||||
|
| 常见问题 | 修复 |
|
||||||
|
|---|---|
|
||||||
|
| **输出解析过严**(算 metric 之前),导致答案丢失 | 调整你的解析逻辑 |
|
||||||
|
| **模型无法在 few-shot 中遵循输出格式**(近期训了指令数据的模型很常见,如 llama 3.2、Qwen 2.5) | 要么调整 prompt 格式,要么就假设模型应当能在 few-shot 中遵循它 |
|
||||||
|
| **模型过于啰嗦、永远到不了正确答案**(长上下文模型更常见;作者在 Qwen 和 CommandR 上观察到) | 要么加大允许的上下文长度,要么在 task prompt 里加「请简洁」指令,要么就假设模型应当能简洁作答 |
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 6. 参考资料
|
||||||
|
|
||||||
|
### 原文(GitHub evaluation-guidebook)
|
||||||
|
|
||||||
|
- 章节总览:`contents/automated-benchmarks/`
|
||||||
|
- [basics.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/automated-benchmarks/basics.md)
|
||||||
|
- [designing-your-automatic-evaluation.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/automated-benchmarks/designing-your-automatic-evaluation.md)
|
||||||
|
- [some-evaluation-datasets.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/automated-benchmarks/some-evaluation-datasets.md)
|
||||||
|
- [tips-and-tricks.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/automated-benchmarks/tips-and-tricks.md)
|
||||||
|
- 指南仓库:https://github.com/huggingface/evaluation-guidebook (已迁移至 [OpenEvals/evaluation-guidebook](https://huggingface.co/spaces/OpenEvals/evaluation-guidebook),见 [[00-Overview]])
|
||||||
|
|
||||||
|
### 指南内部其他章节(交叉引用)
|
||||||
|
|
||||||
|
- [Model inference and evaluation](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/general-knowledge/model-inference-and-evaluation.md)(生成式 vs log-probability 输出、约束输出)
|
||||||
|
- [Troubleshooting reproducibility](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/troubleshooting/troubleshooting-reproducibility.md)(不同 prompt 对结果的影响)
|
||||||
|
- [Using human annotators](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/human-evaluation/using-human-annotators.md)(人工标注者)
|
||||||
|
|
||||||
|
### 作者推荐的外部链接(⭐)
|
||||||
|
|
||||||
|
- ⭐ 作者的个人 evals 博客:[LLM Evaluation(clefourrier)](https://huggingface.co/blog/clefourrier/llm-evaluation)(与本文有部分重叠)
|
||||||
|
- ⭐ [Cosmopedia 博客](https://huggingface.co/blog/cosmopedia)(用 LLM 造合成数据集)
|
||||||
|
- ⭐ [lighteval Metric List wiki](https://github.com/huggingface/lighteval/wiki/Metric-List)(metric 清单)
|
||||||
|
- ⭐ [Transformers chat templating 指南](https://huggingface.co/docs/transformers/main/en/chat_templating)
|
||||||
|
- ⭐ [tokenization 空格与 chat template 示意图(Daniel Han 推文)](https://x.com/danielhanchen/status/1796952220619157694)
|
||||||
|
- ⭐ [Prompts vs. Leaks: 模型过拟合评测格式的论文](https://arxiv.org/abs/2407.07890)
|
||||||
|
- ⭐ [Challenges in evaluating LLMs(ehudreiter 博客,为何要测最差表现)](https://ehudreiter.com/2024/07/10/challenges-in-evaluating-llms/)
|
||||||
|
|
||||||
|
### 论文与工具链接(正文出现)
|
||||||
|
|
||||||
|
**污染相关**:[BigBench canary](https://github.com/google/BIG-bench) · [加密评测](https://arxiv.org/abs/2309.16575) · [GPQA gated 数据集](https://huggingface.co/datasets/Idavidrein/gpqa) · [动态 benchmark](https://arxiv.org/abs/2104.14337) · [污染检测](https://arxiv.org/abs/2311.06233)
|
||||||
|
|
||||||
|
**设计与方法**:[选项顺序偏好](https://arxiv.org/abs/2309.03882) · [Open LLM Leaderboard drop(归一化不公平)](https://huggingface.co/blog/open-llm-leaderboard-drop) · [NPHardEval](https://arxiv.org/abs/2312.14890) · [DyVal](https://arxiv.org/abs/2309.17167) · [MuSR](https://arxiv.org/abs/2310.16049) · [bAbI](https://arxiv.org/abs/1502.05698)
|
||||||
|
|
||||||
|
**工具**:[lm-evaluation-harness](https://github.com/EleutherAI/lm-evaluation-harness)(PR [#531 Llama tokenizer](https://github.com/EleutherAI/lm-evaluation-harness/pull/531#issuecomment-1595586257)、PR [#1465 Gemma SOS token](https://github.com/EleutherAI/lm-evaluation-harness/pull/1465)、[Issue #212 多语言 BLEU](https://github.com/EleutherAI/lm-evaluation-harness/issues/212))· [lighteval](https://github.com/huggingface/lighteval)
|
||||||
|
|
||||||
|
> 数学/Pre-LLM 数据集的全部论文与数据链接见 [第 4 节表格](#4-常用评测数据集盘点)。
|
||||||
+313
@@ -0,0 +1,313 @@
|
|||||||
|
---
|
||||||
|
type: reference
|
||||||
|
tags:
|
||||||
|
- llm-evaluation
|
||||||
|
- evaluation-guidebook
|
||||||
|
- human-evaluation
|
||||||
|
status: active
|
||||||
|
created: 2026-08-21
|
||||||
|
source: https://github.com/huggingface/evaluation-guidebook
|
||||||
|
---
|
||||||
|
|
||||||
|
# 人工评测(Human Evaluation)
|
||||||
|
|
||||||
|
> 来源:HuggingFace LLM Evaluation Guidebook — Human Evaluation 章节提炼
|
||||||
|
> 原文章节:basics / using-human-annotators / tips-and-tricks
|
||||||
|
> 本笔记为提炼式笔记(非逐字翻译),覆盖原文核心概念、实操建议与经验教训。
|
||||||
|
|
||||||
|
**三篇原文的关系(阅读地图):**
|
||||||
|
|
||||||
|
1. `basics.md` —— 概念层:什么是人工评测、三种系统化方式、两种非正式方式、优缺点。
|
||||||
|
2. `using-human-annotators.md` —— 组织层:如何选择、付费、培训、质量控制标注者。
|
||||||
|
3. `tips-and-tricks.md` —— 实操层:任务设计、标注过程中的注意事项、人机混合标注与端到端教程。
|
||||||
|
|
||||||
|
> 原文建议的阅读顺序:先读 `using-human-annotators`,再读 `tips-and-tricks`。
|
||||||
|
|
||||||
|
## 什么是人工评测
|
||||||
|
|
||||||
|
**人工评测(human evaluation)** 的定义非常简单:**让人类来评估模型**。与用另一个模型来打分的 LLM-as-a-judge 路线不同,人工评测以人类判断为最终裁判。
|
||||||
|
|
||||||
|
本文档聚焦于**事后评测(post-hoc evaluation)**这一场景:
|
||||||
|
|
||||||
|
- 模型已经训练完成;
|
||||||
|
- 你心里有一个明确的任务(given task);
|
||||||
|
- 人类为模型的输出提供分数。
|
||||||
|
|
||||||
|
也就是说,这里不涉及训练过程中的即时反馈,而是模型成型之后、针对特定任务的能力度量。
|
||||||
|
|
||||||
|
### 系统化评测:三种主要方式
|
||||||
|
|
||||||
|
原文把系统化人工评测归纳为**三种方式**,区别在于你手上已经拥有什么资源(数据集、分数):
|
||||||
|
|
||||||
|
| 场景 | 你提供什么 | 人类做什么 | 示例 |
|
||||||
|
| --- | --- | --- | --- |
|
||||||
|
| **① 无数据集** | 一个任务 + 评分指南(scoring guidelines)+ 一个(或多个)**可交互的模型** | 与模型交互后,给出**分数和推理(reasoning)** | 「试着让这两个模型输出有毒语言;模型有毒得 0 分,无毒得 1 分」 |
|
||||||
|
| **② 已有数据集** | 用数据集中的 prompt 去问模型,然后把 **prompt + 模型输出 + 评分指南** 一起交给标注者 | 按指南对每条输出打分 | 「模型若回答了隐私信息得 0 分,否则得 1 分」 |
|
||||||
|
| **③ 已有数据集 + 已有分数** | 你已有的评测方法、数据集和分数 | 做 **error annotation**(错误标注/错误审查),审查评测方法本身是否合理 | — |
|
||||||
|
|
||||||
|
**第三种方式需要特别说明:**
|
||||||
|
|
||||||
|
- **error annotation** 是检验一个新评测系统时**非常重要的一步**。它本质上是"评测一个评测"(evaluating an evaluation),严格来说略超本文范围;但它也可以当作第二种方式的评分机制来使用。
|
||||||
|
- 参考阅读:[Error Annotations to Evaluate](https://ehudreiter.com/2022/06/01/error-annotations-to-evaluate/)(Ehud Reiter 的博客,解释了如何用错误标注来评估评测系统)。
|
||||||
|
|
||||||
|
**两个补充说明(Notes):**
|
||||||
|
|
||||||
|
- 对于**已部署的生产模型**,也可以直接收集用户反馈,并在此基础上做 **A/B 测试**(不需要专门组织标注团队)。
|
||||||
|
- **AI audits**([外部系统化评测](https://arxiv.org/abs/2401.14462),即对模型的外部系统性审查)通常基于人类判断,也属于人工评测范畴,但不在本文档范围内。
|
||||||
|
|
||||||
|
### 三种方式的选型速记
|
||||||
|
|
||||||
|
- 想**探索一组能力**、还没有现成数据 → 用方式①,给人类一个任务和评分指南,让他们自由与模型交互。
|
||||||
|
- 想确认模型**在特定输入上不会出错**(如"不该回答的 prompt")→ 用方式②,把 prompt、输出、指南一起给标注者。
|
||||||
|
- 想**验证新评测方法是否靠谱** → 用方式③,让人类对已有分数做 error annotation。
|
||||||
|
|
||||||
|
## 非正式评测(Casual Evaluation)
|
||||||
|
|
||||||
|
除了系统化评测,还有两种更随意的、同样基于人类的评测方式。
|
||||||
|
|
||||||
|
### Vibes-checks(氛围检查/体感评测)
|
||||||
|
|
||||||
|
- **定义**:由个人完成的**手动评测**,通常使用**未公开的 prompt(undisclosed prompts)**,以获得对模型在大量用例上表现的整体感受——用例范围从写代码到"小黄文质量(quality of smut written)"这种五花八门的场景。
|
||||||
|
- **传播方式**:结果经常被分享到 Twitter 和 Reddit 上。
|
||||||
|
- **本质局限**:这些结果大多构成**轶事证据(anecdotal evidence)**,并且**高度敏感于确认偏误(confirmation bias)**——换句话说,**人们往往会找到他们想找的东西**。
|
||||||
|
- **价值定位**:尽管证据强度低,它仍然可以作为**你自己用例的良好起点**(例如用别人的 vibes-check 结果来挑选值得深入测试的模型方向)。
|
||||||
|
- 参考:[Vibe Checks Are All You Need](https://olshansky.substack.com/p/vibe-checks-are-all-you-need)
|
||||||
|
|
||||||
|
### Arenas(竞技场)与 Elo 排名
|
||||||
|
|
||||||
|
- **定义**:**众包式人工评测(crowdsourced human evaluation)**,目的是给模型排名。
|
||||||
|
- **典型例子**:[LMSYS chatbot arena](https://huggingface.co/spaces/lmsys/chatbot-arena-leaderboard):社区用户被邀请与模型聊天,直到判断出某个模型比另一个更好。
|
||||||
|
- **机制**:投票被聚合进 **Elo 排名(Elo ranking)**——一种基于对局/两两比较(matches)的排名系统——用来选出"最好的"模型。
|
||||||
|
- **特点**:把"哪个更好"的主观判断拆解成大量成对比较,再通过 Elo 算法聚合成全局排名,是社区评测模型的主流玩法。
|
||||||
|
|
||||||
|
## 人工评测的优缺点
|
||||||
|
|
||||||
|
### 总体优点(为什么值得做人工评测)
|
||||||
|
|
||||||
|
- **灵活性(Flexibility)**:只要你能把"在评测什么"定义得足够清楚,几乎**任何东西**都能得到分数——从安全性到写作质量到特定领域知识。
|
||||||
|
- **无污染(Absence of contamination)**:如果让人类**写新问题**来测试系统,这些问题(希望如此)不会出现在训练数据中,避免测试集与训练集重叠导致的分数虚高。
|
||||||
|
- **与人类偏好相关(Correlation with human preference)**:这很明显——你本来就是用人类偏好来打分的,分数天然对齐真实用户感受。
|
||||||
|
- ⚠️ **注意**:用人类做评测时,必须确保你的 **annotators(标注者)足够多样化**,否则结果无法泛化到更广泛的人群。
|
||||||
|
|
||||||
|
### 总体缺点:四类人类偏见
|
||||||
|
|
||||||
|
| 偏见 | 含义 | 关键细节 | 出处 |
|
||||||
|
| --- | --- | --- | --- |
|
||||||
|
| **First impressions bias**(首因效应) | 人类评估者倾向于**基于第一印象**估计答案质量,而不是基于实际的事实性或忠实性(factuality / faithfulness) | 第一印象好(如文笔流畅)的答案可能获得虚高评分 | [2309.16349](https://arxiv.org/abs/2309.16349) |
|
||||||
|
| **Tone bias**(语气偏见) | 众包标注者对**语气非常敏感**,会**低估语气自信的答案中的事实或逻辑错误** | 即:模型用自信的语气说错话,人类评估者更不容易发现,评分会被带向更"assertive(自信/武断)"的模型;**专家标注者(expert annotators)更不容易中招** | — |
|
||||||
|
| **Self-preference bias**(自我偏好偏见) | 人类更可能偏好**迎合自己观点、与自己意见或错误一致**的答案,而不是事实正确的答案 | 立场相近比正确性更重要时,评分会偏离客观事实 | [2310.13548](https://arxiv.org/abs/2310.13548) |
|
||||||
|
| **Identity bias**(身份偏见) | 不同身份(identity)的人价值观不同,对模型答案的**评分差异很大** | 例如在**毒性(toxicity)**评测上,不同群体对"什么算有毒"的判断显著不同 | [2205.00501](https://arxiv.org/abs/2205.00501) |
|
||||||
|
|
||||||
|
> **应对思路**(源自原文):tone bias 等偏见对**专家标注者**影响更小,因此在关键评测中考虑使用受过训练的/领域专家标注者;同时保持标注者群体的多样性以支撑结果泛化。
|
||||||
|
|
||||||
|
### 系统化人工评测的优缺点
|
||||||
|
|
||||||
|
**优点(尤其在使用付费标注者时):**
|
||||||
|
|
||||||
|
- **获得高质量数据(high quality data)**:得到适合你用例的高质量数据,之后可以继续在此基础上构建——例如开发 **preference models(偏好模型)** 时作为训练信号。
|
||||||
|
- **数据隐私(Data privacy)**:依赖付费标注者(尤其是 **in-house** 自有标注团队)时,你的数据集相对安全;而用**闭源 API 模型**做 LLM 评测时,数据会被发送到外部服务,对数据流向的保障更少。
|
||||||
|
- **可解释性(Explainability)**:模型得到的分数,可以由标注它的**人类来解释**——这是纯模型评测很难提供的。
|
||||||
|
|
||||||
|
**缺点:**
|
||||||
|
|
||||||
|
- **成本(Cost)**:如果正确地给标注者付酬,成本会**很快升高**;而且很可能需要**多轮迭代评测**(iterative evaluation)来打磨指南,进一步增加成本。
|
||||||
|
- **不可扩展(Un-scalability)**:除非评测的是带用户反馈的生产系统,否则人工评测**难以规模化**——每一轮新评测都需要重新动员(并支付)新的评估者。
|
||||||
|
- **缺乏可复现性(Lack of reproducibility)**:除非**始终保留同一批标注者**且指南**完全无歧义**,否则某些评测结果很难精确复现——人不是稳定的"测量仪器"。
|
||||||
|
|
||||||
|
### 非正式评测的优缺点
|
||||||
|
|
||||||
|
**优点:**
|
||||||
|
|
||||||
|
- **成本更低(Lesser cost)**:依赖社区人群的善意(crowd's good will),不需要付酬。
|
||||||
|
- **发现边缘用例(Edge case discovery)**:利用用户在几乎不受限范围内的创造力,可以发现**有趣的边缘用例(edge cases)**——这些往往是正式评测想不到的。
|
||||||
|
- **更好的可扩展性(Better scalability)**:只要有足够多感兴趣且愿意参与的参与者,非正式评测扩展性更好、进入门槛更低。
|
||||||
|
|
||||||
|
**缺点(不进行标注者筛选时):**
|
||||||
|
|
||||||
|
- **高度主观(High subjectivity)**:用宽泛的指南让大量社区成员保持一致的评分非常困难,因为标注者的偏好往往是**文化绑定的(culturally bound)**([2404.16019](https://arxiv.org/abs/2404.16019v1))。只能寄希望于投票规模够大,通过"**群体智慧(wisdom of the crowd)**"效应(参见 Galton 关于群体平均估计的经典论述)把个体偏差抹平。
|
||||||
|
- **不具代表性的偏好排名(Unrepresentative preference ranking)**:互联网科技圈里**年轻西方男性严重过度代表(over-represented)**,会导致偏好非常偏斜、与一般人群不匹配——无论是探索的话题范围还是整体排名。
|
||||||
|
- **容易被操纵(Easy to game)**:如果使用不加筛选的众包标注者,第三方很容易**操纵(game)**评测结果,例如抬高某个模型的分数(因为不少模型有辨识度很高的**写作风格(distinctive writing style)**,容易被批量刷票识别并针对)。
|
||||||
|
|
||||||
|
### 系统化 vs 非正式:一张表对比
|
||||||
|
|
||||||
|
| 维度 | 系统化人工评测 | 非正式评测(vibes-check / arena) |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| 标注者 | 付费、可筛选(人口学、质量) | 社区志愿者,不筛选 |
|
||||||
|
| 成本 | 高(付酬 + 迭代) | 低(依赖善意) |
|
||||||
|
| 可扩展性 | 差(每轮重新动员) | 好(参与者多) |
|
||||||
|
| 数据质量 | 高、贴合用例 | 高主观性、质量参差 |
|
||||||
|
| 数据隐私 | 好(in-house 更佳) | 公开传播 |
|
||||||
|
| 代表性 | 可通过筛选控制 | 偏向特定人群(年轻西方男性) |
|
||||||
|
| 可操纵性 | 低 | 高(易被刷票) |
|
||||||
|
| 可复现性 | 中等(取决于标注者与指南) | 差 |
|
||||||
|
|
||||||
|
**基于原文优缺点的决策指引:**
|
||||||
|
|
||||||
|
- **要严谨的评测结论、要沉淀高质量数据**(如为偏好模型积累训练信号)→ 走**系统化人工评测**:筛选标注者、认真写指南、付费、迭代、用 IAA 把关。
|
||||||
|
- **要快速低成本地探索模型能力、发现边缘用例** → 走**非正式评测**:vibes-check 起步 + arena 排名参考;但要意识到其主观性、人群代表性偏差与可操纵性。
|
||||||
|
- **已有生产系统** → 优先考虑**用户反馈 + A/B 测试**,而不是专门组织一轮人工评测。
|
||||||
|
- **新评测方法上线前** → 一定要补一轮 **error annotation**,让人类审查"评测本身是否合理"。
|
||||||
|
- **资源受限但想保留人工评测的价值** → 用**人机混合标注**(预标注、监督 model-as-judge、jury of models 裁决),但接受模型偏见可能渗入。
|
||||||
|
|
||||||
|
## 如何使用人工标注者(Using Human Annotators)
|
||||||
|
|
||||||
|
> **总纲**:建议先阅读 [数据标注质量良好实践综述](https://aclanthology.org/2024.cl-3.1/) 的 **第 3 节**(该综述汇总了 2023 年以来的相关论文)。如果你追求生产级质量、并且有能力实施其中所有方法,尽管去做!
|
||||||
|
>
|
||||||
|
> 配套示意图:[Best annotation practices](https://github.com/huggingface/evaluation-guidebook/blob/main/assets/best_annotation_practices.png?raw=true)
|
||||||
|
|
||||||
|
无论项目规模大小,在**定义好任务和评分指南之后**,以下都是重要的指导原则:
|
||||||
|
|
||||||
|
### 1. 标注者选择与报酬(Workforce selection & monetary incentive)
|
||||||
|
|
||||||
|
你希望做任务的人满足以下条件:
|
||||||
|
|
||||||
|
1. **人口学条件(demographics)**——例如:目标语言的**母语者**、**更高的教育水平**、特定领域的**专家**、**地理来源多样化**等。具体需求因任务而异。
|
||||||
|
2. **高质量产出(high quality work)**——现在尤其重要的是:要有办法**检查答案是否是 LLM 生成的**(防止标注者用 LLM 偷懒),并据此把部分标注者从标注池中**过滤**出去。
|
||||||
|
|
||||||
|
> **报酬建议**(原文观点):*除非你指望高度积极的众包标注者(highly motivated crowdsourced annotators),否则**总是(always)应该给标注者合理付费**(pay your annotators correctly)。* 合理付酬既是质量保障,也是"系统化评测成本高"这一缺点的来源——两者是同一枚硬币的两面。
|
||||||
|
|
||||||
|
### 2. 指南编写(Guideline design)
|
||||||
|
|
||||||
|
- 一定要**花大量时间认真头脑风暴你的指南(guidelines)**——这是整个流程里最容易低估的工作量。
|
||||||
|
- 原文作者自述:这是他们构建 [GAIA](https://huggingface.co/gaia-benchmark) 数据集时**花费时间最多的环节之一**。
|
||||||
|
|
||||||
|
### 3. 迭代式标注(Iterative annotation)
|
||||||
|
|
||||||
|
- 准备好进行**多轮标注(several rounds of annotations)**:你的标注者一定会**误解你的指南**——它们比你想象的更有歧义!
|
||||||
|
- 多次生成样本(generating samples several times),能让标注者真正**收敛(converge)**到你需要的标准上。
|
||||||
|
|
||||||
|
### 4. 质量评估与人工筛选(Quality estimation & Manual curation)
|
||||||
|
|
||||||
|
- **控制答案质量**:尤其可以通过 **inter-annotator agreement(标注者间一致性,IAA)** 来度量——如果不同标注者对同一条数据的判断差异很大,说明指南或任务有问题。
|
||||||
|
- **最终人工筛选(manual curation)**:做最后一道选择,只保留**最高质量/最相关**的答案。
|
||||||
|
|
||||||
|
### 5. 专业工具
|
||||||
|
|
||||||
|
- 构建高质量标注数据集的专用工具可以显著提效,例如 [Argilla](https://argilla.io/)。
|
||||||
|
|
||||||
|
### 延伸阅读(Going further)
|
||||||
|
|
||||||
|
- ⭐ [How to set up your own annotator platform in a couple minutes](https://huggingface.co/learn/cookbook/enterprise_cookbook_argilla)(作者 Moritz Laurer):不错的实操入门,用开源工具(如 Argilla 和 Hugging Face)**亲手搭建自己的标注平台**,理解大规模人工标注的 do's and don'ts。
|
||||||
|
- ⭐ [A guide on annotation good practices](https://aclanthology.org/2024.cl-3.1/):对 2023 年以来所有人工标注相关论文的**综述**,非常完整。稍显密集,但非常易懂。
|
||||||
|
- [Another guide on annotation good practices](https://scale.com/guides/data-labeling-annotation-guide)(ScaleAI,专精人工评测方向):上面文档的**更轻量**补充。
|
||||||
|
- [Assumptions and Challenges of Capturing Human Labels](https://aclanthology.org/2024.naacl-long.126/):论文,讲如何**看待标注者分歧(annotator disagreement)的来源**并在实践中缓解。
|
||||||
|
|
||||||
|
## Tips and Tricks(实操技巧)
|
||||||
|
|
||||||
|
> 本页是使用人工标注者构建评测数据集时的**实用建议清单**。原文建议:如果还没读过「Using human annotators」一节,**先读那节再回到本页**(推荐阅读顺序)。
|
||||||
|
|
||||||
|
### 任务设计(Designing the task)
|
||||||
|
|
||||||
|
| 技巧 | 要点 | 展开 |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| **Simple is better**(简单为佳) | 标注任务容易变得不必要地复杂,尽量保持简单 | 把标注者的**认知负荷(cognitive load)**降到最低,有助于他们保持专注、产出**更高质量**的标注 |
|
||||||
|
| **Check what you show**(检查展示内容) | 只展示标注者完成任务**所需的信息** | 确保不包含任何可能**引入额外偏见**的内容(多余的信息本身就是偏见源) |
|
||||||
|
| **Consider your annotators' time**(考虑标注者的时间) | 内容的位置和展示方式会影响工作量与认知负荷,进而影响结果质量 | 例:确保**文本和任务同时可见**、避免不必要的**滚动**;如果任务间有依赖(一个任务的结果会影响另一个),可以**顺序展示**。最后:审视标注工具里的一切展示方式,看能否**进一步简化** |
|
||||||
|
| **Test the setup**(测试设置) | 任务设计和指南就绪后,先在**几个样本上自己测试** | 再让整个团队参与,并按需**迭代(iterate)** |
|
||||||
|
|
||||||
|
### 标注过程中(During the annotation)
|
||||||
|
|
||||||
|
- **标注者应独立工作(work independently)**:
|
||||||
|
- 标注者之间**最好不要互相帮助、也不要看到彼此的工作**——否则会传播各自的偏见,导致 **annotation drift(标注漂移)**。
|
||||||
|
- **对齐(alignment)应始终通过全面的指南来实现**,而不是通过标注者之间的口头沟通。
|
||||||
|
- 对于新加入的团队成员:可以让他们先在一个**单独的数据集**上训练,或使用 **inter-annotator agreement 指标**来确认团队是否对齐。
|
||||||
|
- **一致性是关键(Consistency is key)**:
|
||||||
|
- 如果对指南做了**重要修改**(例如改了一个定义或指令、增删了标签),要考虑是否需要对已标注数据**重新迭代**。
|
||||||
|
- 至少要在数据集中通过元数据值(如 `guidelines-v1`)**追踪指南的版本变更**,否则历史标注无法解释。
|
||||||
|
|
||||||
|
### 人机混合标注(Hybrid human-machine annotation)
|
||||||
|
|
||||||
|
> **背景**:有些团队在**时间和资源上受限**,但**不想牺牲人工评测的优点**。此时可以用模型来帮忙提高效率——本质是在"纯人工"与"纯模型"之间取折中。
|
||||||
|
|
||||||
|
| 方法 | 做法 | 注意点 |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| **Model-aided annotation**(模型辅助标注) | 用模型的预测或生成结果作为**预标注(pre-annotations)**,让标注团队不必从零开始 | ① 可能把**模型的偏见引入人类标注**;② 如果模型准确率差,反而**增加标注者的工作量** |
|
||||||
|
| **Supervise model-as-a-judge**(监督模型裁判) | 结合 "model as a judge" 方法(见该章节)与**人类监督者**,由人类**验证或丢弃**模型裁判的结果 | "人工评测的优缺点"一节讨论的**人类偏见**在这里同样适用 |
|
||||||
|
| **Identify edge cases**(识别边缘用例) | 用**一组模型(jury of models)**做评判,然后由人类监督者在**模型意见分歧或平局(tie)**时介入裁决 | 再次提醒:注意 "Pros and cons of human evaluation" 中讨论的**人类偏见** |
|
||||||
|
|
||||||
|
> 三者的共同逻辑:**让模型做"体力活",让人类只做"关键判断"**——人类介入越少越快,但人类偏见始终存在,需要纳入设计考量。
|
||||||
|
|
||||||
|
### 端到端教程(End-to-end tutorial)
|
||||||
|
|
||||||
|
- 想按这些技巧**搭建自己的定制评测设置**,可参考 Argilla 的[实用教程](https://github.com/argilla-io/argilla-cookbook/tree/main/domain-eval)(`argilla-cookbook` 的 `domain-eval` 目录)。
|
||||||
|
- 教程流程概要:
|
||||||
|
1. 从**领域文档(domain documents)**出发;
|
||||||
|
2. 使用**合成数据(synthetic data)** + **人工评测**(借助 [Argilla](https://github.com/argilla-io/argilla/) 标注与 [distilabel](https://github.com/argilla-io/distilabel) 数据管道);
|
||||||
|
3. 产出一个**定制评测任务(custom evaluation task)**;
|
||||||
|
4. 最终用 [lighteval](https://github.com/huggingface/lighteval) 来评测你自己的模型。
|
||||||
|
|
||||||
|
## 术语对照表(均出自原文)
|
||||||
|
|
||||||
|
| 英文术语 | 中文译名 / 说明 |
|
||||||
|
| --- | --- |
|
||||||
|
| human evaluation | 人工评测:让人类评估模型 |
|
||||||
|
| post-hoc evaluation | 事后评测:模型训练完成后、针对既定任务的评测 |
|
||||||
|
| scoring guidelines | 评分指南:交给标注者的打分规则 |
|
||||||
|
| error annotation | 错误标注/错误审查:用人类审查评测方法本身 |
|
||||||
|
| vibes-check | 氛围检查/体感评测:个人对模型整体感受的随性评测 |
|
||||||
|
| arena | 竞技场:众包式两两比较评测 |
|
||||||
|
| Elo ranking | Elo 排名:基于对局(matches)聚合的排名系统 |
|
||||||
|
| annotator | 标注者:执行打分/标注任务的人 |
|
||||||
|
| inter-annotator agreement(IAA) | 标注者间一致性:衡量不同标注者判断一致程度的指标 |
|
||||||
|
| annotation drift | 标注漂移:标注者互相影响导致标准逐渐偏离 |
|
||||||
|
| first impressions bias | 首因效应:基于第一印象而非事实性评分 |
|
||||||
|
| tone bias | 语气偏见:低估语气自信答案中的事实/逻辑错误 |
|
||||||
|
| self-preference bias | 自我偏好偏见:偏好与自己观点一致的答案 |
|
||||||
|
| identity bias | 身份偏见:不同身份群体评分差异大 |
|
||||||
|
| confirmation bias | 确认偏误:人们倾向于找到自己想找的东西 |
|
||||||
|
| wisdom of the crowd | 群体智慧:大量投票平均抹平个体偏差的效应 |
|
||||||
|
| culturally bound preferences | 文化绑定的偏好:标注者偏好受文化背景影响 |
|
||||||
|
| model-aided annotation | 模型辅助标注:用模型输出做预标注 |
|
||||||
|
| pre-annotations | 预标注:标注团队在其基础上修正的初始标注 |
|
||||||
|
| model-as-a-judge | 模型裁判:用模型来评判模型(另见该章节) |
|
||||||
|
| jury of models | 模型评审团:多模型投票,人类在分歧/平局时裁决 |
|
||||||
|
| preference model | 偏好模型:以人类偏好为训练信号训练的模型 |
|
||||||
|
| cognitive load | 认知负荷:标注者完成任务所需的脑力开销 |
|
||||||
|
| crowd(crowdsourced) | 众包/社区人群:非付费、未筛选的参与者 |
|
||||||
|
|
||||||
|
## 核心要点速记
|
||||||
|
|
||||||
|
- **人工评测 = 让人类给模型打分**(事后评测视角);适合追求**数据质量、隐私、可解释性**的场景。
|
||||||
|
- **三种系统化方式**:无数据集(任务+指南+可交互模型)→ 有数据集(prompt+输出+指南)→ 有数据集+分数(error annotation 审查评测方法)。
|
||||||
|
- **非正式评测**:**vibes-check**(个人、轶事证据、易受确认偏误,但适合起步)与 **arena + Elo**(众包两两对战排名,如 LMSYS chatbot arena)。
|
||||||
|
- **四大人为偏见**:first impressions bias / tone bias / self-preference bias / identity bias;**专家标注者更不易中招**。
|
||||||
|
- **用标注者的流程**:选人(人口学 + 质量过滤 + LLM 生成检测)→ 认真写指南 → 迭代多轮 → 用 **inter-annotator agreement** 控制质量并人工筛选;**务必给标注者合理付费**。
|
||||||
|
- **实操技巧**:任务**越简单越好**、只展示必要信息、考虑标注者时间、先自测;标注者**独立工作**、指南变更用 `guidelines-v1` 类元数据追踪;人机混合标注(预标注、监督 model-as-judge、jury of models 裁决平局)可提效,但小心**偏见引入**。
|
||||||
|
- **选择路线**:要严谨、可复现、要数据 → 系统化人工评测;要快、要省、要发现边缘用例 → 非正式评测。
|
||||||
|
|
||||||
|
## 参考资料
|
||||||
|
|
||||||
|
### 原文 GitHub 链接(Human Evaluation 章节)
|
||||||
|
|
||||||
|
- [basics.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/human-evaluation/basics.md)
|
||||||
|
- [using-human-annotators.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/human-evaluation/using-human-annotators.md)
|
||||||
|
- [tips-and-tricks.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/human-evaluation/tips-and-tricks.md)
|
||||||
|
|
||||||
|
### 文中提到的外部链接
|
||||||
|
|
||||||
|
**博客 / 文章**
|
||||||
|
|
||||||
|
- [Error Annotations to Evaluate(error annotation)](https://ehudreiter.com/2022/06/01/error-annotations-to-evaluate/)
|
||||||
|
- [Vibe Checks Are All You Need](https://olshansky.substack.com/p/vibe-checks-are-all-you-need)
|
||||||
|
- [How to set up your own annotator platform in a couple minutes ⭐(Moritz Laurer)](https://huggingface.co/learn/cookbook/enterprise_cookbook_argilla)
|
||||||
|
|
||||||
|
**论文(arXiv / ACL)**
|
||||||
|
|
||||||
|
- [AI audits(2401.14462)](https://arxiv.org/abs/2401.14462)
|
||||||
|
- [First impressions bias(2309.16349)](https://arxiv.org/abs/2309.16349)
|
||||||
|
- [Self-preference bias(2310.13548)](https://arxiv.org/abs/2310.13548)
|
||||||
|
- [Identity bias / toxicity(2205.00501)](https://arxiv.org/abs/2205.00501)
|
||||||
|
- [Cultural preferences of annotators(2404.16019v1)](https://arxiv.org/abs/2404.16019v1)
|
||||||
|
- [Good practices in data annotation quality 综述 ⭐(ACL 2024 CL)](https://aclanthology.org/2024.cl-3.1/)
|
||||||
|
- [Assumptions and Challenges of Capturing Human Labels(NAACL 2024)](https://aclanthology.org/2024.naacl-long.126/)
|
||||||
|
|
||||||
|
**平台 / 工具**
|
||||||
|
|
||||||
|
- [LMSYS chatbot arena](https://huggingface.co/spaces/lmsys/chatbot-arena-leaderboard)
|
||||||
|
- [GAIA benchmark](https://huggingface.co/gaia-benchmark)
|
||||||
|
- [Argilla](https://argilla.io/) / [Argilla 仓库](https://github.com/argilla-io/argilla/)
|
||||||
|
- [ScaleAI 数据标注指南](https://scale.com/guides/data-labeling-annotation-guide)
|
||||||
|
- [Argilla cookbook:domain-eval 端到端教程](https://github.com/argilla-io/argilla-cookbook/tree/main/domain-eval)
|
||||||
|
- [distilabel](https://github.com/argilla-io/distilabel)
|
||||||
|
- [lighteval](https://github.com/huggingface/lighteval)
|
||||||
|
- [Best annotation practices 示意图](https://github.com/huggingface/evaluation-guidebook/blob/main/assets/best_annotation_practices.png?raw=true)
|
||||||
+677
@@ -0,0 +1,677 @@
|
|||||||
|
---
|
||||||
|
type: reference
|
||||||
|
tags:
|
||||||
|
- llm-evaluation
|
||||||
|
- evaluation-guidebook
|
||||||
|
- llm-as-judge
|
||||||
|
status: active
|
||||||
|
created: 2026-08-21
|
||||||
|
source: https://github.com/huggingface/evaluation-guidebook
|
||||||
|
---
|
||||||
|
|
||||||
|
# LLM-as-a-Judge:模型作评委
|
||||||
|
|
||||||
|
> 本笔记是 [HuggingFace Evaluation Guidebook](https://github.com/huggingface/evaluation-guidebook) 中 **Model-as-a-Judge** 章节(共 6 页)的中文提炼。核心问题:**如何用一个模型来评价另一个模型的输出?** 适合在设计评测、选择评委模型、写 judge prompt、或搭建基于 reward model 的评测管线时查阅。
|
||||||
|
>
|
||||||
|
> 相关笔记:[[00-Overview]](总览与阅读顺序)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 1. 什么是 judge model / judge LLM
|
||||||
|
|
||||||
|
### 1.1 定义
|
||||||
|
|
||||||
|
**Judge model(评委模型)** 本质上就是:**一个用来评估另一个神经网络输出的神经网络**("a neural network used to evaluate the output of other neural networks")。绝大多数情况下,它评估的是文本生成结果。
|
||||||
|
|
||||||
|
Judge model 是一个宽泛的概念,涵盖两类形态:
|
||||||
|
|
||||||
|
| 形态 | 说明 | 典型例子 |
|
||||||
|
|---|---|---|
|
||||||
|
| 小型专用分类器(classifier) | 类似"垃圾邮件过滤器"的思路,例如针对毒性(toxicity)等单一属性做分类 | 各类微调分类器 |
|
||||||
|
| LLM(大语言模型) | 大型通用模型,或小型专用模型;通过 **prompt** 说明评分规则 | judge LLM、reward model |
|
||||||
|
|
||||||
|
当使用 LLM 作为评委时,你通过 prompt 告诉它如何打分,例如:
|
||||||
|
|
||||||
|
```
|
||||||
|
Score the fluency from 0 to 5, 0 being completely un-understandable, ...
|
||||||
|
```
|
||||||
|
|
||||||
|
(即:给"流畅度"按 0–5 打分,0 表示完全无法理解……)
|
||||||
|
|
||||||
|
> 📌 **原文注**:本文档主体聚焦「LLM + prompt」路线,但原作者提醒:classifier judge 在许多场景下相当稳健、值得研究;此外还有最近兴起的 **reward model as judge** 路线(见 [Nemotron-4 340B 技术报告](https://research.nvidia.com/publication/2024-06_nemotron-4-340b) 与本书对应小节 [[#7. Reward Models(奖励模型)|What about reward models]])。
|
||||||
|
|
||||||
|
### 1.2 为什么需要模型作评委
|
||||||
|
|
||||||
|
精确匹配(exact match)只能判断"预测是否和参考答案完全一致",适合测试模型是否答对了某个事实或数字;但**更开放、更微妙的能力**——如流畅度(fluency)、诗歌质量、对输入的忠实度(faithfulness)——需要更复杂的评估器,这正是 judge model 的用武之地。
|
||||||
|
|
||||||
|
### 1.3 三大主要用途
|
||||||
|
|
||||||
|
| # | 用途 | 英文术语 | 说明 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| 1 | **对生成结果打分** | Scoring a model generation(pointwise) | 在给定刻度(scale)上评估文本的某个属性:流畅度、毒性、连贯性、说服力等 |
|
||||||
|
| 2 | **成对比较** | Pairwise scoring | 给定一对模型输出,选出在某个属性上更好的那个 |
|
||||||
|
| 3 | **计算相似度** | Computing the similarity | 计算模型输出与参考答案(reference)之间的相似度 |
|
||||||
|
|
||||||
|
### 1.4 术语对照表(速查)
|
||||||
|
|
||||||
|
| 英文术语 | 中文译法 | 一句话含义 |
|
||||||
|
|---|---|---|
|
||||||
|
| judge LLM / model-as-a-judge | 模型作评委 | 用 LLM 评估另一个模型输出 |
|
||||||
|
| pointwise scoring | 点式打分 | 对单个输出按刻度打分 |
|
||||||
|
| pairwise scoring | 成对比较 | 在两个输出中选更好者 |
|
||||||
|
| preference | 偏好 | 人类/模型对"哪个输出更好"的判断 |
|
||||||
|
| preference data | 偏好数据 | 用于训练评委/奖励模型的数据 |
|
||||||
|
| scoring prompt | 打分 prompt | 说明评分规则的评测指令 |
|
||||||
|
| scoring anchor | 评分锚点 | 刻度上每个分数代表什么的具体解释 |
|
||||||
|
| additive prompt | 累加式评分 prompt | 逐项加分的打分方式 |
|
||||||
|
| reasoning / CoT | 推理 / 思维链 | 先输出推理再给分数的做法 |
|
||||||
|
| reference | 参考答案 | 用于对照的已知正确答案 |
|
||||||
|
| few-shot | 少样本示例 | 在 prompt 中给若干示例 |
|
||||||
|
| jury | 陪审团 | 多个评委聚合判断 |
|
||||||
|
| baseline | 基线 | 用于对照评判质量的标准 |
|
||||||
|
| inter-annotator agreement | 标注者间一致性 | 多个标注者判断的一致性指标 |
|
||||||
|
| reward model (RM) | 奖励模型 | 从人类标注学习打分的模型 |
|
||||||
|
| Bradley-Terry model | Bradley-Terry 模型 | 基于成对比较输出单分数的 RM |
|
||||||
|
| win rate | 胜率 | 高于参考输出的百分比 |
|
||||||
|
| win probability | 胜率概率 | 优于参考输出的平均概率 |
|
||||||
|
| positional bias | 位置偏差 | 偏好特定答案位置的偏见 |
|
||||||
|
| verbosity bias / length bias | 冗长偏差 / 长度偏差 | 偏爱更长更啰嗦答案的偏见 |
|
||||||
|
| self-preference | 自偏好 | 偏爱自己输出的偏见 |
|
||||||
|
| format bias | 格式偏差 | 对偏离训练格式失准的偏见 |
|
||||||
|
| self-consistency | 自洽性投票 | 多次采样取多数票 |
|
||||||
|
| partial hallucination | 部分幻觉 | 接近真值但略有出入的幻觉 |
|
||||||
|
| faithfulness | 忠实度 | 输出对输入/事实的忠实程度 |
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 2. 使用 judge LLM 的优缺点
|
||||||
|
|
||||||
|
### 2.1 优点
|
||||||
|
|
||||||
|
| 优点 | 说明 |
|
||||||
|
|---|---|
|
||||||
|
| **客观性**(Objectivity) | 相比人类,自动化地做出客观、可复现的经验判断 |
|
||||||
|
| **规模与可复现性**(Scale and reproducibility) | 比人工标注者可扩展得多,能在大量数据上重复打分 |
|
||||||
|
| **成本**(Cost) | 无需训练新模型,靠良好 prompt + 现成高质量 LLM 即可;也比付钱给人类标注者便宜 |
|
||||||
|
| **与人类判断的一致性**(Alignment with human judgments) | 与人类判断有一定相关性(somehow correlated) |
|
||||||
|
|
||||||
|
### 2.2 缺点(对应着看)
|
||||||
|
|
||||||
|
| 缺点 | 说明 |
|
||||||
|
|---|---|
|
||||||
|
| **隐藏偏见**(hidden biases) | LLM 评委看起来客观,但带有许多隐藏偏见,且比人类的偏见更难被发现——因为我们不会主动去审视它。详见 [[#8. Tips and Tricks:已知偏见与缓解|Tips and tricks]] |
|
||||||
|
| **回音室效应**(echo-chamber effect) | 用 LLM 评估 LLM 被类比为制造回音室:以难以察觉的方式不断强化偏见。另外,社会学家用约一个世纪研究出"如何设计统计上稳健的调查问卷来减少人类偏见",而 LLM prompt 设计还没有这么成熟 |
|
||||||
|
| **产生海量待检数据** | 可扩展的同时也制造了大量人工数据,这些数据本身又需要被检验质量(例如让评委先生成思维痕迹/推理过程来提高质量,但这又产生了更多待分析的人工数据) |
|
||||||
|
| **专家质量** | 评委很便宜,但为你的具体场景付费请专家人工标注者,大概率能获得质量更好的结果 |
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 3. 如何开始(⭐ 推荐资源)
|
||||||
|
|
||||||
|
- ⭐ **入门必读**:[HuggingFace Cookbook:LLM as a judge](https://huggingface.co/learn/cookbook/en/llm_judge),作者 Aymeric Roucher,手把手教你搭第一个 LLM 评委。
|
||||||
|
- **[distilabel](https://distilabel.argilla.io/latest/)**(Argilla 出品的库):可用 LLM 生成合成数据并迭代更新。有两个值得参考的 tutorial:
|
||||||
|
- [UltraFeedback 方法复现 tutorial](https://distilabel.argilla.io/latest/sections/pipeline_samples/papers/ultrafeedback/):应用 [UltraFeedback 论文](https://arxiv.org/abs/2310.01377) 的方法论。
|
||||||
|
- [用 distilabel 做 benchmarking 的 tutorial](https://distilabel.argilla.io/latest/sections/pipeline_samples/examples/benchmarking_with_distilabel/):实现了 **Arena Hard** benchmark。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 4. 如何获取 judge LLM
|
||||||
|
|
||||||
|
原文给出三条路线:用现成通用大模型、用小型专用 judge 模型、自己训练。三者对比如下:
|
||||||
|
|
||||||
|
| 维度 | 通用大模型(generalist) | 小型专用模型(tiny specialized) | 自己训练 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| 典型代表 | Claude / GPT-o;开源侧 Qwen 2.5、Command R+、Llama 3.1-405B | Flow-Judge-v0.1、Prometheus、JudgeLM | 基于偏好数据自建 |
|
||||||
|
| 参数规模 | 大(数十亿 ~ 数千亿) | 通常几十亿(3.8B / 7B / 13B / 7B–33B) | 取决于基座选择 |
|
||||||
|
| 部署 | API(闭源)或模型提供商(开源) | 多数近年消费级硬件可本地运行 | 本地 |
|
||||||
|
| 可复现性 | 闭源有"模型无通知变更"风险 | 高(权重固定、本地运行) | 高 |
|
||||||
|
| 成本 | 按调用付费 | 低 | 数据收集 + 训练算力成本高 |
|
||||||
|
| prompt 要求 | 通用 prompt 设计 | 需遵循特定 prompt 格式 | 自行定义 |
|
||||||
|
| 主要风险 | 黑盒、数据隐私 | 能力上限 | 数据质量、训练成本 |
|
||||||
|
|
||||||
|
### 4.1 路线一:使用通用大模型(generalist LLM)
|
||||||
|
|
||||||
|
随着更强模型(如 ChatGPT)出现,研究者开始探索用大模型当评委。目前最强的大模型评委**多为闭源模型**(如 Claude、GPT-o 系列),但开源模型的差距正在快速缩小——高质量开源候选包括:
|
||||||
|
|
||||||
|
- [Qwen 2.5 系列](https://huggingface.co/collections/Qwen/qwen25-66e81a666513e518adb90d9e)
|
||||||
|
- [Command R+](https://huggingface.co/CohereForAI/c4ai-command-r-plus-08-2024)
|
||||||
|
- [Llama 3.1-405B-Instruct](https://huggingface.co/meta-llama/Llama-3.1-405B-Instruct)
|
||||||
|
|
||||||
|
**闭源模型的缺点**(尽管性能好):
|
||||||
|
|
||||||
|
| 缺点 | 说明 |
|
||||||
|
|---|---|
|
||||||
|
| 运行在 API 之下 | 模型(因此结果)可能**无通知地变更**,伤害评测的可复现性 |
|
||||||
|
| 黑盒 | 不可解释(un-interpretable) |
|
||||||
|
| 数据泄露/隐私风险 | 数据经互联网发给第三方,通常不如本地管理安全;你无法确定数据用途(往往需要手动选择退出被用于训练集) |
|
||||||
|
|
||||||
|
**优点**:任何人都能用上高质量模型,无需本地部署或硬件。而如今大多数高质量开源模型也能通过模型提供商访问,同时解决了上面两个问题(API 变更与黑盒)。
|
||||||
|
|
||||||
|
> 💰 选择模型提供商时可参考成本分析:[ArtificialAnalysis LLM Performance Leaderboard](https://huggingface.co/spaces/ArtificialAnalysis/LLM-Performance-Leaderboard)。
|
||||||
|
|
||||||
|
### 4.2 路线二:使用小型专用 judge 模型(tiny specialized LLM judge)
|
||||||
|
|
||||||
|
通常只有几十亿参数,能在大多数近年消费级硬件上本地运行;可以是从头训练,或用指令数据微调而来。**注意通常需要遵循它们特定的 prompt 格式。**
|
||||||
|
|
||||||
|
原文给出的现有模型:
|
||||||
|
|
||||||
|
| 模型 | 参数规模 | 说明 |
|
||||||
|
|---|---|---|
|
||||||
|
| **Flow-Judge-v0.1**([权重](https://huggingface.co/collections/flowaicom/flow-judge-v01-66e6af5fc3b3a128bde07dec)) | 3.8B | 基于 Phi-3.5-mini-instruct,在合成偏好数据集上微调 |
|
||||||
|
| **Prometheus**([权重](https://huggingface.co/prometheus-eval/prometheus-13b-v1.0),[论文](https://arxiv.org/abs/2310.08491)) | 13B | 在合成偏好数据集上从头训练。另有 [7B 的 v2](https://huggingface.co/prometheus-eval/prometheus-7b-v2.0):基于 Mistral-7B-Instruct-v0.2 在更大的合成偏好数据集上微调,并加入权重合并(weight merging) |
|
||||||
|
| **JudgeLM**([论文](https://arxiv.org/abs/2310.17631)) | 7B ~ 33B | 在多种模型生成的合成偏好数据集上从头训练 |
|
||||||
|
|
||||||
|
### 4.3 路线三:训练你自己的 judge LLM
|
||||||
|
|
||||||
|
**第一步:收集偏好数据(preference data)**,来源可以是:
|
||||||
|
|
||||||
|
- 现成的**人类偏好数据集**,例如 [LMSYS Chatbot Arena(Kaggle 竞赛)](https://www.kaggle.com/competitions/lmsys-chatbot-arena);
|
||||||
|
- **模型生成的偏好数据**(可按上述小型 judge 模型论文的数据章节生成,或直接取现成集合):
|
||||||
|
- [Prometheus Preference Collection](https://huggingface.co/datasets/prometheus-eval/Preference-Collection)
|
||||||
|
- [Prometheus Feedback Collection](https://huggingface.co/datasets/prometheus-eval/Feedback-Collection)
|
||||||
|
|
||||||
|
**第二步:决定起点**,可以选择:
|
||||||
|
|
||||||
|
1. 从零开始,用一个小模型**从头训练(train from scratch)**;
|
||||||
|
2. 从现成模型出发:
|
||||||
|
- **蒸馏(distill)** 到更小的新模型;
|
||||||
|
- **量化(quantize)**;
|
||||||
|
- 然后用上面的数据**微调(fine-tune)**——模型大、算力低时用 PEFT 或 adapter 权重。
|
||||||
|
- 💡 一个社区经验:[从 reward model 出发微调,比从 instruct model 出发效果更好](https://x.com/dk21/status/1826292289930674590)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 5. 如何设计评测 prompt(evaluation prompt)
|
||||||
|
|
||||||
|
### 5.1 通用设计要点
|
||||||
|
|
||||||
|
设计 prompt 的四条通用准则(原文整理自网络):
|
||||||
|
|
||||||
|
1. **清晰描述任务**:
|
||||||
|
- `Your task is to do X`(你的任务是做 X)
|
||||||
|
- `You will be provided with Y`(你将获得 Y)
|
||||||
|
2. **给出清晰的评测标准**,需要时附带详细的打分系统:
|
||||||
|
- `You should evaluate property Z on a scale of 1 - 5, where 1 means ...`(请在 1–5 刻度上评估属性 Z,1 表示……)
|
||||||
|
- `You should evaluate if property Z is present in the sample Y. Property Z is present if ...`(请评估样本 Y 中是否存在属性 Z。属性 Z 存在当且仅当……)
|
||||||
|
3. **给出额外的"推理"步骤**:
|
||||||
|
- `To judge this task, you must first make sure to read sample Y carefully to identify ..., then ...`(评判前必须先仔细阅读样本 Y 以识别……,然后……)
|
||||||
|
4. **指定输出格式**(加字段有助于一致性):
|
||||||
|
- `Your answer should be provided in JSON, with the following format {"Score": Your score, "Reasoning": The reasoning which led you to this score}`(用 JSON 输出:{"Score": 你的分数, "Reasoning": 得出该分数的推理})
|
||||||
|
|
||||||
|
可以直接借鉴的现成模板:
|
||||||
|
|
||||||
|
- [MixEval judge prompts(lighteval 实现)](https://github.com/huggingface/lighteval/blob/main/src/lighteval/tasks/extended/mix_eval/judge_prompts.pyy)
|
||||||
|
- [MTBench judge prompt templates(lighteval 实现)](https://github.com/huggingface/lighteval/blob/main/src/lighteval/tasks/extended/mt_bench/judge_prompt_templates.py)
|
||||||
|
|
||||||
|
这四条准则与"一份好 judge prompt 的要素"的对应关系:
|
||||||
|
|
||||||
|
| 准则 | 在 prompt 中的位置 | 作用 |
|
||||||
|
|---|---|---|
|
||||||
|
| 任务描述(Your task is to do X / You will be provided with Y) | 开头 | 明确"评什么、输入是什么" |
|
||||||
|
| 评测标准 + 详细刻度(scale 1–5,1 表示……) | 中间 | 给出可操作的评分依据,即**评分锚点** |
|
||||||
|
| 额外推理步骤(must first read … then …) | 标准之后 | 引导先分析后下结论,改善准确性 |
|
||||||
|
| 输出格式(JSON:Score / Reasoning) | 结尾 | 结构化输出,提升一致性,便于程序解析 |
|
||||||
|
|
||||||
|
### 5.2 其他设计要点
|
||||||
|
|
||||||
|
- **Pairwise(成对比较)比打分更稳健**:与人类偏好的相关性更高([论文](https://arxiv.org/abs/2403.16950))。
|
||||||
|
- 如果确实需要分数,**用整数刻度**,并确保**详细解释每个分数代表什么**([Seungone Kim 的推文](https://x.com/seungonekim/status/1749289437165769177));或者用 **additive prompt**(累加式打分):"答案具备这个特征给 1 分,再具备某个特征加 1 分……"。
|
||||||
|
- **每个能力用一个 prompt 单独打分**,结果通常更好、更稳健(one prompt per capability)。
|
||||||
|
|
||||||
|
### 5.3 提升判断准确度的技巧(可能更贵)
|
||||||
|
|
||||||
|
| 技巧 | 说明 | 代价/备注 |
|
||||||
|
|---|---|---|
|
||||||
|
| **Few-shot 示例** | 和许多任务一样,给示例有助于推理 | 增加上下文长度 |
|
||||||
|
| **Reference(参考答案)** | 有参考时把参考也放进 prompt,能提升准确度 | 需要参考存在 |
|
||||||
|
| **CoT(思维链)** | 让模型**先输出推理过程、再给分数**,可提升准确度([论文](https://arxiv.org/abs/2212.08073),另有 [观察](https://x.com/seungonekim/status/1749289437165769177)) | 输出变长 |
|
||||||
|
| **多轮分析(Multiturn analysis)** | 可改进**事实性错误检测**([论文](https://arxiv.org/abs/2305.13281)) | 上下文更长 |
|
||||||
|
| **陪审团(Jury)** | 用多个评委并聚合答案,比单个模型效果好([论文](https://arxiv.org/abs/2404.18796)) | 成本可通过"多个小模型替代一个大模型"大幅降低;也可试同一个模型、变化 temperature |
|
||||||
|
| **加筹码(stakes)** | 社区意外发现:在 prompt 里加"答对了给你一只小猫"(`answer correctly and you'll get a kitten`)能提高正确率 | 效果因人而异,按需调整 |
|
||||||
|
|
||||||
|
### 5.4 Prompt 模板示例
|
||||||
|
|
||||||
|
以下模板示例是根据本节指南要点组合而成(非原文逐字内容),演示 pointwise 打分、pairwise 比较、累加式评分与 CoT 的结构:
|
||||||
|
|
||||||
|
**① 点式打分 + 详细刻度锚点 + JSON 输出(pointwise scoring prompt)**
|
||||||
|
|
||||||
|
```text
|
||||||
|
Your task is to evaluate the fluency of a model-generated answer.
|
||||||
|
You will be provided with the answer below.
|
||||||
|
|
||||||
|
Evaluation criteria:
|
||||||
|
You should evaluate the property "fluency" on an integer scale of 1 to 5:
|
||||||
|
- 1: completely un-understandable
|
||||||
|
- 2: many errors, hard to follow
|
||||||
|
- 3: understandable with some errors
|
||||||
|
- 4: mostly fluent, minor issues
|
||||||
|
- 5: perfectly fluent
|
||||||
|
|
||||||
|
Reasoning steps:
|
||||||
|
To judge this task, you must first read the answer carefully, identify any
|
||||||
|
grammatical or coherence issues, then decide on a final score.
|
||||||
|
|
||||||
|
Output format:
|
||||||
|
Your answer should be provided in JSON, with the following format:
|
||||||
|
{"Score": Your score, "Reasoning": The reasoning which led you to this score}
|
||||||
|
```
|
||||||
|
|
||||||
|
**② 成对比较(pairwise comparison prompt)**
|
||||||
|
|
||||||
|
```text
|
||||||
|
Your task is to compare two model answers A and B for the property "helpfulness".
|
||||||
|
You will be provided with both answers.
|
||||||
|
|
||||||
|
You should decide which answer is better with respect to helpfulness, or
|
||||||
|
whether they are tied.
|
||||||
|
|
||||||
|
Reasoning steps:
|
||||||
|
First read both answers carefully and list the strengths/weaknesses of each
|
||||||
|
with respect to helpfulness, then give your verdict.
|
||||||
|
|
||||||
|
Output format:
|
||||||
|
{"Verdict": "A" | "B" | "Tie", "Reasoning": ...}
|
||||||
|
```
|
||||||
|
|
||||||
|
**③ 累加式评分(additive scoring prompt,适合不信任笼统刻度的场景)**
|
||||||
|
|
||||||
|
```text
|
||||||
|
Score the answer by adding points:
|
||||||
|
- The answer directly addresses the question: +1 point
|
||||||
|
- The answer includes concrete examples: +1 additional point
|
||||||
|
- The answer is free of factual errors: +1 additional point
|
||||||
|
Report the total as the final score.
|
||||||
|
```
|
||||||
|
|
||||||
|
**④ 先推理后打分(CoT before the score)**
|
||||||
|
|
||||||
|
```text
|
||||||
|
Before providing the score, explain step by step how the answer performs on
|
||||||
|
each evaluation criterion. Only after this reasoning, output the final score
|
||||||
|
in the requested JSON format.
|
||||||
|
```
|
||||||
|
|
||||||
|
**⑤ 带参考答案(reference)的打分**(有 reference 时增强准确度)
|
||||||
|
|
||||||
|
```text
|
||||||
|
Your task is to evaluate the answer against a reference answer.
|
||||||
|
You will be provided with the candidate answer and the reference.
|
||||||
|
|
||||||
|
The reference answer represents the ground truth for this prompt.
|
||||||
|
|
||||||
|
Evaluation criteria:
|
||||||
|
You should evaluate whether the candidate answer is faithful to the reference,
|
||||||
|
on an integer scale of 1 to 5 (1 = completely unrelated, 5 = fully faithful).
|
||||||
|
|
||||||
|
Output format:
|
||||||
|
{"Score": Your score, "Reasoning": The reasoning which led you to this score}
|
||||||
|
```
|
||||||
|
|
||||||
|
**⑥ Few-shot 示例**(给 1–2 个"已评好分"的例子帮助推理;代价是上下文变长)
|
||||||
|
|
||||||
|
```text
|
||||||
|
Your task is to score answers on the property "fluency" (scale 1-5).
|
||||||
|
|
||||||
|
Example 1:
|
||||||
|
Answer: "The cat sat on the mat."
|
||||||
|
Score: 5
|
||||||
|
|
||||||
|
Example 2:
|
||||||
|
Answer: "Cat sat mat."
|
||||||
|
Score: 3
|
||||||
|
|
||||||
|
Now score the following answer, following the same criteria and output format
|
||||||
|
as above.
|
||||||
|
```
|
||||||
|
|
||||||
|
**⑦ 属性是否存在(二分类风格)**——适合"该属性在样本 Y 中是否出现"式评测
|
||||||
|
|
||||||
|
```text
|
||||||
|
Your task is to evaluate if the property "toxicity" is present in the sample Y.
|
||||||
|
|
||||||
|
Property "toxicity" is present if the text contains insults, threats, or
|
||||||
|
harmful language.
|
||||||
|
|
||||||
|
Reasoning steps:
|
||||||
|
Read the sample carefully, check each phrase against the definition above,
|
||||||
|
then decide.
|
||||||
|
|
||||||
|
Output format:
|
||||||
|
{"Toxicity": "present" | "absent", "Reasoning": ...}
|
||||||
|
```
|
||||||
|
|
||||||
|
**⑧ 陪审团(jury)聚合示意**(多评委 → 聚合,效果优于单个模型;可多个小模型,或同模型多 temperature)
|
||||||
|
|
||||||
|
```text
|
||||||
|
# 伪代码(非 prompt):
|
||||||
|
judges = [judge_model_1, judge_model_2, ..., judge_model_N]
|
||||||
|
verdicts = [j(prompt) for j in judges]
|
||||||
|
final = aggregate(verdicts) # 多数票 / 平均分
|
||||||
|
```
|
||||||
|
|
||||||
|
**模板选型速查**:
|
||||||
|
|
||||||
|
| 场景 | 推荐模板 |
|
||||||
|
|---|---|
|
||||||
|
| 需要一个绝对分数 | ① 点式打分 + 详细刻度锚点(整数刻度) |
|
||||||
|
| 刻度不可信 / 想拆分评分标准 | ③ 累加式评分(additive) |
|
||||||
|
| 选"哪个更好" | ② 成对比较(含 Tie) |
|
||||||
|
| 有参考答案可用 | ⑤ 带 reference 的打分 |
|
||||||
|
| 模型理解不了抽象标准 | ⑥ few-shot 示例 |
|
||||||
|
| 只关心属性有无(如毒性) | ⑦ 属性存在性判断 |
|
||||||
|
| 追求稳健、成本允许 | ⑧ 陪审团聚合 |
|
||||||
|
|
||||||
|
### 5.5 一个方法论提醒(社会学视角)
|
||||||
|
|
||||||
|
如果**高风险场景**、且把 evaluator 当作人类标注者的替代品,应当参考社会学里"如何设计好问卷"的研究成果,并计算类似的指标(如**标注者间一致性 inter-annotator agreement**),用正确的调查设计方法减少偏见。
|
||||||
|
|
||||||
|
但原文也坦率指出:**大多数人不追求可复现、高质量、无偏的评测**,一个"差不多能用的 prompt + 快速粗糙的评测"就够用了——这完全 OK,取决于后果的严重程度。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 6. 如何评估你的 evaluator(evaluating your evaluator)
|
||||||
|
|
||||||
|
在把 judge-LLM 投入生产或大规模使用前,先评估它在**你的任务**上的质量。
|
||||||
|
|
||||||
|
> ⚠️ 提醒:如果 evaluator 输出**二分类**结果,可以用可解释的分类指标(accuracy / recall / precision);如果输出**刻度分数**,评估它与参考的相关性会**困难得多**。
|
||||||
|
|
||||||
|
### 6.1 第一步:挑选 baseline(基线)
|
||||||
|
|
||||||
|
把你的 evaluator 判断与某个基线比较。基线可以是:
|
||||||
|
|
||||||
|
- 人类标注(human annotations)
|
||||||
|
- 另一个你确信在你任务上高质量的 judge 模型
|
||||||
|
- 金标准(gold truth)
|
||||||
|
- 同一个模型配另一个 prompt
|
||||||
|
|
||||||
|
**样本量不需要很大(50 条可能就够),但样本必须**:
|
||||||
|
|
||||||
|
- 对你任务**极具代表性**;
|
||||||
|
- **有判别力**(尤其要覆盖边缘情况 edge cases);
|
||||||
|
- 质量**尽可能高**。
|
||||||
|
|
||||||
|
### 6.2 第二步:挑选 metric(指标)
|
||||||
|
|
||||||
|
用指标比较你的 judge 评价与参考(reference):
|
||||||
|
|
||||||
|
- **二分类(binary)**:计算 precision、recall——最易解释。
|
||||||
|
- **成对比较(pairwise)**:计算 accuracy——很易解释。
|
||||||
|
- **分数相关性(score correlation)**:难做。为何难、如何做,推荐阅读 [Eugene Yan 的博客章节](https://eugeneyan.com/writing/llm-evaluators/#key-considerations-before-adopting-an-llm-evaluator)。
|
||||||
|
|
||||||
|
> ⭐ 不知道什么时候该用哪个模型/指标?看 [Eugene Yan 博客](https://eugeneyan.com/writing/llm-evaluators/) 里的这张[决策树图(llm-eval-tree)](https://eugeneyan.com/assets/llm-eval-tree.jpg)。
|
||||||
|
|
||||||
|
### 6.3 第三步:评估并设定接受阈值
|
||||||
|
|
||||||
|
用你的模型 + prompt 在测试样本上打分,再用 metric 与 baseline 算分,然后决定**接受阈值**。原文给出的经验值:
|
||||||
|
|
||||||
|
| 评测类型 | 常见接受阈值 |
|
||||||
|
|---|---|
|
||||||
|
| 成对比较 accuracy | 视任务难度,**80% ~ 95%** |
|
||||||
|
| 分数相关性(Pearson) | 文献里人们通常对 **0.8** 满意;但也见过论文宣称 **0.3** 就算与人类标注者"良好相关"(所以"视情况而定") |
|
||||||
|
|
||||||
|
### 6.4 把三步骤串起来:一个最小评估流程示例
|
||||||
|
|
||||||
|
把上面三步落地的最小闭环(以"成对比较 + 人类基线"为例):
|
||||||
|
|
||||||
|
```text
|
||||||
|
Step 1 收集基线(baseline)
|
||||||
|
→ 从你的任务里挑 ~50 条高代表性样本(含边缘情况),
|
||||||
|
请人类(或你信赖的 judge)给出成对判断,作为 reference。
|
||||||
|
|
||||||
|
Step 2 让 evaluator 跑分
|
||||||
|
→ 用你的 judge LLM + 设计好的 pairwise prompt 对同一批样本判断。
|
||||||
|
|
||||||
|
Step 3 算指标
|
||||||
|
→ 计算 evaluator 与 reference 的 accuracy。
|
||||||
|
(二分类则算 precision / recall;分数型则算 Pearson 相关性。)
|
||||||
|
|
||||||
|
Step 4 对照阈值决定去留
|
||||||
|
→ pairwise accuracy 低于 80%?换 judge 模型 / 改 prompt / 加 CoT,
|
||||||
|
重复 Step 2-4;达到 80%–95%(视任务难度)即可放行。
|
||||||
|
```
|
||||||
|
|
||||||
|
要点回顾:
|
||||||
|
|
||||||
|
- 样本少没关系(50 条够用),但**代表性 > 数量**;
|
||||||
|
- evaluator 输出**二分类或成对比较**时最容易被评估(accuracy / precision / recall);
|
||||||
|
- 输出**刻度分数**时,"分数与参考的相关性"评估难度明显上升——这是选择输出形式时就要想好的权衡;
|
||||||
|
- 阈值不是铁律:文献对相关性高低的接受范围从 0.3 到 0.8 都有,按你的任务与后果定。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 7. Reward Models(奖励模型)
|
||||||
|
|
||||||
|
### 7.1 什么是 Reward Model
|
||||||
|
|
||||||
|
**Reward model(奖励模型,RM)**:从给定 prompt/completion 对的人类标注中学习预测一个分数,最终目标是让预测与**人类偏好**对齐。训练好后,它可以作为**人类判断的代理(proxy)——即 reward function**,用来改进其他模型(如用于强化学习)。
|
||||||
|
|
||||||
|
它与 judge LLM 的关键区别(对比表):
|
||||||
|
|
||||||
|
| 维度 | Judge LLM | Reward Model |
|
||||||
|
|---|---|---|
|
||||||
|
| 输出 | 长文本(分数 + 推理) | 一个(或一对)分数 |
|
||||||
|
| 使用方式 | 靠 prompt 工程 | 前向传播(forward pass)即出分,免 prompt |
|
||||||
|
| 成本 | 调用大模型生成 | 小模型单次前向,很快 |
|
||||||
|
| 训练 | 通常不训练 | 需要专门微调 |
|
||||||
|
|
||||||
|
### 7.2 两类打分方式
|
||||||
|
|
||||||
|
**① 成对分数(pairwise score)——最常见的类型**
|
||||||
|
|
||||||
|
最典型的是 **Bradley-Terry 模型**,输出单个分数,遵循:
|
||||||
|
|
||||||
|
```
|
||||||
|
p(completion b is better than completion a) = sigmoid(score_b − score_a)
|
||||||
|
```
|
||||||
|
|
||||||
|
即:完成 b 优于完成 a 的概率 = sigmoid(b 的分数 − a 的分数)。
|
||||||
|
|
||||||
|
- 只用**成对比较**训练——比收集分数更容易;
|
||||||
|
- 局限:只能比较**同一 prompt 下的多个 completion**,无法跨 prompt 比较。
|
||||||
|
|
||||||
|
其他模型在此基础上扩展,预测"一个完成优于另一个"的更细致概率(如 [RLHFlow/pair-preference-model-LLaMA3-8B](https://huggingface.co/RLHFlow/pair-preference-model-LLaMA3-8B)):
|
||||||
|
|
||||||
|
- 理论上能判别完成之间的细微差异;
|
||||||
|
- 代价:不易保存、比较同一测试集上跨 prompt 的许多分数;
|
||||||
|
- 另外,比较过长的 completion 时上下文长度与内存会成为问题。
|
||||||
|
|
||||||
|
**② 绝对分数(absolute score)**
|
||||||
|
|
||||||
|
- 例如 [SteerLM](https://arxiv.org/abs/2311.09528) 直接输出绝对分数,无需成对比较即可评估 completion;
|
||||||
|
- 评测时**更易用**,但**数据更难收集**——人类偏好中绝对分数往往不如成对分数稳定。
|
||||||
|
- 近期还出现了**同时输出绝对与相对分数**的模型,如 [HelpSteer2-Preference](https://arxiv.org/abs/2410.01257) 与 [ArmoRM](https://arxiv.org/abs/2406.12845)。
|
||||||
|
|
||||||
|
### 7.3 如何用 Reward Model 做评测
|
||||||
|
|
||||||
|
流程:给定 prompt 数据集 → 从语言模型生成 completions → 让 reward model 打分。
|
||||||
|
|
||||||
|
- **绝对分数模型**:对多个分数取平均,得到合理的汇总分数。
|
||||||
|
- **相对分数模型(更常见)**:直接平均 reward 会**被离群值(outliers)偏置**——因为不同 prompt 天生就有不同的 reward 刻度(有些 prompt 难、有些简单)。替代方案:
|
||||||
|
- **Win rates(胜率)**:取一个参考 completion 集合,计算"模型输出排在参考输出之上"的百分比。粒度略细。
|
||||||
|
- **Win probabilities(胜率概率)**:模型输出优于参考输出的平均概率,能给出更细粒度、更平滑的信号。
|
||||||
|
|
||||||
|
完整流程示意:
|
||||||
|
|
||||||
|
```text
|
||||||
|
prompt 数据集
|
||||||
|
│
|
||||||
|
▼
|
||||||
|
语言模型生成 completions(被测模型)
|
||||||
|
│
|
||||||
|
▼
|
||||||
|
reward model 打分
|
||||||
|
│
|
||||||
|
├── 绝对分数型 → 取平均 → 汇总分数
|
||||||
|
│
|
||||||
|
└── 相对分数型 → win rates(胜率)/ win probabilities(胜率概率)
|
||||||
|
│
|
||||||
|
└── 与参考 completions 集合对比
|
||||||
|
```
|
||||||
|
|
||||||
|
| 汇总方式 | 定义 | 特点 |
|
||||||
|
|---|---|---|
|
||||||
|
| 直接平均 reward(相对分数型) | 把所有分数的均值当汇总 | **会被离群值偏置**——不同 prompt 有不同 reward 刻度(有的 prompt 天生更难/更易) |
|
||||||
|
| win rates | 模型输出高于参考集合的**百分比** | 比平均更稳健,粒度略细 |
|
||||||
|
| win probabilities | 优于参考集合的**平均概率** | 更细粒度、更平滑的信号 |
|
||||||
|
|
||||||
|
### 7.4 Reward Model 的优缺点
|
||||||
|
|
||||||
|
| 优点 | 缺点 |
|
||||||
|
|---|---|
|
||||||
|
| **非常快**:打分 = 对小模型做一次前向传播(只出分数,不像 judge-LLM 出长文本) | **需要专门微调**:这一步可能相当贵;虽继承基座模型许多能力,但在训练分布之外的任务上可能表现差 |
|
||||||
|
| **确定性**:同一前向传播必然复现同样分数 | **RL 与评测复用时的效率损失**:语言模型可能过拟合到 reward model 的偏好上(当 RL 或直接对齐算法用的数据与 RM 训练数据相似时尤甚) |
|
||||||
|
| **不易受位置偏差影响**:多数 RM 只吃一个 completion,不受顺序影响;成对模型只要训练数据在"最优答案是第一/第二个"上均衡,位置偏差通常也极小 | |
|
||||||
|
| **免 prompt 工程**:直接按训练时的偏好数据输出分数 | |
|
||||||
|
|
||||||
|
### 7.5 使用 Reward Model 做评测的 Tips
|
||||||
|
|
||||||
|
- 找高性能模型的好去处:**[RewardBench Leaderboard](https://huggingface.co/spaces/allenai/reward-bench)** ⭐。
|
||||||
|
- 参考 [Nemotron 论文](https://arxiv.org/abs/2406.11704) 中 RM 的使用方式。
|
||||||
|
- 对"单 prompt + completion"打分的 RM:可以**缓存许多参考模型的分数**,之后轻松对比新模型的表现。
|
||||||
|
- **训练过程中跟踪 win rate / win probability**(如[这篇近期论文](https://arxiv.org/abs/2410.11677v1)),可用来**检测模型退化(degradation)并挑选最优 checkpoint**。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 8. Tips and Tricks:已知偏见与缓解
|
||||||
|
|
||||||
|
LLM 评委的**已知偏见清单**(原文逐条整理,含缓解方法):
|
||||||
|
|
||||||
|
| 偏见 | 现象 | 缓解方法 |
|
||||||
|
|---|---|---|
|
||||||
|
| **缺乏内部一致性**(Lack of internal consistency) | 温度不为 0 时,同一 judge 多次 prompt 会给出不同判断 | **self-consistency prompting**:多次 prompt,取多数票(majority output) |
|
||||||
|
| **自偏好**(Self-preference) | 打分时倾向于[偏爱自己的输出](https://arxiv.org/abs/2404.13076) | 使用**陪审团(jury)** |
|
||||||
|
| **对输入扰动不敏感**(Blindness to input perturbation) | 模型不擅长识别[被扰动的输入](https://arxiv.org/abs/2406.13439);顺带[不擅长给出一致的分数范围](https://twitter.com/aparnadhinak/status/1748368364395721128)([更完整的实验](https://github.com/LeonEricsson/llmjudge/blob/main/README.md))。例如按一致刻度给文本加噪声后要求排序,预测分数并不会反映该刻度 | ① 让模型**先解释推理、再给分数**([推文](https://twitter.com/seungonekim/status/1749289437165769177));② 在 prompt 中提供**连贯的评分刻度** |
|
||||||
|
| **位置偏差**(Position-bias) | 倾向[偏爱特定答案位置](https://arxiv.org/abs/2306.05685):如 Claude 与 GPT-3.5 在成对比较时相当系统性地偏好第一个或第二个选项 | ① **随机交换**答案位置;② 计算所有可能选项的 **log-probability** 得到归一化答案 |
|
||||||
|
| **冗长/长度偏差**(Verbosity-bias / length-bias) | 更偏爱更啰嗦(verbose)的答案 | 在评估中[考虑答案长度的差异](https://arxiv.org/abs/2404.04475) |
|
||||||
|
| **与人类一致性存疑**(Debatable consistency with humans) | 与人类答案的一致性[存疑](https://arxiv.org/abs/2308.15812) | 反向提醒:**[非专家人类也未必是所有评估的好基线](https://arxiv.org/abs/2202.06935)**——在医学、法律、数学等特定领域,用非专家人类标注者和直接用 LLM 一样不靠谱 |
|
||||||
|
| **格式偏差**(Format bias) | 若 prompt 格式[偏离训练时的格式太远](https://arxiv.org/abs/2310.17631),评估会失准。例:训练为"成对比较 + 附参考答案"的模型,不提供参考就失败;反之亦然 | **注意训练 prompt 格式**(若模型做过指令微调),确保严格遵循 |
|
||||||
|
|
||||||
|
### 8.1 哪些任务不适合交给 LLM judge
|
||||||
|
|
||||||
|
- **幻觉检测整体很弱**,尤其**部分幻觉(partial hallucinations)**——看起来接近真值、其实略有出入的幻觉(见[论文 1](https://arxiv.org/abs/2305.11747)、[论文 2](https://arxiv.org/abs/2303.08896))。
|
||||||
|
- 与人类标注者在以下任务上相关性只有 **低 ~ 中等**:
|
||||||
|
- **摘要(summarization)**([论文 1](https://arxiv.org/abs/2304.02554)、[论文 2](https://arxiv.org/abs/2303.16634));
|
||||||
|
- **忠实度(faithfulness)**([论文](https://arxiv.org/abs/2307.16877));
|
||||||
|
- 更广地看,跨[一系列任务](https://arxiv.org/abs/2406.18403)与人类判断并非持续相关。
|
||||||
|
|
||||||
|
### 8.2 设计"少偏见"评测的检查清单
|
||||||
|
|
||||||
|
把上一节的缓解方法汇总成一张实操清单,上线评测前逐项核对:
|
||||||
|
|
||||||
|
- [ ] **一致性**:固定 seed / 温度设为 0;或对同一 judge 多次采样、取多数票(self-consistency)
|
||||||
|
- [ ] **位置偏差**:成对比较时随机交换答案位置;必要时计算所有选项的 log-probability 归一化
|
||||||
|
- [ ] **自偏好**:使用陪审团(多个评委聚合),而不是单一模型
|
||||||
|
- [ ] **扰动盲区**:要求"先推理、后给分";prompt 中提供连贯的评分刻度锚点
|
||||||
|
- [ ] **冗长偏差**:比较时考虑双方答案的长度差异
|
||||||
|
- [ ] **格式偏差**:严格遵循所选模型(尤其指令微调模型)训练时的 prompt 格式
|
||||||
|
- [ ] **任务适配**:对幻觉(尤其部分幻觉)、摘要、忠实度等已知弱项任务谨慎使用
|
||||||
|
- [ ] **方法论**:高风险场景按社会调查标准设计——如计算标注者间一致性(inter-annotator agreement)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 9. 常见误区与 FAQ
|
||||||
|
|
||||||
|
**Q1:用 LLM 当评委,是不是就一定客观、无偏?**
|
||||||
|
不是。它看起来客观,但隐藏偏见更难被发现(我们不会主动审视它);用 LLM 评估 LLM 还被类比为制造回音室效应。详见第 2、8 节。
|
||||||
|
|
||||||
|
**Q2:打分(pointwise)是不是比成对比较(pairwise)更好用?**
|
||||||
|
原文给出的证据恰恰相反:**pairwise 与人类偏好的相关性更高、更稳健**。如果你确实需要绝对分数,务必用整数刻度 + 详细解释每个分数代表什么,或改用 additive 累加式评分。
|
||||||
|
|
||||||
|
**Q3:大模型评委是不是永远比小模型好?**
|
||||||
|
最强评委目前多为闭源大模型,但它们是黑盒、运行在 API 下且结果可能无通知变更,还涉及数据隐私。开源大模型的差距正在快速缩小;小型专用模型(Flow-Judge-v0.1、Prometheus、JudgeLM)可本地运行、可复现、便宜,且 jury 场景下"多个小模型"能大幅降低比"一个大模型"的成本。
|
||||||
|
|
||||||
|
**Q4:我能直接用 reward model 的平均分做汇总吗?**
|
||||||
|
只有**绝对分数型** RM 可以直接取平均。**相对分数型**(如 Bradley-Terry)直接平均会被离群值偏置(不同 prompt 的 reward 刻度不同),应当改用 win rates(胜率)或 win probabilities(胜率概率)。
|
||||||
|
|
||||||
|
**Q5:LLM judge 是不是什么任务都能评?**
|
||||||
|
不是。它在幻觉检测上整体很弱(尤其部分幻觉),在摘要、忠实度上对人类的相关性只有低~中等,跨任务也并非持续与人类判断相关。选任务前先看第 8.1 节。
|
||||||
|
|
||||||
|
**Q6:分数相关性 0.3 算不算合格?**
|
||||||
|
看文献:有人对 0.8 的 Pearson 相关才满意,也有人宣称 0.3 就算与人类标注者"良好相关"。阈值取决于你的任务难度与后果——这正是"评估你的 evaluator"这一步的意义。
|
||||||
|
|
||||||
|
**Q7:用小型 judge 模型时,prompt 格式重要吗?**
|
||||||
|
重要。格式偏差(format bias)会导致评估失准:例如训练为"成对比较 + 附参考答案"的模型,不提供参考就失败,反之亦然。务必遵循模型训练时的 prompt 格式。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 10. 速查表:全章要点一页纸
|
||||||
|
|
||||||
|
1. **Judge LLM = 用 LLM + prompt 评估其他模型输出**;三大任务:打分(pointwise)、成对比较(pairwise)、相似度。
|
||||||
|
2. **优点**:客观、可扩展、便宜、与人类判断相关;**缺点**:隐藏偏见、回音室效应、数据质量负担、专家质量不如真人。
|
||||||
|
3. **获取路线**:通用大模型(闭源最强但黑盒/API 不稳,开源差距快速缩小)→ 小型专用模型(Flow-Judge-v0.1 3.8B / Prometheus 13B·7B / JudgeLM 7B–33B)→ 自己训练(人类或合成偏好数据;蒸馏/量化/微调;从 reward model 出发更佳)。
|
||||||
|
4. **Prompt 设计**:任务描述 + 详细标准/刻度 + 推理步骤 + 指定 JSON 输出格式;pairwise 优于打分;整数刻度要配"每分代表什么"或 additive prompt;一能力一 prompt。
|
||||||
|
5. **提升准确度**:few-shot、reference、CoT(先推理后分数)、multiturn、jury(多评委聚合)、加 stakes("答对给小猫")。
|
||||||
|
6. **评估你的 evaluator**:50 条高代表性样本作 baseline;二分类/pairwise 用 accuracy/precision/recall,分数用相关性(Pearson);阈值参考:pairwise 80–95%,相关性 0.8(0.3 也有人接受)。
|
||||||
|
7. **Reward Model**:Bradley-Terry 成对评分 vs SteerLM 绝对评分(HelpSteer2-Preference / ArmoRM 双输出);相对分数用 win rates / win probabilities 而非平均;快、确定性、少位置偏差、免 prompt,但需专门微调、RL 复用有 overfit 风险;模型找 RewardBench,用法参考 Nemotron。
|
||||||
|
8. **已知偏见**:内部不一致 → self-consistency;自偏好 → jury;扰动盲 → 先推理后评分 + 连贯刻度;位置偏差 → 随机换位 + log-prob 归一化;冗长偏差 → 控制长度差异;格式偏差 → 严格遵循训练格式。
|
||||||
|
9. **慎用场景**:幻觉(尤其部分幻觉)、摘要、忠实度——相关性低或一般。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 11. 参考资料
|
||||||
|
|
||||||
|
### 原文(本笔记对应源文件)
|
||||||
|
|
||||||
|
- [basics.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/model-as-a-judge/basics.md)
|
||||||
|
- [getting-a-judge-llm.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/model-as-a-judge/getting-a-judge-llm.md)
|
||||||
|
- [designing-your-evaluation-prompt.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/model-as-a-judge/designing-your-evaluation-prompt.md)
|
||||||
|
- [evaluating-your-evaluator.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/model-as-a-judge/evaluating-your-evaluator.md)
|
||||||
|
- [what-about-reward-models.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/model-as-a-judge/what-about-reward-models.md)
|
||||||
|
- [tips-and-tricks.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/model-as-a-judge/tips-and-tricks.md)
|
||||||
|
|
||||||
|
### ⭐ 推荐阅读
|
||||||
|
|
||||||
|
- [HuggingFace Cookbook:LLM as a judge(Aymeric Roucher)](https://huggingface.co/learn/cookbook/en/llm_judge) ⭐
|
||||||
|
- [Eugene Yan:LLM Evaluators 博客](https://eugeneyan.com/writing/llm-evaluators/) ⭐(含 [决策树图](https://eugeneyan.com/assets/llm-eval-tree.jpg))
|
||||||
|
- [RewardBench Leaderboard](https://huggingface.co/spaces/allenai/reward-bench)
|
||||||
|
|
||||||
|
### 论文
|
||||||
|
|
||||||
|
- [UltraFeedback(2310.01377)](https://arxiv.org/abs/2310.01377)
|
||||||
|
- [Prometheus(2310.08491)](https://arxiv.org/abs/2310.08491)
|
||||||
|
- [JudgeLM(2310.17631)](https://arxiv.org/abs/2310.17631)
|
||||||
|
- [MT-Bench / Chatbot Arena:Judging LLM-as-a-Judge(2306.05685v4,通用大模型评委与位置偏差)](https://arxiv.org/abs/2306.05685v4)
|
||||||
|
- [小模型偏好判别(2405.01535)](https://arxiv.org/abs/2405.01535)
|
||||||
|
- [Pairwise 优于打分(2403.16950)](https://arxiv.org/abs/2403.16950)
|
||||||
|
- [CoT 提升准确度(2212.08073)](https://arxiv.org/abs/2212.08073)
|
||||||
|
- [多轮分析提升事实错误检测(2305.13281)](https://arxiv.org/abs/2305.13281)
|
||||||
|
- [Jury(多评委聚合,2404.18796)](https://arxiv.org/abs/2404.18796)
|
||||||
|
- [Self-preference(2404.13076)](https://arxiv.org/abs/2404.13076)
|
||||||
|
- [输入扰动盲区(2406.13439)](https://arxiv.org/abs/2406.13439)
|
||||||
|
- [位置偏差(2306.05685)](https://arxiv.org/abs/2306.05685)
|
||||||
|
- [Verbosity bias 与长度控制(2404.04475)](https://arxiv.org/abs/2404.04475)
|
||||||
|
- [Judge 与人类一致性存疑(2308.15812)](https://arxiv.org/abs/2308.15812)
|
||||||
|
- [非专家人类标注者作为基线的争议(2202.06935)](https://arxiv.org/abs/2202.06935)
|
||||||
|
- [格式偏差(2310.17631,同 JudgeLM)](https://arxiv.org/abs/2310.17631)
|
||||||
|
- [部分幻觉检测(2305.11747 / 2303.08896)](https://arxiv.org/abs/2305.11747)
|
||||||
|
- [摘要相关性(2304.02554 / 2303.16634)](https://arxiv.org/abs/2304.02554)
|
||||||
|
- [忠实度相关性(2307.16877)](https://arxiv.org/abs/2307.16877)
|
||||||
|
- [跨任务与人类一致性(2406.18403)](https://arxiv.org/abs/2406.18403)
|
||||||
|
- [Nemotron-4 340B 技术报告(reward model as judge,NVIDIA)](https://research.nvidia.com/publication/2024-06_nemotron-4-340b)
|
||||||
|
- [Nemotron 用 RM 做评测(2406.11704)](https://arxiv.org/abs/2406.11704)
|
||||||
|
- [SteerLM(2311.09528)](https://arxiv.org/abs/2311.09528)
|
||||||
|
- [HelpSteer2-Preference(2410.01257)](https://arxiv.org/abs/2410.01257)
|
||||||
|
- [ArmoRM(2406.12845)](https://arxiv.org/abs/2406.12845)
|
||||||
|
- [训练中跟踪 win rate 检测退化(2410.11677v1)](https://arxiv.org/abs/2410.11677v1)
|
||||||
|
|
||||||
|
### 模型与数据集
|
||||||
|
|
||||||
|
- [Flow-Judge-v0.1 权重集合](https://huggingface.co/collections/flowaicom/flow-judge-v01-66e6af5fc3b3a128bde07dec)
|
||||||
|
- [Prometheus-13B-v1.0](https://huggingface.co/prometheus-eval/prometheus-13b-v1.0) / [Prometheus-7B-v2.0](https://huggingface.co/prometheus-eval/prometheus-7b-v2.0)
|
||||||
|
- [Prometheus Preference Collection](https://huggingface.co/datasets/prometheus-eval/Preference-Collection) / [Feedback Collection](https://huggingface.co/datasets/prometheus-eval/Feedback-Collection)
|
||||||
|
- [RLHFlow pair-preference-model-LLaMA3-8B](https://huggingface.co/RLHFlow/pair-preference-model-LLaMA3-8B)
|
||||||
|
- [Qwen 2.5 系列](https://huggingface.co/collections/Qwen/qwen25-66e81a666513e518adb90d9e) / [Command R+](https://huggingface.co/CohereForAI/c4ai-command-r-plus-08-2024) / [Llama 3.1-405B-Instruct](https://huggingface.co/meta-llama/Llama-3.1-405B-Instruct)
|
||||||
|
- [LMSYS Chatbot Arena 人类偏好数据集(Kaggle)](https://www.kaggle.com/competitions/lmsys-chatbot-arena)
|
||||||
|
|
||||||
|
### 工具与教程
|
||||||
|
|
||||||
|
- [distilabel](https://distilabel.argilla.io/latest/)([UltraFeedback tutorial](https://distilabel.argilla.io/latest/sections/pipeline_samples/papers/ultrafeedback/) / [benchmarking with distilabel(Arena Hard)](https://distilabel.argilla.io/latest/sections/pipeline_samples/examples/benchmarking_with_distilabel/))
|
||||||
|
- [lighteval:MixEval judge prompts](https://github.com/huggingface/lighteval/blob/main/src/lighteval/tasks/extended/mix_eval/judge_prompts.pyy) / [MTBench judge prompt templates](https://github.com/huggingface/lighteval/blob/main/src/lighteval/tasks/extended/mt_bench/judge_prompt_templates.py)
|
||||||
|
- [ArtificialAnalysis LLM Performance Leaderboard(成本对比)](https://huggingface.co/spaces/ArtificialAnalysis/LLM-Performance-Leaderboard)
|
||||||
|
- [LeonEricsson/llmjudge(扰动敏感度扩展实验)](https://github.com/LeonEricsson/llmjudge/blob/main/README.md)
|
||||||
|
|
||||||
|
### 社区推文
|
||||||
|
|
||||||
|
- [Seungone Kim:先推理后打分 / 分数刻度锚点](https://x.com/seungonekim/status/1749289437165769177)
|
||||||
|
- [Aparna Dhinakaran:分数范围一致性](https://twitter.com/aparnadhinak/status/1748368364395721128)
|
||||||
|
- [从 reward model 出发微调 judge 更好](https://x.com/dk21/status/1826292289930674590)
|
||||||
+402
@@ -0,0 +1,402 @@
|
|||||||
|
---
|
||||||
|
type: reference
|
||||||
|
tags:
|
||||||
|
- llm-evaluation
|
||||||
|
- evaluation-guidebook
|
||||||
|
- troubleshooting
|
||||||
|
status: active
|
||||||
|
created: 2026-08-21
|
||||||
|
source: https://github.com/huggingface/evaluation-guidebook
|
||||||
|
---
|
||||||
|
|
||||||
|
# Troubleshooting(排错)
|
||||||
|
|
||||||
|
> 本页提炼自 [HuggingFace LLM Evaluation Guidebook](https://github.com/huggingface/evaluation-guidebook) 的 **Troubleshooting** 章节(共三小节:推理排错、LaTeX 数学解析、可复现性排错)。这是整本指南中最实操的部分——当评测跑不起来、跑得慢、分数对不上时,先查这里。文内 ⭐ 标记为作者特别推荐的资源。
|
||||||
|
|
||||||
|
## 本节速览(TL;DR)
|
||||||
|
|
||||||
|
| 症状 / 诉求 | 第一反应 | 详见 |
|
||||||
|
|---|---|---|
|
||||||
|
| 评测跑得太慢 | 增大 batch size → 数据并行 → 换推理库 → 降精度 | §1.1 |
|
||||||
|
| 模型太大放不进 GPU | 量化 → 模型并行(pipeline / tensor)→ CPU offloading | §1.2 |
|
||||||
|
| 装得下却 OOM | 怀疑 context size,用 dummy 数据测试 | §1.3 |
|
||||||
|
| 数学评测分数异常偏低 | 检查 LaTeX 解析器(sympy 自洽只有 0.94) | §2 |
|
||||||
|
| 复现不出论文分数 | 逐项对齐:代码库 / seed / 指标 / normalization / prompt / 生成参数 / 加载方式 | §3 |
|
||||||
|
|
||||||
|
> 贯穿全章的三条核心心法:**① 评测工具链本身也是被测对象**——解析器、normalization、指标实现都会系统性改变分数;**② 评测不只是"模型回答问题",而是"在特定环境里跑特定管道"**——环境细节决定一切;**③ 想对比两个分数,先确认它们是不是用同一套管道算出来的。**
|
||||||
|
|
||||||
|
## 1 推理排错(Troubleshooting Inference)
|
||||||
|
|
||||||
|
评测中跑模型推理会遇到三类典型问题:**慢**、**大**(内存装不下)、以及**装得下却 OOM**。本节逐一给出排查思路。先给一张按症状定位的速查表:
|
||||||
|
|
||||||
|
| 症状 | 直接原因 | 对策 | 代价 / 注意 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| 推理慢 | batch size 太小 | 增大 batch size | 破坏绝对可复现性 |
|
||||||
|
| 推理慢 | 只用了单张 GPU | 数据并行(多 GPU) | 需同节点,避免节点间瓶颈 |
|
||||||
|
| 推理慢 | 推理库实现不够优化 | 换更快推理库 / 参考优化清单 | 需要实测 |
|
||||||
|
| 推理慢 | 精度过高 | 降到 `bfloat16`/`float16`,或 8bit/4bit 量化 | 精度损失,部分量化库本身偏慢 |
|
||||||
|
| 模型太大 | 精度过高 | 量化 | 中规模模型建议停在 `float16`/8bit |
|
||||||
|
| 模型太大 | 单卡放不下 | 模型并行 / CPU offloading | 并行较难编码;offloading 显著更慢 |
|
||||||
|
| 装得下却 OOM | context size 过大 | dummy 测试 + 降 batch + 逆序呈现样本 | 让失败尽早暴露 |
|
||||||
|
|
||||||
|
### 1.1 模型太慢怎么办
|
||||||
|
|
||||||
|
#### ① 修改 batch size
|
||||||
|
|
||||||
|
- 如果你追求**绝对可复现**(给定特定硬件与特定评测 prompt),通常只能用 batch size = 1。
|
||||||
|
- 但只要内存放得下,**调大 batch size 几乎必然显著加速**评测——这是最简单的提速手段。
|
||||||
|
|
||||||
|
#### ② 数据并行(data parallelism)
|
||||||
|
|
||||||
|
- 思路:把模型复制到多张 GPU 上(而不是只加载到一张卡),把数据切成子集分给每张卡的副本,各自计算后再**聚合结果**。
|
||||||
|
- 效果:多条数据流同时被处理,总执行时间约**除以 GPU 数量**。
|
||||||
|
- 注意:尽量让所有 GPU 在**同一个节点(node)**上,避免节点间通信成为瓶颈(inter-node bottleneck)。
|
||||||
|
|
||||||
|
#### ③ 更换推理代码
|
||||||
|
|
||||||
|
- 不是所有推理库速度都一样,有些实现优化得更好,需要针对你的用例**实测对比**。
|
||||||
|
- 如果使用 PyTorch,作者推荐参考 [PyTorch 模型推理性能优化清单](https://pytorch.org/serve/performance_checklist.html)。
|
||||||
|
|
||||||
|
#### ④ 降低精度(precision)
|
||||||
|
|
||||||
|
- `float32` 每个数占 32 bit,计算精确但**内存与算力开销都大**。
|
||||||
|
- 降到 **`bfloat16` / `float16`(一半精度)**,速度约翻倍,精度损失几乎可以忽略。
|
||||||
|
- 想进一步提速可量化到 **8 bit 或 4 bit**(例如用 `gptq` 或 `bitsandbytes`),n-bit 矩阵计算更快、模型占内存更少。
|
||||||
|
- ⚠️ 某些量化库本身可能偏慢,需要针对你的场景实测。
|
||||||
|
|
||||||
|
> 贯穿 1.1 的原则:以上手段**不是二选一的单选题,而是可以叠加的组合拳**(如"大 batch + 数据并行 + `bfloat16`"),且**提速效果必须在你的硬件与任务上实测确认**——作者多次强调"test things out for your use cases"。
|
||||||
|
|
||||||
|
### 1.2 模型太大(GPU 装不下)怎么办
|
||||||
|
|
||||||
|
#### 估算内存需求
|
||||||
|
|
||||||
|
用如下公式估算加载模型所需的**最小理论内存**:
|
||||||
|
|
||||||
|
```
|
||||||
|
<memory (in GB)> = <number of parameters (in G)> × <precision factor>
|
||||||
|
```
|
||||||
|
|
||||||
|
原理:1 Byte = 8 bit,总内存 ≈ 参数量 × 每个参数占用的 Byte 数。precision factor 取值:
|
||||||
|
|
||||||
|
| 精度 | precision factor |
|
||||||
|
|---|---|
|
||||||
|
| `float32` | 4 |
|
||||||
|
| `float16` / `bfloat16` | 2 |
|
||||||
|
| 8 bit 量化 | 1 |
|
||||||
|
| 4 bit 量化 | 0.5 |
|
||||||
|
|
||||||
|
更稳妥的推荐公式(留出推理时的 batch 等额外开销):
|
||||||
|
|
||||||
|
```
|
||||||
|
<memory (in GB)> = <number of parameters (in G)> × (<precision factor> × 110%)
|
||||||
|
```
|
||||||
|
|
||||||
|
> 示例估算(用推荐公式 `参数(G) × factor × 110%`,取 7B 与 70B 两个常见规模):
|
||||||
|
|
||||||
|
| 模型规模 | `float32` | `float16`/`bfloat16` | 8 bit | 4 bit |
|
||||||
|
|---|---|---|---|---|
|
||||||
|
| 7B | 7×4×1.1 ≈ **30.8 GB** | 7×2×1.1 ≈ **15.4 GB** | 7×1×1.1 ≈ **7.7 GB** | 7×0.5×1.1 ≈ **3.9 GB** |
|
||||||
|
| 70B | 70×4×1.1 ≈ **308 GB** | 70×2×1.1 ≈ **154 GB** | 70×1×1.1 ≈ **77 GB** | 70×0.5×1.1 ≈ **38.5 GB** |
|
||||||
|
|
||||||
|
> 由此可快速判断硬件选型:单张 80GB 的 GPU 要跑 70B 模型,`float16`(154GB)不行,需要 8bit(77GB,一张卡勉强)或 4bit 量化 / 模型并行;而 7B 模型在 `float16` 下单张 16–24GB 的消费级卡即可胜任。
|
||||||
|
|
||||||
|
#### ① 量化(quantization)
|
||||||
|
|
||||||
|
- 最直接的手段:调小上面的 precision factor。从 `float32` 到 **4 bit**,内存需求直接**缩小 8 倍**。
|
||||||
|
- ⚠️ 精度过低会损害评测结果。对**中规模模型**建议保守停在 `float16` 或 8 bit。
|
||||||
|
- 经验观察:量化对**超大模型**的性能影响反而较小(可能因为存在信息冗余)。
|
||||||
|
|
||||||
|
#### ② 模型并行(model parallelism)
|
||||||
|
|
||||||
|
把模型切成小块,分别加载/运行在不同的 GPU 上;因为从不一次性加载完整模型,所以省内存,但**可能更慢**。两种主要类型:
|
||||||
|
|
||||||
|
| 类型 | 切分粒度 | 机制 | 代价 / 特点 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| **Pipeline parallelism**(流水线并行) | 整层(layer)级别 | 按层分派到不同 GPU,层 1 输出是层 2 输入 | GPU 会空转等待,产生所谓 **"bubble"**;把输入拆成更小的 batch 可缓解 bubble;需要 GPU 间传输数据 |
|
||||||
|
| **Tensor parallelism**(张量并行) | 矩阵计算级别 | 把矩阵按行/列切开,各 GPU 算完再聚合 | 只要 GPU 都在同一节点就**极其高效**(避免节点间网络瓶颈),但**难以编码** |
|
||||||
|
|
||||||
|
- Pipeline parallelism 正被原生加入 PyTorch 的 [`PiPPy`](https://github.com/pytorch/PiPPy) 库,也是 `accelerate` 底层使用的并行方式。
|
||||||
|
- Tensor parallelism 在 `vllm` 库中有很好的实现,作者形容其带来 **"insane speedups"(惊人的加速)**。
|
||||||
|
- 各类并行(含用于提速的 data parallelism)的最佳参考文档:[Transformers 官方并行文档](https://huggingface.co/docs/transformers/v4.15.0/en/parallelism)。
|
||||||
|
|
||||||
|
#### ③ CPU offloading
|
||||||
|
|
||||||
|
- 把部分计算和模型参数挪到 CPU,以降低 GPU 显存占用。
|
||||||
|
- ⚠️ **比上面任何方法都慢得多**——因为要持续在设备之间搬运数据。
|
||||||
|
- 典型实现:DeepSpeed 的 [ZeRO-Offload](https://arxiv.org/abs/2101.06840)(在 ZeRO-2 优化之上):优化阶段的梯度、optimizer states、fp32 参数计算放 CPU;GPU 上保留 fp16 参数与前向/反向传播,以"用 CPU 内存 + GPU 算力、最小化通信"为设计目标。
|
||||||
|
|
||||||
|
### 1.3 模型装得下,但还是 OOM
|
||||||
|
|
||||||
|
大概率是 **context size(上下文长度)** 的问题——显存峰值往往由"batch size × 序列长度"决定,模型权重本身反而放得下。作者建议:
|
||||||
|
|
||||||
|
1. **先用虚拟推理数据(dummy inference data)测试**模型是否真的放得下;虚拟数据要使用**足够大、能代表你任务**的 context size。
|
||||||
|
2. **降低 batch size**;如果你开了 auto-batch size search(自动搜索 batch size),考虑关掉——它可能导致意外的 OOM。
|
||||||
|
3. 一般性原则:**让样本按 context size 逆序(从大到小)呈现**给模型——这样如果 context 太大,会**一开始就立刻失败**,而不是跑了几小时后才崩。
|
||||||
|
|
||||||
|
## 2 数学能力评测中的 LaTeX 解析问题(MATH & sympy)
|
||||||
|
|
||||||
|
> 📌 **新版(2025 Space)更新**:新版指南把 LaTeX 解析问题并入「Designing your automatic evaluation」的 *Normalization* 小节,并推荐使用专门的数学解析库 **Math-Verify**(替代 sympy 手工解析/字符串比较,见 [[08-2025-Edition]] §5)。下方记录的是旧版(sympy)的探索过程与教训,仍有参考价值。
|
||||||
|
|
||||||
|
### 2.1 问题背景
|
||||||
|
|
||||||
|
- 解析 LaTeX **非常困难**。当评测任务期望模型输出 LaTeX 时(典型如 [MATH benchmark](https://huggingface.co/datasets/lighteval/MATH),它用 LaTeX 表示数学计算与符号),问题就来了。
|
||||||
|
- 评测这类任务本应只是"解析并比较 ground truth 与模型输出",但**实际上不存在"正确"的 LaTeX 解析方式**(sympy 文档自己也这么说)。
|
||||||
|
|
||||||
|
### 2.2 sympy 的局限:0.94 的自洽准确率
|
||||||
|
|
||||||
|
- `lm-evaluation-harness` 使用 **`sympy`**(Python 符号数学库)解析 LaTeX 并比较表达式。
|
||||||
|
- 残酷的事实:**即使用 ground truth 去解析 ground truth 本身**(自己和自己比),`sympy` 也只有约 **0.94 的准确率**。
|
||||||
|
- 原因:`sympy` 无法解析一部分**本身正确**的 LaTeX 表达式。
|
||||||
|
- 这个"用 ground truth 自比"的测试本质是一个**解析器健全性检查(round-trip test)**:它排除了模型因素,单独测量解析管道的上限。0.94 意味着即使模型 100% 输出正确答案,评测系统也会因解析失败丢掉约 6% 的分数——解析器成了评测误差的主要来源之一。
|
||||||
|
|
||||||
|
### 2.3 典型报错示例
|
||||||
|
|
||||||
|
以下三个示例中,`sympy` 都因语法问题拒绝了正确的 LaTeX:
|
||||||
|
|
||||||
|
**例 1:半开区间 `[0,1)`(interval)**
|
||||||
|
|
||||||
|
```
|
||||||
|
couldn't parse one of [0,1) or [0,1), I expected one of these: ']'
|
||||||
|
[0,1)
|
||||||
|
~~^
|
||||||
|
```
|
||||||
|
|
||||||
|
**例 2:并集 `\cup` 与无穷 `\infty`(此处写作 `\iny`)**
|
||||||
|
|
||||||
|
```
|
||||||
|
couldn't parse one of (-\iny,-5]\cup[5,\iny) or (-\iny,-5]\cup[5,\iny), I expected something else here
|
||||||
|
(-\iny,-5]\cup[5,\iny)
|
||||||
|
~~~~~~^
|
||||||
|
```
|
||||||
|
|
||||||
|
**例 3:分数中的空分组 `\frac{1}{{}2x}`**
|
||||||
|
|
||||||
|
```
|
||||||
|
couldn't parse one of -\frac{1}{{}2x} or -\frac{1}{{}2x}, I don't understand this
|
||||||
|
-\frac{1}{{}2x}
|
||||||
|
~~~~~~~~~~~^
|
||||||
|
```
|
||||||
|
|
||||||
|
> 小结:把上述失败归纳成三类典型盲区——
|
||||||
|
|
||||||
|
| 失败类别 | 报错示例 | 原因 |
|
||||||
|
|---|---|---|
|
||||||
|
| 区间表示(interval) | `[0,1)` | 半开区间 `[`/`)` 混用,sympy 期待 `]` 之类的闭合符号 |
|
||||||
|
| 集合运算与特殊符号 | `(-\iny,-5]\cup[5,\iny)` | `\cup`(并集)等集合运算符、`\infty`(示例中写作 `\iny`)不被支持 |
|
||||||
|
| 多余分组 | `-\frac{1}{{}2x}` | 分子/分母里的空分组 `{}` 导致语法不识别 |
|
||||||
|
|
||||||
|
三类都是**合法、正确的 LaTeX**,却会被解析器拒绝——这正是"解析器不是标准答案"的实证。
|
||||||
|
|
||||||
|
### 2.4 怎么绕过
|
||||||
|
|
||||||
|
两条路:
|
||||||
|
|
||||||
|
1. **重写 LaTeX grammar**:向 [`sympy` 的 LaTeX 语法文件 `latex.lark`](https://github.com/sympy/sympy/blob/master/sympy/parsing/latex/lark/grammar/latex.lark) 添加所需特性(为解析器增加新规则)。
|
||||||
|
2. **在代码里加手动检查**:为模型输出增加字符串比较等后处理兜底。
|
||||||
|
|
||||||
|
作者的选择:在几乎掉进"重写 grammar"这个深坑之后,**决定只给代码加上字符串比较(string comparison)检查**就足够了——即对 `lm-evaluation-harness` 打一个修复补丁(见原文附图中的 LM Eval Harness fix)。
|
||||||
|
|
||||||
|
> 为什么选"字符串比较"而不是"重写 grammar"?重写 parser grammar 是个无底洞:LaTeX 语法变体无穷无尽(区间、集合、特殊符号、各种分组写法),每补一个规则都可能引入新冲突,维护成本高。而字符串比较实现简单、可立刻生效——解析失败时退而求其次做规范化后的字符串比对,足以覆盖评测场景中大多数"模型其实答对了"的情况。**对评测工程而言,够用、可维护,比理论上完美更重要。**
|
||||||
|
|
||||||
|
### 2.5 修复效果:MATH 上旧/新解析器对比
|
||||||
|
|
||||||
|
修复后对 MATH benchmark 前 25 个模型的分数(原始解析器 vs 修复后解析器)对比如下(分数列为 0–100;"提升"为两列差值):
|
||||||
|
|
||||||
|
| 模型 | 原始 | 修复后 | 提升 | 排名变化 |
|
||||||
|
|---|---|---|---|---|
|
||||||
|
| rombodawg/Rombos-LLM-V2.5-Qwen-72b | 47.58 | 50.68 | +3.10 | 1 → 1 |
|
||||||
|
| MaziyarPanahi/calme-2.2-qwen2-72b | 41.16 | 43.43 | +2.27 | 2 → 2 |
|
||||||
|
| arcee-ai/Arcee-Nova | 40.48 | 42.90 | +2.42 | 3 → 3 |
|
||||||
|
| fblgit/TheBeagle-v2beta-32B-MGS | 39.43 | 42.52 | +3.09 | 4 → 4 |
|
||||||
|
| rombodawg/Rombos-LLM-V2.5-Qwen-32b | 39.12 | 41.99 | +2.87 | 5 → 5 |
|
||||||
|
| dnhkng/RYS-XLarge | 38.97 | 41.24 | +2.27 | 6 → 6 |
|
||||||
|
| dfurman/CalmeRys-78B-Orpo-v0.1 | 37.92 | 40.71 | +2.79 | 8 → 7 |
|
||||||
|
| MaziyarPanahi/calme-2.2-rys-78b | 37.92 | 39.95 | +2.03 | 8 → 9 |
|
||||||
|
| MaziyarPanahi/calme-2.4-rys-78b | 37.69 | 40.41 | +2.72 | 9 → 8 |
|
||||||
|
| MaziyarPanahi/calme-2.3-rys-78b | 36.56 | 38.97 | +2.41 | 10 → 10 |
|
||||||
|
| MaziyarPanahi/calme-2.1-rys-78b | 36.40 | 38.90 | +2.50 | 11 → 11 |
|
||||||
|
| Qwen/Qwen2.5-72B | 36.10 | 38.67 | +2.57 | 12 → 12 |
|
||||||
|
| MaziyarPanahi/calme-2.1-qwen2-72b | 36.03 | 38.07 | +2.04 | 13 → 15 |
|
||||||
|
| Qwen/Qwen2-Math-72B-Instruct | 35.95 | 38.14 | +2.19 | 14 → 14 |
|
||||||
|
| dfurman/Qwen2-72B-Orpo-v0.1 | 35.42 | 38.14 | +2.72 | 15 → 13 |
|
||||||
|
| abacusai/Smaug-Qwen2-72B-Instruct | 35.35 | 37.46 | +2.11 | 16 → 19 |
|
||||||
|
| anthracite-org/magnum-v1-72b | 35.27 | 37.69 | +2.42 | 18 → 16 |
|
||||||
|
| alpindale/magnum-72b-v1 | 35.27 | 37.69 | +2.42 | 18 → 16 |
|
||||||
|
| Qwen/Qwen2-72B-Instruct | 35.12 | 37.69 | +2.57 | 19 → 18 |
|
||||||
|
| dnhkng/RYS-XLarge-base | 34.67 | 37.16 | +2.49 | 20 → 20 |
|
||||||
|
| Undi95/MG-FinalMix-72B | 33.61 | 36.10 | +2.49 | 22 → 21 |
|
||||||
|
| abacusai/Dracarys-72B-Instruct | 33.61 | 35.65 | +2.04 | 22 → 22 |
|
||||||
|
| Qwen/Qwen2.5-32B | 32.85 | 35.50 | +2.65 | 23 → 23 |
|
||||||
|
| anthracite-org/magnum-v2-72b | 31.65 | 34.06 | +2.41 | 24 → 24 |
|
||||||
|
| dnhkng/RYS-Huge-bnb-4bit | 31.57 | 33.84 | +2.27 | 25 → 25 |
|
||||||
|
|
||||||
|
**关键观察**:
|
||||||
|
|
||||||
|
- 所有模型的分数都提升了约 **2–3 分**(最低 +2.03,最高 +3.10)——这个量级的差距足以改变一个模型的"好不好"结论,说明解析器(而非模型)曾经拖累了大量分数。
|
||||||
|
- 排名大体稳定,但个别模型有 ±1~3 位的变化(如 Smaug-Qwen2-72B-Instruct 从 16 掉到 19,Qwen2-72B-Orpo-v0.1 从 15 升到 13)——若按排名做基准对比,解析差异会**改变排行榜序**。
|
||||||
|
|
||||||
|
**为什么分数整体平移、排名却会变?** 解析器对每个模型的"扣分"并不均匀:模型 A 输出的 LaTeX 恰好多是 sympy 的盲区(区间、集合、多余分组),被多扣;模型 B 的输出风格恰好全被解析,少扣。所以修复解析器后,**被多扣的模型分数抬升更多**,相对位置就动了。结论:解析器不只是"对所有人一视同仁的常量误差",它还可能掩盖模型之间的真实差距。
|
||||||
|
|
||||||
|
> 引申教训:评测指标管道(metric pipeline)本身也是被测对象的一部分。解析器、normalization、后处理的实现差异会系统性抬高/压低某些模型的分数。
|
||||||
|
|
||||||
|
## 3 可复现性排错(Troubleshooting Reproducibility)
|
||||||
|
|
||||||
|
场景:你读了某篇最新技术报告,想在本地复现它的分数,却**复现不出来**?以下是作者拆解的原因清单。
|
||||||
|
|
||||||
|
### 3.1 不同的代码库(code base)
|
||||||
|
|
||||||
|
- 要复现到小数点,第一步是**使用与论文完全相同的代码库**。
|
||||||
|
- 通常意味着:用**作者提供的评测默认代码**,或用参考库中的标准实现——如 Eleuther AI 的 `lm_eval`、HuggingFace 的 `lighteval`。这两个库是社区事实上的"标准管道":`lm_eval`(EleutherAI)是使用最广的评测框架,`lighteval`(HuggingFace)由 Open LLM Leaderboard 团队维护——用它们,等于和其他人共用同一套任务定义与指标实现,这是复现的前提。
|
||||||
|
- 如果论文**没提供评测代码**:几乎不可能精确复现,只能放弃精确比对。
|
||||||
|
- ⭐ 想直观理解不同实现带来的差异,读作者团队写的这篇博客:[MMLU 在不同评测实现下的差异](https://huggingface.co/blog/open-llm-leaderboard-mmlu)——它研究了 MMLU 在 `lm_eval`、`helm` 与原始作者实现三种版本下的分数差异。
|
||||||
|
- 背景:正因为如此,HuggingFace 团队才发起 [Open LLM Leaderboard](https://huggingface.co/spaces/open-llm-leaderboard/open_llm_leaderboard),用统一、同质的评测来做模型间的横向比较。
|
||||||
|
|
||||||
|
### 3.2 同一代码库内也容易踩的坑
|
||||||
|
|
||||||
|
即使代码库相同,以下细节也容易出错:
|
||||||
|
|
||||||
|
#### ① 不同的随机种子(random seed)
|
||||||
|
|
||||||
|
- 推理受 seed 影响通常比训练小,但仍可能影响:
|
||||||
|
- 部分 **CUDA 操作**(参考 [PyTorch 可复现性文档](https://pytorch.org/docs/stable/notes/randomness.html));
|
||||||
|
- **非 greedy 生成策略**下的预测结果;
|
||||||
|
- 使用 few-shot 时的 **prompt 内容**(抽样选出哪些示例);
|
||||||
|
- 某些**前处理 / 后处理函数**。
|
||||||
|
- 一个小 seed 差异就可能带来**几分之差**。
|
||||||
|
|
||||||
|
#### ② 同名但实际不同的指标(metric)
|
||||||
|
|
||||||
|
指标名相同 ≠ 计算方式相同,例如:
|
||||||
|
|
||||||
|
- **log likelihood 版 `exact match`**(计算不同候选答案的对数概率) vs **生成式 `exact match`**(只把 greedy 生成与参考答案比较)——两者分数完全不同。
|
||||||
|
- 代码库里不少任务名叫 `exact match`,实际却是:
|
||||||
|
- **`prefix exact match`**(只比生成的开头与参考);
|
||||||
|
- **`suffix exact match`**(反过来,只比结尾);
|
||||||
|
- **`quasi exact match`**(带 normalization 的 exact match)。
|
||||||
|
- **结论:不能只靠指标名判断评测做了什么,必须看代码。**
|
||||||
|
|
||||||
|
#### ③ 不同的 normalization
|
||||||
|
|
||||||
|
- 回到上面生成式 `exact match` 的例子:`lm_eval` v1 中不少任务只叫 generative `exact match`,你会以为预测是"原样与参考比较";但看代码会发现预测**先经过 normalization**(去标点、数字同质化等)再比较——这会**大幅改变结果**。
|
||||||
|
- `lm_eval` **v2 已把 normalization 的名字写进大多数指标名**。
|
||||||
|
- 这是最容易被搞砸的点,尤其对**需要大量 normalization / 答案后处理的任务**,比如数学评测(需要从模型生成的解释里**抽取最终答案**再比较)。
|
||||||
|
|
||||||
|
### 3.3 不同的 prompt
|
||||||
|
|
||||||
|
prompt 变化有三个来源。
|
||||||
|
|
||||||
|
#### ① prompt 本身(格式)
|
||||||
|
|
||||||
|
prompt 格式对分数的影响**巨大**。以多选题为例,仅呈现选项的格式就有多种"语义等价"的变体:
|
||||||
|
|
||||||
|
```text
|
||||||
|
Question: <text of the question>
|
||||||
|
Choices:
|
||||||
|
```
|
||||||
|
|
||||||
|
```markdown
|
||||||
|
| A. <Choice A> | (A) <Choice A> | <Choice A> |
|
||||||
|
| B. <Choice B> | (B) <Choice B> | <Choice B> |
|
||||||
|
| C. <Choice C> | (C) <Choice C> | <Choice C> |
|
||||||
|
| D. <Choice D> | (D) <Choice D> | <Choice D> |
|
||||||
|
```
|
||||||
|
|
||||||
|
```text
|
||||||
|
Answer:
|
||||||
|
```
|
||||||
|
|
||||||
|
并要求模型预测 `A`/`B`/`C`/`D`,或直接输出 `<Choice A/B/C/D>` 的完整文本。
|
||||||
|
|
||||||
|
- 这些 prompt **语义等价**(内容完全相同),但对同一模型仍可能差**好几分**:
|
||||||
|
- 作者团队实验([原帖](https://x.com/clefourrier/status/1777319187913875893/photo/1))观察到同一模型**最高差 7 分**;
|
||||||
|
- [相关论文](https://arxiv.org/abs/2310.11324)也观察到了类似结果。
|
||||||
|
- 有些任务还会带**任务前缀 prompt**(如 `The following questions are about <topic>`),其有无也会影响分数。
|
||||||
|
- ⭐ [这篇论文](https://arxiv.org/abs/2407.07890)还揭示一个副作用:**不少模型被训练成"过拟合基准的 prompt 与答案格式"**,代价是在评测时对其他 prompt 的适应能力下降。
|
||||||
|
- 实例(Open LLM Leaderboard 2 上的 Llama3.1):这些模型在 MATH-Hard 评测中**能预测出正确答案,分数却很低**——因为它们过拟合了 GSM8K(另一个数学评测)的 prompt 与答案格式,无法适配 few-shot 中提供的模板。
|
||||||
|
|
||||||
|
#### ② system prompt 与 chat template
|
||||||
|
|
||||||
|
- Chat 模型通常经过指令/偏好训练(instruction/preference training 或 fine-tuning),这个阶段它们学会了**遵循特定模板**推理。
|
||||||
|
- 常见模板要素:
|
||||||
|
- 每轮对话以**system prompt** 开头(通常以特定 token 前缀,如 `System: `),用于给模型高层指令(人设、回答风格等);
|
||||||
|
- 对话轮次给文本加**前缀关键词**,如 `User`(提问)与 `Assistant`(回答)。
|
||||||
|
- 使用 few-shot 时还要决定:示例**按多轮(multi-turn,模拟 user/assistant 轮次)提供**,还是**一次性放在单条 user prompt 里**。
|
||||||
|
- ⚠️ **不遵循模型期望的 chat template,会严重损害性能**——因为它把模型输出推向其已收敛的概率空间之外。
|
||||||
|
|
||||||
|
#### ③ few-shot 样本
|
||||||
|
|
||||||
|
- 显然要用**与参考任务相同的 few-shot 数量**。
|
||||||
|
- 还要用**完全相同的样本**——不同样本会改变结果(这不太意外:有些样本更能表达任务)。
|
||||||
|
- 更反直觉的一点:**样本完全相同还不够,顺序也必须完全相同**。作者团队观察到:同样的样本仅改变顺序,在 **MMLU 的某些子集上最多差 3 分**([结果见这里](https://huggingface.co/blog/evaluation-structured-outputs),第三个 colorgrid)。
|
||||||
|
- 因此这里同样要**注意随机种子**。
|
||||||
|
|
||||||
|
### 3.4 不同的生成参数(generation parameters)
|
||||||
|
|
||||||
|
对生成式评测,需要对齐:
|
||||||
|
|
||||||
|
- 使用**相同的 end of sentence token(EOS token)**;
|
||||||
|
- 允许模型**生成相同数量的 token**;
|
||||||
|
- 如果使用 sampling,确保**相同的 seed / temperature 参数**。
|
||||||
|
|
||||||
|
### 3.5 不同的模型加载(model loading)
|
||||||
|
|
||||||
|
已观察到的差异来源:
|
||||||
|
|
||||||
|
| 来源 | 说明 |
|
||||||
|
|---|---|
|
||||||
|
| **不同硬件** | PyTorch **不保证**非确定性操作在不同硬件上可复现 |
|
||||||
|
| **不同推理库** | 例如用 `transformers` 还是 `vllm` 作为推理后端,矩阵计算的实现方式并不完全相同 |
|
||||||
|
| **不同 batch size** | 多个评测库与模型后端都有文档记录:**batch size 不同会改变推理结果**;要完全可复现就固定 batch size(虽然内存受限时不一定总能做到) |
|
||||||
|
| **不同加载精度** | 用更低精度加载权重可省内存与推理成本,但用的是不同版本的权重,**数值结果必然改变** |
|
||||||
|
|
||||||
|
> 排查复现问题时的总思路:**从"最可能、最容易改"的项开始逐项对齐**——先核对 prompt 与 few-shot(改动最频繁、影响最直接),再查指标与 normalization(需要看代码确认),最后核对生成参数与加载方式(涉及硬件环境)。每锁定一项就重跑一次对比,通常很快能找到分差来源。
|
||||||
|
|
||||||
|
### 3.6 可复现性检查清单(速查)
|
||||||
|
|
||||||
|
综合 3.1–3.5,复现一份评测分数前逐项核对(任一项不满足,分数就可能对不上):
|
||||||
|
|
||||||
|
- [ ] 使用与参考完全相同的**代码库/评测框架**(`lm_eval` / `lighteval` / 作者实现)
|
||||||
|
- [ ] 相同**随机种子**(尤其非 greedy 生成、few-shot 抽样)
|
||||||
|
- [ ] 相同的**指标定义**(log-likelihood vs generative、prefix/suffix/quasi exact match,看代码确认)
|
||||||
|
- [ ] 相同的 **normalization / 后处理**(数学评测尤其注意答案抽取)
|
||||||
|
- [ ] 相同的 **prompt 格式、system prompt、chat template**(多轮 vs 单次 few-shot)
|
||||||
|
- [ ] 相同的 **few-shot 数量、样本与顺序**
|
||||||
|
- [ ] 相同的**生成参数**(EOS token、max tokens、seed / temperature)
|
||||||
|
- [ ] 相同的**硬件、推理库、batch size、加载精度**
|
||||||
|
|
||||||
|
## 核心要点(一句话版)
|
||||||
|
|
||||||
|
1. **提速四杠杆**(按性价比排序):调大 batch size → 数据并行 → 换更快推理库 → 降精度(`bfloat16`/`float16` → 8bit/4bit 量化)。
|
||||||
|
2. **内存估算**:`memory(GB) = 参数(G) × precision factor × 110%`;factor 为 `float32`=4、`float16`/`bfloat16`=2、8bit=1、4bit=0.5。
|
||||||
|
3. **放不下时**:先量化(最多省 8 倍内存),再模型并行(pipeline 慢在 bubble、tensor 慢在难编码但同节点极快),CPU offloading 是最后手段(显著更慢)。
|
||||||
|
4. **装得下却 OOM**:八成是 context size 问题——用大 context 的 dummy 数据先测、降 batch、样本按 context 逆序呈现让失败提前暴露。
|
||||||
|
5. **数学评测的 LaTeX 解析没有标准答案**:`lm-evaluation-harness` 用的 `sympy` 连 ground truth 自比都只有约 0.94 准确率;别去重写 grammar,加字符串比较兜底就够(修复后 25 个模型 MATH 分数全部 +2~3 分)。
|
||||||
|
6. **复现不出分数 = 某个环境细节没对齐**:代码库、随机种子、指标真实定义(prefix/suffix/quasi exact match)、normalization、prompt 格式与 chat template、few-shot 的数量/样本/顺序(顺序变化最多差 3 分)、生成参数(EOS、max tokens、seed/temperature)、硬件/推理库/batch size/加载精度——每一项都可能差几分。
|
||||||
|
7. **最容易被低估的两处**:① 同名指标的实现差异(必须看代码,别信名字);② prompt 格式的微小变化——语义等价也能差 7 分,还有模型专门过拟合基准 prompt 格式,换格式分数暴跌。
|
||||||
|
8. **工具取向**:优先使用维护中的标准框架(`lm_eval` v2、`lighteval`),因为它们把 normalization 等细节暴露在指标名里,减少"实现悄悄不同"的踩坑概率;升级框架版本时,也要顺手核对指标定义是否变化。
|
||||||
|
|
||||||
|
## 参考资料
|
||||||
|
|
||||||
|
### 原文(GitHub 仓库)
|
||||||
|
|
||||||
|
- [Troubleshooting inference(推理排错)](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/troubleshooting/troubleshooting-inference.md)
|
||||||
|
- [Using LaTeX to evaluate MATH capabilities(LaTeX 解析)](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/troubleshooting/troubleshooting-math-parsing.md)
|
||||||
|
- [Troubleshooting reproducibility(可复现性排错)](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/troubleshooting/troubleshooting-reproducibility.md)
|
||||||
|
- 仓库主页:[huggingface/evaluation-guidebook](https://github.com/huggingface/evaluation-guidebook)
|
||||||
|
|
||||||
|
### 文中引用的外部链接
|
||||||
|
|
||||||
|
- [PyTorch 模型推理性能优化清单](https://pytorch.org/serve/performance_checklist.html)
|
||||||
|
- [PyTorch PiPPy(pipeline parallelism)](https://github.com/pytorch/PiPPy)
|
||||||
|
- [Transformers 并行化文档(data / pipeline / tensor parallelism)](https://huggingface.co/docs/transformers/v4.15.0/en/parallelism)
|
||||||
|
- [ZeRO-Offload 论文(arXiv:2101.06840)](https://arxiv.org/abs/2101.06840)
|
||||||
|
- [MATH benchmark(lighteval/MATH)](https://huggingface.co/datasets/lighteval/MATH)
|
||||||
|
- [sympy(符号数学库)](https://github.com/sympy/sympy)
|
||||||
|
- [sympy 的 LaTeX grammar(latex.lark)](https://github.com/sympy/sympy/blob/master/sympy/parsing/latex/lark/grammar/latex.lark)
|
||||||
|
- ⭐ [MMLU 在不同评测实现下的差异(HF 博客)](https://huggingface.co/blog/open-llm-leaderboard-mmlu)
|
||||||
|
- [Open LLM Leaderboard](https://huggingface.co/spaces/open-llm-leaderboard/open_llm_leaderboard)
|
||||||
|
- [PyTorch 可复现性文档](https://pytorch.org/docs/stable/notes/randomness.html)
|
||||||
|
- [prompt 格式对分数影响的实验(X 原帖,最高差 7 分)](https://x.com/clefourrier/status/1777319187913875893/photo/1)
|
||||||
|
- [Few-shot prompt 变化的影响(论文 arXiv:2310.11324)](https://arxiv.org/abs/2310.11324)
|
||||||
|
- ⭐ [模型过拟合基准 prompt 格式(论文 arXiv:2407.07890)](https://arxiv.org/abs/2407.07890)
|
||||||
|
- [few-shot 顺序对 MMLU 子集分数的影响(HF 博客)](https://huggingface.co/blog/evaluation-structured-outputs)
|
||||||
+325
@@ -0,0 +1,325 @@
|
|||||||
|
---
|
||||||
|
type: reference
|
||||||
|
tags:
|
||||||
|
- llm-evaluation
|
||||||
|
- evaluation-guidebook
|
||||||
|
- general-knowledge
|
||||||
|
status: active
|
||||||
|
created: 2026-08-21
|
||||||
|
source: https://github.com/huggingface/evaluation-guidebook
|
||||||
|
---
|
||||||
|
|
||||||
|
# LLM 评测指南 · General Knowledge(通用知识)提炼笔记
|
||||||
|
|
||||||
|
> 本页提炼自 [HuggingFace Evaluation Guidebook](https://github.com/huggingface/evaluation-guidebook) 的 **General knowledge** 章节的两页内容:**Model inference and evaluation**(模型推理与评测)与 **Tokenization**(分词)。面向初学者,重点整理与评测直接相关的部分:生成式评测 vs log-probability 评测、log-prob 的计算方式、tokenizer 对评测结果的影响。
|
||||||
|
>
|
||||||
|
> 原文链接:
|
||||||
|
> - [model-inference-and-evaluation.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/general-knowledge/model-inference-and-evaluation.md)
|
||||||
|
> - [tokenization.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/general-knowledge/tokenization.md)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 一、模型推理与评测(Model Inference and Evaluation)
|
||||||
|
|
||||||
|
### 1.1 什么是推理(inference)
|
||||||
|
|
||||||
|
大型语言模型的工作方式很简单:**给定一段文本作为输入,它们学会了预测"合理的后续内容"**。整个过程分两步:
|
||||||
|
|
||||||
|
#### 第一步:Tokenization(分词)
|
||||||
|
|
||||||
|
- 输入文本(推理时称为 *prompt*)先被切分成 **tokens**——小的文本单元(可以是一个或几个字符,最多到词级)。
|
||||||
|
- 每个 token 关联一个数字;模型能解析的全部 token 范围称为它的 **vocabulary**(词表)。
|
||||||
|
- 细节见本页第二章(原文 Tokenization 页)。
|
||||||
|
|
||||||
|
#### 第二步:Prediction(预测)
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
- 基于输入文本,LLM 在**整个词表**上生成"最可能的下一个 token"的概率分布。
|
||||||
|
- 要得到连续生成:取概率最高的 token(可加入一点随机性以获得更有趣的输出)作为下一个 token,然后**重复该操作**,把新 token 当作 prompt 的结尾继续下去,如此循环(即自回归生成)。
|
||||||
|
|
||||||
|
### 1.2 你想预测什么?——评测的两大类别
|
||||||
|
|
||||||
|
LLM 评测主要分为两大类:
|
||||||
|
|
||||||
|
1. **给定一个 prompt 和一个(或多个)答案**:我的模型给出这些答案的概率是多少?
|
||||||
|
2. **给定一个 prompt**:我的模型会生成什么文本?
|
||||||
|
|
||||||
|
| 维度 | Log-likelihood 评测(选择题式) | Generative 评测(生成式) |
|
||||||
|
|---|---|---|
|
||||||
|
| 核心问题 | 给定候选答案,答案是"被模型认可"的概率 | 给定 prompt,模型自己生成什么 |
|
||||||
|
| 模型输出 | 候选序列的 log-probability | 自回归生成的 token 序列 |
|
||||||
|
| 典型形态 | 多项选择(multiple-choice / MCQA)、单句概率判断、校准研究 | 开放生成、摘要、翻译、代码生成 |
|
||||||
|
| 打分方式 | 比较各选项 log-prob、与 0.5 阈值比较、看校准 | 与参考文本比对(exact match、BLEU 等)或模型作评委 |
|
||||||
|
| 优点 | 计算确定、可复现,直接反映模型偏好 | 更接近真实使用场景 |
|
||||||
|
| 风险 | 可能偏向"自由生成时会输出别的东西"的模型(见 1.3) | 生成结果多样,打分标准更难定 |
|
||||||
|
|
||||||
|
> 📌 **术语衔接(来自指南其他章节,非本页原文)**:指南的 *Automatic benchmarks* 章节把"对给定序列求 log-probability"的评测称为 *multiple-choice evaluations*,有时也叫 **MCQA** 或 *perplexity evaluations*;perplexity(困惑度)指标的具体用法,以及评测框架 **lm-evaluation-harness**(EleutherAI)与 **lighteval**(HuggingFace)的讨论,不在本页范围内,详见指南对应章节与本目录 [[01-Automatic-Benchmarks]]、[[07-Resources]] 笔记。
|
||||||
|
|
||||||
|
### 1.3 Log-likelihood(log-prob)评测
|
||||||
|
|
||||||
|
目标是:**给定 prompt,求一个或多个候选答案的条件概率**——即"给定输入,得到某个特定续写的可能性有多大"。
|
||||||
|
|
||||||
|
计算过程(对应原文插图 `llm_logprob.png`):
|
||||||
|
|
||||||
|
```text
|
||||||
|
1. 拼接:把每个选项(choice)与 prompt 拼接,传给 LLM
|
||||||
|
↓
|
||||||
|
2. 取 logits:LLM 输出每个 token 的 logits(每个 token 取决于它之前的 token)
|
||||||
|
↓
|
||||||
|
3. 只保留与选项 token 相关的最后几个 logits,施加 log softmax
|
||||||
|
→ 得到 log-probabilities(值域为 [-inf, 0],而不是 [0, 1])
|
||||||
|
↓
|
||||||
|
4. 求和:把所有单个 token 的 log probability 相加
|
||||||
|
→ 得到整个选项的总 log probability
|
||||||
|
↓
|
||||||
|
5. 归一化:最后可按选项长度(choice length)做归一化
|
||||||
|
```
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
基于此可以应用以下指标:
|
||||||
|
|
||||||
|
- **在多个选项中选出模型最偏好的答案**(如上图)。
|
||||||
|
- ⚠️ 注意:这可能**有利于**那些"若自由生成会输出别的东西"的模型——例如图中模型"被迫"在选项里选 `Zygote`,但若让它自由生成可能给出别的答案,从而虚高其得分。
|
||||||
|
- **测试单个选项的概率是否超过 0.5**。
|
||||||
|
- **研究模型校准(calibration)**:一个校准良好的模型,其正确答案应该拥有最高的概率。
|
||||||
|
- 了解校准是什么、如何检测、如何训练出校准良好的模型:Anthropic 论文 [Calibration tutorial](https://arxiv.org/abs/2207.05221)。
|
||||||
|
- 校准的一些可能局限:[Limits of calibration](https://arxiv.org/abs/2311.14648)。
|
||||||
|
|
||||||
|
### 1.4 生成式评测(Generative evaluations)
|
||||||
|
|
||||||
|
目标是:**给定 prompt,得到模型生成的文本**。
|
||||||
|
|
||||||
|
生成过程是自回归的:
|
||||||
|
|
||||||
|
```text
|
||||||
|
1. 把 prompt 传给模型
|
||||||
|
↓
|
||||||
|
2. 看最可能的下一个 token,选中它作为模型的 "choice first token"
|
||||||
|
↓
|
||||||
|
3. 重复,直到满足生成结束条件:
|
||||||
|
- 达到最大长度(maximum length)
|
||||||
|
- 出现特殊终止 token(special token to stop the generation)
|
||||||
|
- 等
|
||||||
|
↓
|
||||||
|
4. 模型生成的所有 token 即它对 prompt 的"回答"
|
||||||
|
```
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
然后**把生成结果与参考答案(references)比较,对两者之间的距离打分**:
|
||||||
|
|
||||||
|
- 简单指标:**exact match**(精确匹配)。
|
||||||
|
- 更复杂的指标:**BLEU** 等。
|
||||||
|
- 或用**模型作评委**(models as judges,即 LLM-as-a-judge,详见指南 Model-as-a-Judge 章节)。
|
||||||
|
|
||||||
|
#### Going further(进阶阅读)
|
||||||
|
|
||||||
|
- ⭐ [Blog on several ways to evaluate MMLU](https://huggingface.co/blog/open-llm-leaderboard-mmlu) —— HuggingFace 团队(原作者所在团队)所写,深入讲解"多项选择 log-likelihood 评测"与"生成式评测"的差异,以及它们对分数变化意味着什么。上文插图即来自该博客(由 Thom Wolf 制作)。
|
||||||
|
- ⭐ [A beautiful mathematical formalization of the above inference methods](https://arxiv.org/abs/2405.14782v2) —— EleutherAI 对上述推理方法的数学形式化,直接看 Appendix。
|
||||||
|
|
||||||
|
### 1.5 约束模型输出(Constraining model outputs)
|
||||||
|
|
||||||
|
在很多情况下,我们希望模型输出遵循特定格式(例如为了与参考答案比较)。原文给出了三种方式:
|
||||||
|
|
||||||
|
| 方式 | 做法 | 优点 | 局限 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| **使用 prompt** | 在任务 prompt 中加入非常具体的指令(如 `Provide numerical answers in digits.`、`Use no abbreviation.`) | 最简单;对高能力模型通常够用 | 不一定总是有效 |
|
||||||
|
| **Few-shot / In-context learning** | 在 prompt 中提供示例(few-shot prompting),让模型隐式偏向遵循示例的 prompt 形状 | 2023 年底之前普遍效果很好 | 见下方说明 |
|
||||||
|
| **结构化文本生成(Structured text generation)** | 用语法(grammar)或正则表达式定义输出路径,约束输出 | 减少评测中的 prompt 方差,结果与排名更稳定 | 可能降低部分任务的性能(见下方说明) |
|
||||||
|
|
||||||
|
#### Few-shot 的说明
|
||||||
|
|
||||||
|
- 工作原理:通过 in-context learning,prompt 里的示例会让模型隐式地偏向"按照重复出现的 prompt 形状"作答。
|
||||||
|
- **时效性**:该方法直到 2023 年底都整体表现良好;但此后 **instruction-tuning** 的广泛采用,以及预训练后期加入指令数据(**continuous pre-training**),似乎让较新的模型偏向特定输出格式——论文称之为 *Training on the test task*([arxiv 2407.07890](https://arxiv.org/abs/2407.07890)),作者则称之为 *overfitting the prompt format*(对 prompt 格式的过拟合)。
|
||||||
|
- **上下文窗口限制**:对上下文窗口较小的旧模型,few-shot 示例可能**放不进 context window**。
|
||||||
|
|
||||||
|
#### 结构化生成的说明
|
||||||
|
|
||||||
|
- `outlines` 库用**有限状态机(finite state machines, FSM)**实现,作者认为非常 neat;也存在其他方法,例如用于 JSON 生成的 **interleaved generation**(作者本人更偏爱 FSM)。
|
||||||
|
- 收益:结构化生成降低评测中的 prompt 方差,使结果和排名更稳定(见共同撰写的博客 [Evaluation of structured outputs](https://huggingface.co/blog/evaluation-structured-outputs);也可看 `outlines` 的 [博客](https://blog.dottxt.co/))。
|
||||||
|
- 风险:近期 [研究](https://arxiv.org/abs/2408.02442) 显示,结构化生成可能通过把先验推离期望概率分布太远,从而**降低模型在部分任务(如推理)上的表现**。
|
||||||
|
|
||||||
|
#### Going further(进阶阅读)
|
||||||
|
|
||||||
|
- ⭐ [Understanding how Finite State Machine works when using structured generation](https://blog.dottxt.co/coalescence.html) —— Outlines 出品,对其方法的清晰讲解。
|
||||||
|
- [The outlines method paper](https://arxiv.org/abs/2307.09702) —— 上述方法的学术版解释。
|
||||||
|
- [Interleaved generation](https://github.com/guidance-ai/guidance?tab=readme-ov-file#guidance-acceleration) —— 另一种约束特定输出格式生成的方法。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 二、Tokenization(分词)
|
||||||
|
|
||||||
|
### 2.1 为什么以及如何切分文本
|
||||||
|
|
||||||
|
**LLM 本质上是大型数学函数,吃的是数字而不是文本。** 要把句子变成数字:先决定如何把句子切成小块,再把每个小块映射成一个数字——这就是 **tokenization**。
|
||||||
|
|
||||||
|
历史上两端方案:
|
||||||
|
|
||||||
|
| 方案 | 切分方式 | 映射方式 | 例子 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| **Character based**(字符级) | 按字符切分 | 每个字符映射为字母表索引 | `a` → 1,`b` → 2 |
|
||||||
|
| **Word based**(词级) | 按空格切分(若语言有空格;没有的话更难) | 每个词映射为词典索引 | `a` → 1,`aardvark` → 2,`ab` → 3 |
|
||||||
|
|
||||||
|
**两者的共同局限:都会丢失输入文本的信息。**
|
||||||
|
|
||||||
|
- 抹掉了从**词形**能看出的语义联系,例如:`dis similar`、`similar`、`similar ity`、`similar ly` —— 这些联系正是我们希望模型保留、以便把相关词联系起来的。
|
||||||
|
- 另外:如果输入中出现一个**全新的词**,它没有对应数字,模型就无法处理 😔
|
||||||
|
|
||||||
|
于是有人想到:**把词切成子词(sub-words),再为这些子词分配索引**(如 `dis`、`similar`、`ity`、`ly`)。
|
||||||
|
|
||||||
|
- 早期做法:使用**形态句法规则(morpho-syntactic rules)**("morpho-syntax" 类似于"构词的语法")。
|
||||||
|
- 现在大多数使用 **byte pair encoding(BPE)**:一种聪明的统计方法,根据参考文本中的词频**自动**创建子词。
|
||||||
|
|
||||||
|
**总结定义**:
|
||||||
|
|
||||||
|
> Tokenization 是一种把小的文本单元(可以是一个或几个字符,最多到词级)映射为数字(类似索引)的方式。处理文本时,输入文本(推理时称为 *prompt*)被 **tokenizer** 切分成这些 **tokens**;模型或 tokenizer 能解析的全部 token 范围称为它的 **vocabulary**。
|
||||||
|
|
||||||
|
#### Going further:理解 tokenization
|
||||||
|
|
||||||
|
- ⭐ [Explanation of different tokenization methods in the 🤗 NLP Course](https://huggingface.co/learn/nlp-course/en/chapter2/4) —— 建议精读。
|
||||||
|
- ⭐ [Conceptual guide about tokenization in the 🤗 doc](https://huggingface.co/docs/transformers/en/tokenizer_summary) —— 建议精读。
|
||||||
|
- [Course by Jurafsky on tokenization](https://web.stanford.edu/~jurafsky/slp3/2.pdf) —— 更学术向,直接跳到 2.5 和 2.6 节(其余也有趣但太宽泛)。
|
||||||
|
|
||||||
|
#### Going further:Byte Pair Encoding
|
||||||
|
|
||||||
|
- ⭐ [Explanation of BPE in the 🤗 NLP Course](https://huggingface.co/learn/nlp-course/en/chapter6/5)
|
||||||
|
- [Paper introducing BPE to NLP](https://aclanthology.org/P16-1162/)
|
||||||
|
|
||||||
|
### 2.2 问题一:如何选择词表大小(vocabulary size)
|
||||||
|
|
||||||
|
词表大小 = 模型需要学习的独立 token(例如子词)的数量。
|
||||||
|
|
||||||
|
#### 词表太大(too big)的两个问题
|
||||||
|
|
||||||
|
1. 可能把**很罕见的词**当作完整 token 收录(例如 `aardvark`)。如果该词在训练数据中几乎不出现,它就**难以与其他概念建立联系**,模型可能无法推断它是什么。
|
||||||
|
2. 如果该词罕见但只出现在特定上下文,则可能被关联到**非常具体的词**:例如在论坛数据上训练时,tokenizer 把一个用户名映射成单一 token,模型就可能把这个 token 与该用户的内容关联起来。
|
||||||
|
|
||||||
|
#### 词表太小(too small)的两个问题
|
||||||
|
|
||||||
|
1. **表示能力变差**。
|
||||||
|
2. **推理成本上升**。
|
||||||
|
|
||||||
|
回到 `similar` 词族的例子(原文):
|
||||||
|
|
||||||
|
- 用类 BPE(大词表)切 `similarly` → **2 个 token**:`similar`、`ly`。
|
||||||
|
- 用字符级切分(词表很小,只有字母表大小)切同一个词 → **9 个 token**:`s` `i` `m` `i` `l` `a` `r` `l` `y`。
|
||||||
|
|
||||||
|
对比结论:
|
||||||
|
|
||||||
|
- 大词表切出的 token 各自有独立语义;小词表则**丢失了语义表示**。
|
||||||
|
- 表示长度差异直接变成成本差异:生成同一个词需要 9 个 token 而不是 2 个,**贵了约 5 倍**!
|
||||||
|
|
||||||
|
#### 实践建议
|
||||||
|
|
||||||
|
目前大多数人用**启发式**选择词表大小,它似乎与**覆盖的语言数量**和**模型规模**相关——因此使用与"规模相近的参考模型"接近的 token 数量,很可能可行。
|
||||||
|
|
||||||
|
#### Going further:罕见 token 效应
|
||||||
|
|
||||||
|
- ⭐ [SolidGoldMagikarp post on Less Wrong](https://www.lesswrong.com/posts/aPeJE8bSo6rAFoLqg/solidgoldmagikarp-plus-prompt-generation) —— 有趣读物:人们在**不访问模型内部**(例如不知道训练数据内容)的情况下识别出 OpenAI 词表中的极罕见 token。
|
||||||
|
- [Fishing for Magikarp, paper by Cohere](https://arxiv.org/abs/2405.05417) —— 检测这些 token 的后续工作。
|
||||||
|
|
||||||
|
### 2.3 问题二:多语言管理(Managing several languages)
|
||||||
|
|
||||||
|
> 建议先读完 BPE 的解释再读本节。
|
||||||
|
|
||||||
|
- 构建/选择 tokenizer 时,词表来自**参考文本**——通常意味着**英文、拉丁字母**的数据。
|
||||||
|
- 如果新语言与原始语言**使用相同脚本且有共同词根**,理论上可以期待部分语义迁移到新语言。
|
||||||
|
- 但若要 tokenizer 正确切分其他语言(尤其是**不同脚本**的语言),最好在构建 tokenizer 时**纳入这些语言的数据**。
|
||||||
|
- 然而,这些数据通常**比例失衡**:初始语言(如英文)远多于新语言(如泰语、缅甸语)。由于 BPE 等高效方法基于**最高频的词**创建复杂词表 token:
|
||||||
|
- 大多数**长 token 是英文词**;
|
||||||
|
- 低频语言的大部分词**只能按字符级切分**。
|
||||||
|
|
||||||
|
**结果:多语言 tokenization 的不公平** —— 一些(较不常见的、或 *lower-resourced* 低资源)语言,生成与英文**等长含义的句子需要多出数量级(orders of magnitude)的 token**。
|
||||||
|
|
||||||
|
#### Going further:语言与 tokenization
|
||||||
|
|
||||||
|
- ⭐ [A beautiful breakdown and demo by Yennie Jun on tokenization issues across languages](https://www.artfish.ai/p/all-languages-are-not-created-tokenized) —— 分析本身非常清晰,值得把玩其 [demo space](https://huggingface.co/spaces/yenniejun/tokenizers-languages)。
|
||||||
|
- ⭐ [A demo by Aleksandar Petrov on unfairness of tokenization](https://aleksandarpetrov.github.io/tokenization-fairness/) —— 建议看 *Compare tokenization of sentences*,直观感受不同语言在推理成本上的差异。
|
||||||
|
|
||||||
|
### 2.4 问题三:数字怎么办?(What about numbers?)
|
||||||
|
|
||||||
|
构建 tokenizer 时需要决定如何处理数字:
|
||||||
|
|
||||||
|
- 只索引 `0` 到 `9`,假设其他所有数字都是数字位的组合?
|
||||||
|
- 还是把数字单独存储,直到(比如说)十亿级别?
|
||||||
|
|
||||||
|
现状与展望:
|
||||||
|
|
||||||
|
- 当前知名模型对此**做法各异**,但尚不清楚哪种方式更有利于**数学推理**。
|
||||||
|
- 也许需要新的 tokenization 方法(例如 **hierarchical tokenization**,分层分词)来解决。
|
||||||
|
|
||||||
|
#### Going further:数字 tokenization
|
||||||
|
|
||||||
|
- ⭐ [A nice visual demo by Yennie Jun of how tokenizers split numbers](https://www.artfish.ai/p/how-would-you-tokenize-or-break-down) —— Anthropic、Meta、OpenAI、Mistral 各模型 tokenizer 如何切分数字的可视化演示。
|
||||||
|
- [Small history by Beren Millidge of number tokenization evolution](https://www.beren.io/2024-05-11-Integer-tokenization-is-now-much-less-insane/) —— 数字 tokenization 多年演变的小史。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 三、Tokenization 如何影响评测(对评测的启示)
|
||||||
|
|
||||||
|
把两页内容串到评测视角,可得到如下速查表(均为原文要点,非新增内容):
|
||||||
|
|
||||||
|
| 评测相关维度 | 原文章节要点 | 对评测的含义 |
|
||||||
|
|---|---|---|
|
||||||
|
| **生成成本 / 长度** | 同样一个词,字符级切 9 个 token vs BPE 切 2 个 token,贵约 5 倍 | 同一 prompt 在不同 tokenizer 下 token 数不同 → 推理耗时与费用不同;评测大批量样本时成本差异显著 |
|
||||||
|
| **词表大小** | 太大 → 罕见 token 难以关联或过度关联;太小 → 表示能力差、成本高 | 词表选择影响模型学到的表示质量,进而影响任务表现;词表大小需与模型规模、语言数匹配 |
|
||||||
|
| **多语言不公平** | 低资源语言生成等长句子需多出数量级的 token | 跨语言评测中,不同语言的"同量内容"成本不同;评测多语言模型时需考虑 token 数差异 |
|
||||||
|
| **罕见 token** | 罕见 token(如用户名)可能被关联到特定内容 | 可能造成模型在特定输入上的"意外行为";识别与检测见 SolidGoldMagikarp / Cohere 论文 |
|
||||||
|
| **数字切分** | 数字 token 化方式尚无定论,可能影响数学推理 | 评测数学/推理基准(如 MATH 类任务)时,数字 token 化方式可能影响分数 |
|
||||||
|
| **上下文窗口** | few-shot 示例可能放不进 context window(旧模型) | 设计 few-shot 评测时需考虑模型上下文长度,示例数量受限制 |
|
||||||
|
| **log-prob 归一化** | 选项 log-prob 最后可按选项长度归一化 | 多项选择评测时,不同选项长度不同,归一化避免长选项"天然"得分更高 |
|
||||||
|
|
||||||
|
> 一句话总结:**tokenizer 不是评测的"前处理细节",而是会实际改变评测成本、跨语言公平性和最终分数**的东西。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 四、参考资料
|
||||||
|
|
||||||
|
### 原文(GitHub blob)
|
||||||
|
|
||||||
|
- [contents/general-knowledge/model-inference-and-evaluation.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/general-knowledge/model-inference-and-evaluation.md)
|
||||||
|
- [contents/general-knowledge/tokenization.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/general-knowledge/tokenization.md)
|
||||||
|
- 指南仓库主页:[huggingface/evaluation-guidebook](https://github.com/huggingface/evaluation-guidebook)
|
||||||
|
|
||||||
|
### 文中提到的外部链接
|
||||||
|
|
||||||
|
**评测方法 / 推理**
|
||||||
|
|
||||||
|
- ⭐ [Blog on several ways to evaluate MMLU](https://huggingface.co/blog/open-llm-leaderboard-mmlu)(HuggingFace 团队)
|
||||||
|
- ⭐ [Mathematical formalization of inference methods(EleutherAI)](https://arxiv.org/abs/2405.14782v2)
|
||||||
|
- [Anthropic:calibration 教程](https://arxiv.org/abs/2207.05221)
|
||||||
|
- [校准的局限](https://arxiv.org/abs/2311.14648)
|
||||||
|
- [GAIA 论文](https://huggingface.co/papers/2311.12983) 及其 [leaderboard](https://huggingface.co/spaces/gaia-benchmark/leaderboard)
|
||||||
|
- [Training on the test task(few-shot 过拟合)](https://arxiv.org/abs/2407.07890)
|
||||||
|
- [结构化输出评测博客](https://huggingface.co/blog/evaluation-structured-outputs)
|
||||||
|
- [结构化生成降低推理性能的研究](https://arxiv.org/abs/2408.02442)
|
||||||
|
|
||||||
|
**约束输出 / 结构化生成**
|
||||||
|
|
||||||
|
- ⭐ [Outlines:FSM 工作原理](https://blog.dottxt.co/coalescence.html)
|
||||||
|
- [outlines 博客](https://blog.dottxt.co/)
|
||||||
|
- [outlines 方法论文](https://arxiv.org/abs/2307.09702)
|
||||||
|
- [Interleaved generation(guidance 库)](https://github.com/guidance-ai/guidance?tab=readme-ov-file#guidance-acceleration)
|
||||||
|
|
||||||
|
**Tokenization**
|
||||||
|
|
||||||
|
- ⭐ [🤗 NLP Course:tokenization 方法总览](https://huggingface.co/learn/nlp-course/en/chapter2/4)
|
||||||
|
- ⭐ [🤗 Transformers 文档:tokenizer 概念指南](https://huggingface.co/docs/transformers/en/tokenizer_summary)
|
||||||
|
- [Jurafsky:tokenization 课程(看 2.5 / 2.6 节)](https://web.stanford.edu/~jurafsky/slp3/2.pdf)
|
||||||
|
- ⭐ [🤗 NLP Course:BPE 详解](https://huggingface.co/learn/nlp-course/en/chapter6/5)
|
||||||
|
- [BPE 引入 NLP 的论文](https://aclanthology.org/P16-1162/)
|
||||||
|
|
||||||
|
**罕见 token 与多语言**
|
||||||
|
|
||||||
|
- ⭐ [SolidGoldMagikarp(Less Wrong)](https://www.lesswrong.com/posts/aPeJE8bSo6rAFoLqg/solidgoldmagikarp-plus-prompt-generation)
|
||||||
|
- [Fishing for Magikarp(Cohere)](https://arxiv.org/abs/2405.05417)
|
||||||
|
- ⭐ [Yennie Jun:跨语言 tokenization 分析](https://www.artfish.ai/p/all-languages-are-not-created-tokenized) + [demo](https://huggingface.co/spaces/yenniejun/tokenizers-languages)
|
||||||
|
- ⭐ [Aleksandar Petrov:tokenization 不公平性 demo](https://aleksandarpetrov.github.io/tokenization-fairness/)
|
||||||
|
- ⭐ [Yennie Jun:数字切分可视化](https://www.artfish.ai/p/how-would-you-tokenize-or-break-down)
|
||||||
|
- [Beren Millidge:数字 tokenization 小史](https://www.beren.io/2024-05-11-Integer-tokenization-is-now-much-less-insane/)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
> 关联笔记:本目录 [[00-Overview]];指南其余章节提炼笔记([[01-Automatic-Benchmarks]]、[[02-Human-Evaluation]]、[[03-LLM-as-a-Judge]]、[[04-Troubleshooting]]、[[06-Yearly-Dives]]、[[07-Resources]])。
|
||||||
+542
@@ -0,0 +1,542 @@
|
|||||||
|
---
|
||||||
|
type: reference
|
||||||
|
tags:
|
||||||
|
- llm-evaluation
|
||||||
|
- evaluation-guidebook
|
||||||
|
- yearly-dives
|
||||||
|
status: active
|
||||||
|
created: 2026-08-21
|
||||||
|
source: https://github.com/huggingface/evaluation-guidebook
|
||||||
|
---
|
||||||
|
|
||||||
|
# Yearly Dives —— 年度深度文章(2023–2025)
|
||||||
|
|
||||||
|
> 本页提炼自 HuggingFace Evaluation Guidebook 的 `yearly_dives/` 三个文件(2023 / 2024 / 2025 各一篇年度深度文章),用中文概括其核心观点、数据与讨论话题。文中保留原文的具体链接、论文、模型名、benchmark 名与关键数字,**不补充原文没有的内容**;论文编号(如 2302.04844)均为 arXiv 号,链接统一放在各条目内。回到原文请见文末「参考资料」。
|
||||||
|
|
||||||
|
## 2023:开源 LLM 之年(Year of open LLMs)
|
||||||
|
|
||||||
|
> 原文:`yearly_dives/2023-year-of-open-source.md`,首发于 HuggingFace 博客 [2023-in-llms](https://huggingface.co/blog/2023-in-llms)。
|
||||||
|
|
||||||
|
### 写作背景与立场
|
||||||
|
|
||||||
|
- Hugging Face 关注开源模型,因为开源让研究可复现、让社区能参与 AI 开发、便于审查模型偏见与局限,并通过复用 checkpoint 降低领域整体碳排放([更多好处见论文 2302.04844](https://huggingface.co/papers/2302.04844))。
|
||||||
|
- 范围说明:本文**不讨论代码模型**。
|
||||||
|
- 文章目标:做一次开源 LLM 的年度回顾(retrospective)。
|
||||||
|
|
||||||
|
### 预训练大模型的"配方"(Recipe)
|
||||||
|
|
||||||
|
先讲清楚"大模型从哪来"(熟悉可跳过):
|
||||||
|
|
||||||
|
- **架构(architecture)**:模型的具体实现与数学形态——所有参数及其与输入交互的方式。当下大多数高性能 LLM 都是 decoder-only Transformer 的变体([原始 Transformer 论文 1706.03762](https://huggingface.co/papers/1706.03762))。
|
||||||
|
- **训练数据集**:模型学习的全部样本与文档,决定了学到的具体模式。内容通常是自然语言(法/英/中文等)、编程语言(Python、C 等)、或任何可用文本表达的结构化数据(markdown/latex 表格、公式等)。
|
||||||
|
- **分词器(tokenizer)**:把文本转成数字的方式,切成 token(词、子词或字符)。词表大小通常 32k–200k。数据集规模常用 token 数衡量,如今从数千亿到数万亿 token。
|
||||||
|
- **训练超参数**:决定模型如何学习——参数该为每个新样本变多少?模型该多快更新?
|
||||||
|
- 选定后还需要:① 大量算力 ② 负责训练与监控的(善良且称职的)人。
|
||||||
|
- 训练产物是**权重(weights)**——即人们讨论"开源预训练模型"时通常指的东西;权重用于**推理(inference)**(对新输入做预测、生成文本)。
|
||||||
|
- 预训练后可做**微调(fine-tuning)**:在更小、更专业的数据上继续训练以适配特定应用。成本(算力/金钱/环境)远低于从零训练——这正是高质量开源预训练模型价值巨大的原因:算力有限的从业者也能自由使用和基于它构建。
|
||||||
|
|
||||||
|
### 2022:从"规模竞赛"到"数据竞赛"
|
||||||
|
|
||||||
|
#### 2022 年及以前的开源模型格局
|
||||||
|
|
||||||
|
- 直到 2022 年初,ML 的趋势是:模型越大(参数越多)性能越好;超过特定规模阈值后能力跃升——两个概念被命名为 `emergent abilities`(涌现能力)与 `scaling laws`(缩放定律)。
|
||||||
|
- 2022 年发布的开源预训练模型族基本遵循这一范式,具体如下表:
|
||||||
|
|
||||||
|
| 模型族 | 发布方 | 最大规模 | 训练数据 | 要点 |
|
||||||
|
|---|---|---|---|---|
|
||||||
|
| BLOOM | BigScience(HF 协调) | 176B 参数 | 350B token,46 种人类语言 + 13 种编程语言 | 当时最大开源多语言模型 |
|
||||||
|
| OPT | Meta | 175B 参数 | 180B token,多数公开来源 | 性能与 GPT-3 相当,算力更省 |
|
||||||
|
| GLM-130B | 清华 + 智谱 AI | 130B 参数 | 400B token(The Pile、Wudao 等中英数据) | 性能与 GPT-3 相当 |
|
||||||
|
| Galactica | Meta | 最高 120B | 106B token 科学文献 | 面向科学的专业模型 |
|
||||||
|
| GPT-NeoX-20B | EleutherAI | 20B | 500B token | 架构/权重/数据全开源 |
|
||||||
|
|
||||||
|
- **BLOOM**([论文 2211.05100](https://huggingface.co/papers/2211.05100)):BigScience 是约 1000 名研究者、60 国、250 机构参与的合作项目,与法国 GENCI/IDRIS 合作。decoder-only + 微小改动(post embedding normalization、ALiBi 位置编码)。大部分训练数据连同来源、策展、处理细节一起公开。
|
||||||
|
- **OPT**([论文 2205.01068](https://huggingface.co/papers/2205.01068)):decoder-only,沿用 GPT-3 论文技巧(特定权重初始化、pre-normalization),注意力改为 dense 与 locally banded attention 交替;数据来自图书、Reddit、新闻、Wikipedia 等。
|
||||||
|
- **GLM-130B**([论文 2210.02414](https://huggingface.co/papers/2210.02414)):full transformer + DeepNorm post-layer-normalization + rotary embeddings;数据含 The Pile、Wudao Corpora 及其他中文语料。
|
||||||
|
- **Galactica** 与 **GPT-NeoX-20B**:多为研究目的发布(GPT-NeoX 提供完整科研产物,RoPE + 注意力/初始化改动)。
|
||||||
|
- **昂贵的大模型**:100B 参数模型加载通常需约 **220GB 内存**,绝大多数组织与从业者无法企及。
|
||||||
|
|
||||||
|
#### Chinchilla 范式转变
|
||||||
|
|
||||||
|
- 2022 年 3 月 DeepMind 论文([2203.15556](https://huggingface.co/papers/2203.15556))研究:给定算力预算,token 数与参数数的最优比例是多少?
|
||||||
|
- 结论:对平均算力预算,模型应**更小但训练数据更多**。
|
||||||
|
- 其模型 Chinchilla(不开源):70B 参数(约为上述模型的 1/3),却训练在 1.4T token(3–4 倍数据),性能持平或更好。
|
||||||
|
- 这一转变"席卷"了开源科学社区(闭源实验室或许早已知道)。
|
||||||
|
|
||||||
|
### 2023:开源发布之年
|
||||||
|
|
||||||
|
#### 小型 LLM 的崛起
|
||||||
|
|
||||||
|
- 2023 年出现一波 decoder transformer 浪潮,新预训练模型从每月、到每周甚至每天发布:
|
||||||
|
|
||||||
|
| 月份 | 模型 / 发布方 |
|
||||||
|
|---|---|
|
||||||
|
| 2 月 | LLaMA(Meta) |
|
||||||
|
| 4 月 | StableLM(StabilityAI)、Pythia(EleutherAI) |
|
||||||
|
| 5 月 | MPT(MosaicML) |
|
||||||
|
| 6 月 | X-GEN(Salesforce)、Falcon(TIIUAE) |
|
||||||
|
| 7 月 | Llama 2(Meta) |
|
||||||
|
| 8 月 | StableLM v2(StabilityAI) |
|
||||||
|
| 9 月 | Qwen(阿里)、Mistral(Mistral.AI) |
|
||||||
|
| 11 月 | Yi(01-ai) |
|
||||||
|
| 12 月 | DeciLM(Deci)、Phi-2、SOLAR(Upstage) |
|
||||||
|
|
||||||
|
- 共同点:a) 发布权重(许可证开放程度不一)b) 小尺寸(3B–70B)性能良好,被社区迅速采用。
|
||||||
|
- 架构共性:几乎都是 decoder transformer 变体(ALiBi/RoPE、RMS pre-normalization、SwiGLU),注意力有 Flash-Attention、GQA、sliding windows 等改动,代码库实现各异(优化训练或推理速度)。
|
||||||
|
- 既然架构与权重都公开,核心差异只剩**训练数据与许可证**。
|
||||||
|
|
||||||
|
#### 主要模型逐个看
|
||||||
|
|
||||||
|
- **LLaMA**(Meta AI,[论文 2302.13971](https://huggingface.co/papers/2302.13971)):在给定算力预算下追求最佳性能;首次显式同时考虑训练预算与**推理成本**——用更小模型 + 更多数据 + 更多训练步数换更高性能(牺牲训练算力效率)。最大 65B / 1.4T token,6B 与 13B / 1T token。13B 在多数 benchmark 上超过 GPT-3,最大版本发布时 SOTA。但权重为**非商用许可证**,限制了社区采用。
|
||||||
|
- **Pythia**(EleutherAI,[论文 2304.01373](https://huggingface.co/papers/2304.01373)):不同尺寸的[模型套件](https://huggingface.co/collections/EleutherAI/pythia-scaling-suite-64fb5dfa8c21ebb3db7ad2e1),完全公开数据训练,用于研究 LLM 训练各阶段。
|
||||||
|
- **MPT**(MosaicML,[博客](https://www.mosaicml.com/blog/mpt-7b)):性能接近但**许可证允许商用**,且公开训练数据构成。首个 [7B](https://huggingface.co/mosaicml/mpt-7b),6 月跟进 30B,均 1T token(C4、CommonCrawl、The Stack、S2ORC)。
|
||||||
|
- **Falcon**(TIIUAE):[7B/30B](https://huggingface.co/tiiuae/falcon-7b),1–1.5T token 英语与代码(RefinedWeb、Project Gutenberg、Reddit、StackOverflow、GitHub、arXiv、Wikipedia 等),年底发布 180B。数据与训练流程有技术报告及[后续论文 2311.16867](https://huggingface.co/papers/2311.16867)。
|
||||||
|
- **StableLM**(StabilityAI):继承 GPT-NeoX,3B/7B,1.5T token(ThePile 实验数据集);v2 系列混入 RefinedWeb、RedPajama、ThePile 及未公开数据;另有 3B 的 [StableLM-3B-4e1T](https://huggingface.co/stabilityai/stablelm-3b-4e1t) + [详细技术报告](https://stability.wandb.io/stability-llm/stable-lm/reports/StableLM-3B-4E1T--VmlldzoyMjU4?accessToken=u3zujipenkx5g7rtcj9qojjgxpconyjktjkli2po09nffrffdhhchq045vp0wyfo)。
|
||||||
|
- **转折点**:早期发布公开数据;此后发布几乎**不提供训练数据信息、不可复现**,但通过权重为社区提供起点。
|
||||||
|
- **X-Gen**(Salesforce,[论文 2309.03450](https://huggingface.co/papers/2309.03450)):7B,1.5T token "natural language and code",分步训练 + 数据调度(不是所有数据同时进入)。
|
||||||
|
- **LLaMA-2**(Meta,[论文 2307.09288](https://huggingface.co/papers/2307.09288)):7–70B,2T token "公开来源",permissive 社区许可证 + 大规模 RLHF 人类偏好微调(alignment)。安全是突出卖点。
|
||||||
|
- **Mistral-7B**(新创公司 Mistral,[论文 2310.06825](https://huggingface.co/papers/2310.06825)):训练 token 数与来源未公开("extracted from the open Web")。年底另有更大尺寸的 **Mixtral 8x7B**。
|
||||||
|
- **DeciLM**(Deci.AI)与 **SOLAR 10.7B**(Upstage):同样未公开数据来源与数量;这些模型在排行榜与开源 benchmark 上稳步提升。
|
||||||
|
- **中国模型的崛起**:年底一批双语(中英)开源模型性能领先——**Qwen**(阿里,[论文 2309.16609](https://huggingface.co/papers/2309.16609),7–70B,2.4T token)、**Yi**(01-AI,6–34B,3T token),在 [Open LLM Leaderboard](https://huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard) 与最难的 benchmark(如 [Skill-Mix 2310.17567](https://huggingface.co/papers/2310.17567))上都更进一步;**DeepSeek** 编码模型从零训练,2T token,87% 代码 + 13% 中英自然语言(基本是代码模型)。
|
||||||
|
|
||||||
|
#### 对话模型遍地开花
|
||||||
|
|
||||||
|
- 相比 2022,2023 年几乎所有预训练模型都同时发布对话微调版本,凸显大众对 chat 模型的使用增长,以及"聊天式手工评测(vibe-check)"的流行。
|
||||||
|
- 主要适配方法(变体很多):
|
||||||
|
|
||||||
|
| 方法 | 原理 | 特点/成本 |
|
||||||
|
|---|---|---|
|
||||||
|
| Chat-based fine-tuning | 在对话数据(多轮、社交网络风格)上监督微调,decoder 逐 token 自回归 | 实现简单,需对话数据集 |
|
||||||
|
| Instruction fine-tuning(IFT) | 用指令数据集(query + 答案)教模型遵循指令 | 数据可人工或 LLM 生成 |
|
||||||
|
| 蒸馏(distillation) | 用高性能模型(如 GPT-4)的输出做合成数据集再微调 | 大规模合成数据的常用方式 |
|
||||||
|
| RLHF | 生成多答案 → 人类排序 → 训练偏好模型 → 强化学习微调 | 成本高,多用于安全对齐 |
|
||||||
|
| RLAIF | 用高质量 LLM 而非人类排序 | RLHF 的廉价变体 |
|
||||||
|
| DPO | 直接优化:对齐模型同时就是偏好模型,用偏好数据更新 | 无单独偏好模型,性能相当 |
|
||||||
|
|
||||||
|
- 参考资料:对话/指令微调入门见 [dialog-agents 博客](https://huggingface.co/blog/dialog-agents);RLHF 见 [RLHF 博客](https://huggingface.co/blog/rlhf)、[原始 RLHF 论文 1909.08593](https://huggingface.co/papers/1909.08593)、[Anthropic RLHF 论文 2204.05862](https://huggingface.co/papers/2204.05862)。
|
||||||
|
- 落地情况:MPT-7B 有 instruct 与 chat 版,Falcon、XGen 年末出 instruct 版,Llama-2、Qwen、Yi 有 chat 版,DeciLM 有 instruct 版。
|
||||||
|
|
||||||
|
#### 社区做了什么
|
||||||
|
|
||||||
|
围绕基础模型,微调社区在 Reddit、Discord、HF Hub、Twitter 上自发繁荣;社区模型发布频繁,同时催生大量新数据集。
|
||||||
|
|
||||||
|
**早期(2023 年初前)的数据集**
|
||||||
|
|
||||||
|
- 人类偏好类:WebGPT(OpenAI)、HH-RLHF(Anthropic)、Summarize(OpenAI)。
|
||||||
|
- 指令类:P3(BigScience,Public Pool of Prompts)、FLAN 1/2(Google)、Natural Instructions(AllenAI)、Self Instruct(自动生成指令框架)、SuperNatural instructions(专家构建,常作微调数据)、Unnatural instructions(特拉维夫大学 + Meta 自动生成)。
|
||||||
|
|
||||||
|
**2023 全年社区事件时间线**
|
||||||
|
|
||||||
|
| 季节 | 事件 / 数据集 / 模型 |
|
||||||
|
|---|---|
|
||||||
|
| ❄️ 冬(2022/23) | 1 月 HC3(人类 vs 模型回答);3 月 Alpaca(Stanford,52K 指令)、OIG(LAION,43M 指令)、Vicuna(LMSYS,ShareGPT 对话)、Guanaco(+500K 多语言条目) |
|
||||||
|
| 🌱 春 | 4 月 Koala(BAIR)、Dolly(DataBricks,15K 人工指令);5 月 UltraChat(1.5M 对话)与 UltraLLaMA、GPT4-LLM;6 月 Orca(推理轨迹构造指令)、Open Orca、Camel-AI 多主题数据集、Airoboros 框架 |
|
||||||
|
| 🌻 夏 | 8 月 UltraLM(OpenBMB);9 月 UltraFeedback(GPT-4 标注偏好)、OpenChat(清华,新 RL 策略)、Intel orca_dpo_pairs;夏天 NousResearch 多个微调(Hermes、Capybara) |
|
||||||
|
| 🍂 秋 | 10 月 Zephyr(HF,DPO + AIF)、OpenHermes 2(900K 条目)、LMSYS-Chat-1M(25 个 LLM 真实对话);11 月 OpenBuddy-Zephyr、Notus(Argilla)、HelpSteer(NVIDIA)、Orca-2(Microsoft)、Neural Chat(Intel);12 月 Starling(Berkeley,RLAIF)+ Nectar(200K 对比) |
|
||||||
|
|
||||||
|
- 细节补充(冬季):Alpaca 是第一个指令跟随 LLaMA(7B),52K 条 LLM 生成指令;Vicuna(13B)用 ShareGPT 上用户分享的 ChatGPT 对话微调。
|
||||||
|
- 细节补充(春季):Koala 用 Alpaca/HH-RLHF/WebGPT/ShareGPT 微调;Orca 方法很快被社区复现为 Open Orca(数百万条,用于微调 Llama、Mistral 等)。
|
||||||
|
- 细节补充(夏季):UltraFeedback 是 GPT-4 标注的偏好数据集;Intel 发布 Orca 风格 DPO 数据集。
|
||||||
|
- 细节补充(秋季):Zephyr 是 Mistral 在 UltraChat/UltraFeedback 上用 DPO + AIF 微调;Notus 是 Zephyr 的 DPO 微调;HelpSteer 提供 prompt + 回答 + 多标准打分;Orca-2 是 Llama 2 + 新合成推理数据集。
|
||||||
|
- 专项数据集(不展开):MetaMath、MathInstruct、Evol-Instruct、CodeAlpaca、CodeCapybara 等;汇总见 [awesome instruction datasets](https://github.com/jianzhnie/awesome-instruction-datasets)。
|
||||||
|
|
||||||
|
### 民主化访问(Democratizing access)
|
||||||
|
|
||||||
|
- 注:llama.cpp、ollama、text-generation-inference、vllm 等推理/部署工具不在本文范围。
|
||||||
|
|
||||||
|
#### 模型合并(Model merging):极致定制
|
||||||
|
|
||||||
|
- 定义:把多个模型权重融合成一个,理想情况结合各自优势。
|
||||||
|
- 方法:简单平均共同架构模型的参数([例 1 2204.03044](https://huggingface.co/papers/2204.03044)、[例 2 2109.01903](https://huggingface.co/papers/2109.01903));更复杂的有按任务加权平均([2111.09832](https://huggingface.co/papers/2111.09832))、考虑参数间干扰再选择的 ties merging([2306.01708](https://huggingface.co/papers/2306.01708))。
|
||||||
|
- 综述见 [model merging 论文集合](https://huggingface.co/collections/osanseviero/model-merging-65097893623330a3a51ead66)。
|
||||||
|
- 后果:Open LLM Leaderboard 上出现 `llama2-zephyr-orca-ultra` 这类名字;数据与模型历史难追踪(参见 Mistral 的 [child models tree](https://huggingface.co/spaces/davanstrien/mistral-graph))。
|
||||||
|
- 这是"完全去中心化研究"的典型:方法多发表在社区论坛,由全球实践者/研究者/爱好者共同推进。
|
||||||
|
|
||||||
|
#### PEFT:指尖上的个性化
|
||||||
|
|
||||||
|
- 定义:冻结预训练模型参数,在其上加少量新参数(adapters),只训练轻量 adapter。
|
||||||
|
- 好处:内存不够加载整个模型微调时也能个性化;共享时只需共享 adapter + 基础模型。
|
||||||
|
- 方法列表见 [huggingface/peft](https://github.com/huggingface/peft)。
|
||||||
|
|
||||||
|
#### 量化(Quantization):模型随处可跑
|
||||||
|
|
||||||
|
- 背景:30B 模型仅加载就需 66G+ RAM,不是人人都有这样的硬件。
|
||||||
|
- 原理:降低参数精度(float32/float16/int8 等)减小体积与内存;精度越低内存越小,但计算精度降低可能损伤性能——大模型上性能损失通常很[有限](https://huggingface.co/blog/overview-quantization-transformers)。
|
||||||
|
- 数字示例(30B 模型):float16 略小于 66G RAM,8bit 约 33G,4bit 约 16G。
|
||||||
|
- 常用方法:bitsandbytes([2208.07339](https://huggingface.co/papers/2208.07339))、GPTQ([2210.17323](https://huggingface.co/papers/2210.17323))、AWQ([2306.00978](https://huggingface.co/papers/2306.00978))。
|
||||||
|
- 社区角色:如 [TheBloke](https://huggingface.co/TheBloke) 专门把流行模型转成低精度版本供社区使用。
|
||||||
|
- 原文评价:这些方法都很新、仍在发展,期待更多进展。
|
||||||
|
|
||||||
|
### 接下来是什么?(2023 年底)
|
||||||
|
|
||||||
|
- **MoE(混合专家)**:**Mixtral** 由 8 个子模型(transformer decoder)组成,router 为每个输入挑选 2 个最优子模型并求和输出。
|
||||||
|
- **状态空间模型**(通过潜在空间做输入输出映射,可表达为 RNN 或 CNN;入门见 [Annotated S4](https://srush.github.io/annotated-s4/)):
|
||||||
|
- **Mamba**([2312.00752](https://huggingface.co/papers/2312.00752)):状态空间模型 + 选择机制。
|
||||||
|
- **Striped Hyena**([HF 模型页](https://huggingface.co/togethercomputer/StripedHyena-Nous-7B)):状态空间模型 + 快速卷积核。
|
||||||
|
- 是否取代 Transformer 还太早下结论,但状态空间模型很有前景。
|
||||||
|
|
||||||
|
### Takeaways(要点)
|
||||||
|
|
||||||
|
1. 各类参与者(大公司、初创、研究实验室)的开源发布大幅增长,社区以前所未有的速度实验与探索。
|
||||||
|
2. 开放性有起有伏:年初发布很开放(数据构成、权重、架构),年末发布对训练数据讳莫如深、不可复现。
|
||||||
|
3. 开源模型从许多新地方涌现,包括中国,多个新参与者成为强竞争者。
|
||||||
|
4. 个性化手段达到新高:RLHF、adapters、模型合并——都还只是开始。
|
||||||
|
5. 更小模型 + 量化进步让 LLM 真正走近更多人。
|
||||||
|
6. 新架构出现——它们会最终取代 Transformer 吗?
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 2024:聊聊 LLM 评测(ICLR 2024 上的讨论与反思)
|
||||||
|
|
||||||
|
> 原文:`yearly_dives/2024-evals-thoughts-from-iclr.md`,首发于 [HuggingFace 博客](https://huggingface.co/blog/clefourrier/llm-evaluation)。
|
||||||
|
|
||||||
|
### 背景
|
||||||
|
|
||||||
|
- 作者(Hugging Face 评测与排行榜团队成员)在 ICLR 2024 与大量与会者交流后,意识到很多自己"习以为常"的评测观念并不普及且引人兴趣,于是把讨论整理成文。
|
||||||
|
- 文章的自我定位:把这些对话"更广泛地分享"出来。
|
||||||
|
|
||||||
|
### 评测的三种方式
|
||||||
|
|
||||||
|
当前主要有三种评测方式:**自动化基准(automated benchmarking)**、**人类作评委(humans as judges)**、**模型作评委(models as judges)**。
|
||||||
|
|
||||||
|
| 方式 | 代表做法 | 主要优点 | 主要问题 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| 自动化基准 | 任务/能力 + 样本 + 指标 | 便宜、可复现、任务层面有信号 | 污染、能力难定义、评分受 prompt 等细节影响 |
|
||||||
|
| 人类作评委 | vibe-checks、arena、系统化标注 | 灵活、规避污染、贴近人类偏好 | 贵、小规模不可复现、心理偏差 |
|
||||||
|
| 模型作评委 | 通用强模型或专用判别模型 | 便宜、可扩展 | 微妙且不可解释的偏差、自偏爱 |
|
||||||
|
|
||||||
|
各有其存在理由、用途与局限,下面分述。
|
||||||
|
|
||||||
|
### 自动化基准(Benchmarks)
|
||||||
|
|
||||||
|
#### 基本构成
|
||||||
|
|
||||||
|
- 先定义评测对象:具体**任务**(如"垃圾邮件分类")或抽象**能力**(如"数学好不好")。
|
||||||
|
- 评测由两部分组成:**样本集** + **指标(metric)**。
|
||||||
|
- 样本集:输入给模型看输出,必要时带参考(gold)对比;样本通常尽量模拟目标场景(含困难边界用例)。
|
||||||
|
- 对 LLM 主要是两种:**生成式评测**(归一化后与参考文本比较)与**多选式评测**(比较 prompt 后各候选续写的相对 log-probability)。
|
||||||
|
- 指标:为模型算分的方式(如分类正确率,答对=1、答错=0)。
|
||||||
|
|
||||||
|
#### 泛化与过拟合
|
||||||
|
|
||||||
|
- 应优先在**未进入训练集**的数据上评测——测试**泛化**能力。
|
||||||
|
- 只能预测训练数据称 **overfitting(过拟合)**;次极端情况也要测对分布外模式的泛化(如只见过"假银行"垃圾邮件,要能泛化到"保健品"垃圾邮件)。
|
||||||
|
|
||||||
|
#### 已知问题
|
||||||
|
|
||||||
|
- 对定义明确的任务很有效;LLM 场景的问题:
|
||||||
|
- 多选评测中模型会[按选项呈现顺序偏好特定选项](https://arxiv.org/abs/2309.03882)。
|
||||||
|
- 生成式评测的归一化[设计不好就不公平](https://huggingface.co/blog/open-llm-leaderboard-drop)。
|
||||||
|
- 但任务层面仍有信号。
|
||||||
|
- 能力很难分解成精确定义的任务("数学好"指算术、逻辑还是概念推理?),于是做**整体式(holistic)评测**:假定通用样本上的表现是目标能力的**好代理**。
|
||||||
|
- 例:GSM8K 是真实高中题,解题需要整套能力,失败与成功都难解释。
|
||||||
|
- 更抽象的能力(写诗、答案有用性)更难自动评测;而模型越来越**通才化**,需要更广的评测。
|
||||||
|
- 例:学界争论 LLM 到底[会不会画独角兽](https://arxiv.org/abs/2303.12712)——多数情况不会,但值得研究。
|
||||||
|
|
||||||
|
#### 污染(contamination)
|
||||||
|
|
||||||
|
- 定义:评测数据集进入训练集;被污染的模型 benchmark 分高但泛化差(详述见 [2023.findings-emnlp.722](https://aclanthology.org/2023.findings-emnlp.722/),趣味检测方法见 [2311.06233](https://arxiv.org/abs/2311.06233))。
|
||||||
|
- 缓解手段:
|
||||||
|
- BigBench 的 **canary string**(特定字符组合供人识别并剔除),但并非所有人都知道或照做。
|
||||||
|
- [加密形式提供](https://arxiv.org/pdf/2309.16575)、[门控访问](https://huggingface.co/datasets/Idavidrein/gpqa)。
|
||||||
|
- 但黑盒 API 评测无法保证数据不被内部用于训练/微调。
|
||||||
|
- 应对:**动态基准**([2104.14337](https://arxiv.org/abs/2104.14337),定期刷新数据,在系统性未见的新数据上打分),但长期成本高。
|
||||||
|
|
||||||
|
### 人类作评委(Human as a judge)
|
||||||
|
|
||||||
|
- 做法:让人类先 prompt 模型,再按指南给模型答案打分或对多个输出排序。
|
||||||
|
- 优点:可评测更复杂开放的任务、比自动指标灵活;prompt 是新写的,基本规避污染;与人类偏好天然相关(评的正是这个)。
|
||||||
|
|
||||||
|
#### 三种人类评测路径
|
||||||
|
|
||||||
|
- **Vibe-checks**:社区成员用未公开 prompt 手工感受模型质量(范围从编码到"烂文质量",也有人称 canary-testing,取自矿井金丝雀)。
|
||||||
|
- 常在 Twitter/Reddit 分享,属轶事证据、易受确认偏差影响(人们往往找到自己想找的)。
|
||||||
|
- 但也有系统性做法,如用户 Wolfram Ravenwolf 的[模型对比博客](https://huggingface.co/blog/wolfram/llm-comparison-test-llama-3)。
|
||||||
|
- **Arena(竞技场)**:用社区反馈做大规模模型排名,如 [LMSYS Chatbot Arena](https://huggingface.co/spaces/lmsys/chatbot-arena-leaderboard)——用户盲聊,发现更好的就投票,投票聚合成 **Elo 排名**。
|
||||||
|
- 问题:主观性强,宽泛指南难以让众多社区成员稳定打分。
|
||||||
|
- 标注者偏好有[文化差异](https://arxiv.org/abs/2404.16019v1)(不同人偏好不同话题)。
|
||||||
|
- 寄望"群众智慧"(Galton 的"猜猪重"统计故事:个体估计围绕真实值呈概率分布)在大规模投票下平滑掉偏差。
|
||||||
|
- **系统化标注**:给付费精选标注者极具体指南,尽量去除主观偏差(ScaleAI 等标注公司的做法,见 [Scale 指南](https://scale.com/guides/data-labeling-annotation-guide#hight-quality-data-annotations))。
|
||||||
|
- 问题:持续、非自动化地评测会很快变得极贵。
|
||||||
|
- 仍可能有人类偏差:[2205.00501](https://arxiv.org/abs/2205.00501) 显示不同身份者对模型答案毒性打分差异很大。
|
||||||
|
|
||||||
|
#### 人类评委的已知偏差
|
||||||
|
|
||||||
|
- 评测者倾向按**第一印象**而非实际事实性/忠实性估质量([2309.16349](https://arxiv.org/pdf/2309.16349)):
|
||||||
|
- 众包标注者对语气敏感、会低估自信语气答案中的事实/逻辑错误。
|
||||||
|
- 模型用自信语气说错话,人类更不容易察觉,评分会偏向更"自信"的模型。
|
||||||
|
- 专家标注者更不易受影响。
|
||||||
|
- 人类更偏好**迎合自己观点或与自己的错误一致**的答案,而非事实正确的答案([2310.13548](https://arxiv.org/pdf/2310.13548))。
|
||||||
|
- 启示:需要事实性的任务(写代码、模型知识评测等)不应只依赖众包非专家人工标注,应叠加更稳健的评测方式。
|
||||||
|
|
||||||
|
### 模型作评委(Model as a judge)
|
||||||
|
|
||||||
|
- 动机:降低人工标注成本。2019 年已有用[模型嵌入测摘要质量](https://arxiv.org/abs/1904.09675)的技术,此思路并不新。
|
||||||
|
- 两种打分方式:
|
||||||
|
- 用**通用高能力模型**([2306.05685](https://arxiv.org/abs/2306.05685v4)):与人类偏好相关性好,但够强的模型多为闭源,API 背后会变、不可解释。
|
||||||
|
- 用**专门从偏好数据训练的小型判别模型**([2405.01535](https://arxiv.org/pdf/2405.01535))。
|
||||||
|
- 已知局限:
|
||||||
|
- 评分时[偏爱自己的输出](https://arxiv.org/abs/2404.13076)。
|
||||||
|
- 分数范围不一致(可让模型[先解释推理再打分](https://twitter.com/seungonekim/status/1749289437165769177)改善)。
|
||||||
|
- 与人类排名[并不一致](https://arxiv.org/pdf/2308.15812)。
|
||||||
|
- 作者的个人担忧:模型作评委会在答案选择中引入**微妙且不可解释的偏差**——类比遗传学中过度杂交产生缺陷后代,用 LLM 选择和训练 LLM,很可能在若干代后放大微小变化;小型专用模型(如毒性分类器)风险较低,但尚待严格验证。
|
||||||
|
|
||||||
|
### 为什么要做评测?——三个被混淆的目的
|
||||||
|
|
||||||
|
作者认为评测有三个**截然不同**的目的,常被混为一谈,各自回答不同问题:
|
||||||
|
|
||||||
|
| 目的 | 回答的问题 | 关键做法 | 作者的观点 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| 非回归测试 | 我的训练对吗? | 看分数轨迹与区间 | 不关心精确分数,只要"没坏" |
|
||||||
|
| 排行榜与排名 | 哪个模型最好? | 找稳定一致的排名 | 分数不可靠,排名更稳 |
|
||||||
|
| 领域能力水平 | 我的模型能做 X 吗? | 定义能力 + 找代理任务 | 目前无法真正评测"通用能力" |
|
||||||
|
|
||||||
|
#### 1) 非回归测试(non-regression testing)
|
||||||
|
|
||||||
|
- 概念源自软件工程:加新功能或修 bug 后,确认没破坏整体行为。
|
||||||
|
- 对训练:确认训练设置变更(数据、架构、参数等)没有"破坏"同属性模型的预期性能。
|
||||||
|
- 看两点:① 分数**轨迹**(是否比开始时好)② 分数**区间**(是否在预期范围)。
|
||||||
|
- 例:7B 基础模型 MMLU 预期 50–65;20–30 说明没学到东西。
|
||||||
|
- 你其实……不关心精确分数。
|
||||||
|
- 甚至只看文本 perplexity 变化都可能够。
|
||||||
|
- 但通常要"信噪比"高的 benchmark(大分数变化反映大模型变化)。
|
||||||
|
|
||||||
|
#### 2) 排行榜与排名(Leaderboards and rankings)
|
||||||
|
|
||||||
|
- 作用:排序选型——排行榜第一的不适合你的用例,第二名多半也不行。
|
||||||
|
- ImageNet 时代的经验论文([2404.02112](https://arxiv.org/pdf/2404.02112))主张:分数易不稳定,唯一稳健方式是**排名**,且要找能给出稳定一致排名的**大类评测组**。
|
||||||
|
- 作者团队也发现:LLM 分数对 prompt 细节[极其敏感](https://huggingface.co/blog/evaluation-structured-outputs),人类评测也不更一致——而**排名**在稳健评测方法下更稳定。
|
||||||
|
- ICLR 2024 评测 plenary 上 Moritz Hardt 的扰动实验:
|
||||||
|
- 给 Open LLM Leaderboard 做微小分数扰动(在分数区间内)。
|
||||||
|
- 给 Chatbot Arena 加一个差选手看 Elo 排名变化。
|
||||||
|
- 结论:**两者当前都无法提供稳定一致的排名**(未来版本的 Open LLM Leaderboard 会探索这一点)。
|
||||||
|
|
||||||
|
#### 3) 领域整体能力水平?(Can my model do X?)
|
||||||
|
|
||||||
|
- "你怎么知道模型能做 X?"是个常见且合理的问题。
|
||||||
|
- 但对任何复杂能力,目前只能说:"该模型在这个任务上最好,而这个任务我们希望是能力的代理,**但没有保证**。"
|
||||||
|
- ML 领域严重缺乏"能力"的定义与框架(推理、心智理论尤甚);但这并非 ML 独有——人类/动物研究里定义能力也很难(IQ、EQ 争议不断)。
|
||||||
|
- 或许该借鉴社会科学(那里习惯严肃对待数据收集与分析中的混淆变量)。
|
||||||
|
- 但作者也认为:1) 这些宽泛能力可能根本无法定义(人类与动物目前也没定义出来)2) 面向人的框架未必能迁移到模型(底层行为与假设不同)。
|
||||||
|
|
||||||
|
### 结论
|
||||||
|
|
||||||
|
- 现状归纳:
|
||||||
|
- 自动基准:受污染与"不通用"影响(后者未必是坏事,专项评测也有价值)。
|
||||||
|
- 人工评测:小规模下可复现性差、总体有心理偏差(如偏好谄媚答案),大样本下或许部分平滑。
|
||||||
|
- 模型作评委:偏差微妙,可能悄悄扰动下游。
|
||||||
|
- 仍有信号:非回归测试(分数落在预期区间)与足够稳定的排名能告诉我们新训练方法/数据集是否有前途;跨主题与任务攒够数据点也能对整体性能有大致把握——但**不能**据此假设任何"通用能力"。
|
||||||
|
- 与炒作相反,目前**无法**真正评测"通用模型能力",首先因为还没定义它是什么。
|
||||||
|
- LLM 评测作为研究领域还处在婴儿期,可从机器学习可解释性(如 [transformer-circuits 的 scaling monosemanticity](https://transformer-circuits.pub/2024/scaling-monosemanticity/index.html))到社会学跨界汲取灵感,跨学科工作很可能开辟新方向。
|
||||||
|
|
||||||
|
### 致谢(提及的交流者)
|
||||||
|
|
||||||
|
- Summer Yue(Scale AI)、Moritz Hardt(马普所)、Luca Soldaini 与 Ian Magnusson(Allen AI)、Ludwig Schmidt(Anthropic)、Max Bartolo(Cohere)、Maxime Labonne(Liquid AI)、François Charton(Meta)、Alan Cooney(UK AI Safety Institute)、Max Ryabinin(Together AI)。
|
||||||
|
- Hugging Face 的 Yacine Jernite、Irene Solaiman 与评测/排行榜团队(尤其 Nathan Habib)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 2025:评测要超越简单基准,构建真正可用的模型
|
||||||
|
|
||||||
|
> 原文:`yearly_dives/2025-evaluations-for-useful-models.md`(原文标题:Evals in 2025: going beyond simple benchmarks to build models people can actually use)。
|
||||||
|
|
||||||
|
### 核心论点
|
||||||
|
|
||||||
|
- 目标应是构建"**工作得好(work well)**"的模型而非"智能"的模型——对人们有用且高效的工具体现为更好的成功度量,而非追求"通用智能"替人解决问题(顺带制造一串新问题)。
|
||||||
|
- 现实依据:Anthropic [经济指数报告](https://www.anthropic.com/research/anthropic-economic-index-september-2025-report)与 OpenAI [ChatGPT 使用研究](https://cdn.openai.com/pdf/a253471f-8260-40c6-a2cc-aa93fe9f142e/economic-research-chatgpt-usage-paper.pdf)显示 LLM 当前最常见的用途是**助手**:写代码、行政支持等;模型今年在通用 agent 用例上取得进展。
|
||||||
|
- 好助手应做到:面对 query 处理指令**歧义**、构建**逐步计划**、正确识别所需**资源**、不跑偏地执行计划、按需**调用工具**、执行中适应**意外事件**与新信息、且全程**不胡编(without bullshitting)**。
|
||||||
|
- 所需能力组合:逐步"推理"、长上下文记忆管理、适应性、低幻觉率,外加数学/代码/工具调用能力。
|
||||||
|
- 规模观察:**7B 的模型就能当好 agent 助手**(但再小到 3B 以下会碰到能力壁垒)。
|
||||||
|
- 评测方法需**分层**:开发期测**单一能力**、在现实任务上测**集成表现**、在动态环境中探**适应性**。
|
||||||
|
|
||||||
|
### 单一能力评测(Testing specific capabilities)
|
||||||
|
|
||||||
|
> 注意:若用下列评测来挑选/验证训练方法,最终报告这些指标会略有偏置(训练方法已被导向这些结果)。适合训练中取信号与对比 base/预训练模型。
|
||||||
|
|
||||||
|
#### 推理与常识(Reasoning and commonsense)
|
||||||
|
|
||||||
|
- 背景:这类数据集多为 BERT/嵌入模型时代建的"历史"数据集——当年有挑战性(常针对当时模型对抗式构造),现在 1) 太简单 2) 污染/饱和。
|
||||||
|
- 定位:只适合**消融或预训练评测**。
|
||||||
|
- 质量问题:大型数据集常经 MTurk 快速低成本构建,含错误或低质量问题(现在改用 LLM 生成评测题)。
|
||||||
|
|
||||||
|
| 数据集 | 年份 | 说明(链接) |
|
||||||
|
|---|---|---|
|
||||||
|
| ARC | 2018 | 小学科学 MCQA,选择对当时的词共现系统对抗式构造;高质量的 `challenge` 子集今天仍用于预训练([1803.05457](https://arxiv.org/abs/1803.05457);勿与 ARC-AGI 混淆) |
|
||||||
|
| WinoGrande | 2019 | 众包(MTurk + 校验)代词消解/填空,对抗式配对;2022–2023 前对模型一直很难([1907.10641](https://arxiv.org/pdf/1907.10641)) |
|
||||||
|
| HellaSwag | 2019 | 从对抗候选中选正确下一句;文本来自 ActivityNet 字幕与 Wikihow 教程,常需物理常识 grounding;Swag 的后继([1905.07830](https://arxiv.org/abs/1905.07830)) |
|
||||||
|
| CommonsenseQA | 2018 | 基于 ConceptNet 的常识 MCQA,干扰项用概念相近选项([1811.00937](https://arxiv.org/abs/1811.00937)) |
|
||||||
|
| PIQA | 2019 | 物理常识题,源自 Instructables.com,对抗选项来自语义扰动/改写([1911.11641](https://arxiv.org/abs/1911.11641)) |
|
||||||
|
| OpenBookQA | 2018 | 提供 open book 事实辅助答题,但题目仍需潜在常识知识([1809.02789](https://arxiv.org/abs/1809.02789)) |
|
||||||
|
|
||||||
|
#### 知识(Knowledge)
|
||||||
|
|
||||||
|
- **MMLU**(2020,[2009.03300](https://arxiv.org/abs/2009.03300)):主要知识评测集,已饱和/污染;深入检查发现多种问题——残缺问题(引用不存在的文档)、错误 ground truth、歧义问题、明显的美国中心主义选题。
|
||||||
|
|
||||||
|
| 数据集 | 年份 | 说明(链接) |
|
||||||
|
|---|---|---|
|
||||||
|
| MMLU-Redux | 2024 | MMLU 的清洗版([2406.04127](https://arxiv.org/abs/2406.04127)) |
|
||||||
|
| MMLU-Pro | 2024 | 更多复杂题与答案,社区当前主要替代品([2406.01574](https://arxiv.org/abs/2406.01574)) |
|
||||||
|
| Global-MMLU | 2024 | MMLU 翻译 + 文化偏差标注([2412.03304](https://arxiv.org/abs/2412.03304)) |
|
||||||
|
| GPQA | 2023 | 生物/化学/物理博士级定制题,只有对应领域博士生能答;最常用 `diamond` 子集,2023 发布以来也开始污染([2311.12022](https://arxiv.org/abs/2311.12022)) |
|
||||||
|
| Humanity's Last Exam(HLE) | 2024 | 2.5K 专家众包跨领域题,需复杂知识与推理;基本私密、尚未被"打穿"([agi.safe.ai](https://agi.safe.ai/)) |
|
||||||
|
|
||||||
|
- HLE 的问题:无法快速按 ground truth 打分,大家改用 **LLM judge** 评估答案 → 野外结果不可比。
|
||||||
|
- 用途:MMLU 系列多用于**预训练评测与消融**;后训练用更硬的 GPQA/HLE。
|
||||||
|
- 作者预测"潜在知识"评测将逐步淡出(训练期仍可用 MMLU-Pro、后训练用 GPQA/HLE),两个原因:
|
||||||
|
1. 对人类越来越**不可读**:题太难,非专家无法理解每题的意义(也无法核查数据集本身有没有错)。
|
||||||
|
2. 模型连上工具(如联网)后,潜在知识评测逐渐变成**搜索与检索评测**——从闭卷考试走向开卷考试(类比法国教育:高中闭卷,大学假设可查数据库/网络,评分更多看"给自由信息后的推理")。
|
||||||
|
|
||||||
|
#### 数学(Math)
|
||||||
|
|
||||||
|
- 数学评测长期被当作推理与逻辑的代理。
|
||||||
|
- 参考集:**GSM8K**(2021,[2110.14168](https://arxiv.org/abs/2110.14168),小学应用题)与 **MATH**(2021,[2103.03874](https://arxiv.org/abs/2103.03874),网上奥林匹克题聚合),近年已饱和/污染。
|
||||||
|
|
||||||
|
| 数据集 | 年份 | 说明(链接) |
|
||||||
|
|---|---|---|
|
||||||
|
| GSM1K | 2024 | GSM8K 重做 1K 新题,测哪些模型在 GSM8K 上污染([2405.00332](https://arxiv.org/abs/2405.00332)) |
|
||||||
|
| GSM-Plus | — | GSM8K 对抗式改写:干扰项、数值变化等([2402.19255](https://arxiv.org/pdf/2402.19255)) |
|
||||||
|
| GSM-Symbolic | 2024 | 把 GSM8K 改写成问题模板、可无限再生成防污染;用得少但很有意思([2410.05229](https://arxiv.org/abs/2410.05229)) |
|
||||||
|
| MATH-500 | — | 500 题代表性子集,避免过拟合([HF 数据集](https://huggingface.co/datasets/HuggingFaceH4/MATH-500));另有 MATH-Hard(最难的 500 题) |
|
||||||
|
| AIME 24/25 | 2024/2025 | 美国高中生奥赛,按发布年原样使用;每年题目难度相当,可用"发布年成绩 vs 上一年度题成绩"测污染([24](https://huggingface.co/datasets/HuggingFaceH4/aime_2024)、[25](https://huggingface.co/datasets/math-ai/aime25)) |
|
||||||
|
| Math-Arena | — | 持续更新的竞赛/奥赛汇总,含 AIME25 及大量其他竞赛([matharena.ai](https://matharena.ai/)) |
|
||||||
|
| FrontierMath | 2024 | 数学家为评测专门撰写的显著更难的题,理论私密(但 OpenAI 疑似接触过部分数据)([2411.04872](https://arxiv.org/abs/2411.04872)) |
|
||||||
|
|
||||||
|
- 观察:大多数上述数据集已"没那么难"(止步小学水平,GSM-Symbolic 可生成更多递归层级的题使其合成地变难);HLE 里也有需复杂推理(含定理证明)的数学题。
|
||||||
|
- 作者建议:预训练评测用 **AIME25 与 MATH-500**,后训练用 **Math-Arena**。
|
||||||
|
|
||||||
|
#### 代码(Code)
|
||||||
|
|
||||||
|
- 理由:agent 要与工具交互就需要编码能力(代码 agent 直接调工具;code/json agent 都要能调试工具输出,区别见 [agents course](https://huggingface.co/learn/agents-course/en/unit2/smolagents/tool_calling_agents));代码评测也是推理的好代理。
|
||||||
|
|
||||||
|
| 数据集 | 年份 | 说明(链接) |
|
||||||
|
|---|---|---|
|
||||||
|
| MBPP | 2021 | 1K 众包 Python 入门题([2108.07732](https://arxiv.org/abs/2108.07732)) |
|
||||||
|
| APPS | 2021 | 10K 来自面试与分享网站的代码生成题([2105.09938](https://arxiv.org/abs/2105.09938)) |
|
||||||
|
| HumanEval | 2021 | 随 Codex 发布、专为发布构造的题 + 防危险代码执行的沙箱 + `pass@k` 估计器([2107.03374](https://arxiv.org/abs/2107.03374)) |
|
||||||
|
| EvalPlus(HumanEval+/MBPP+) | 2023 | 补测试用例、修 bug、加输入([OpenReview](https://openreview.net/pdf?id=1qvx610Cu7)) |
|
||||||
|
| EvoEval | 2024 | HumanEval 语义改写 + 难度标注([2403.19114](https://arxiv.org/abs/2403.19114)) |
|
||||||
|
| LiveCodeBench | 2024 | 记录题目日期,比较训练前后题目的表现——优秀的防污染基准([2403.07974](https://arxiv.org/abs/2403.07974)) |
|
||||||
|
| AiderBench | 2024 底上线 | 用 Exercism 数据,专门测**代码编辑与重构**([leaderboard](https://aider.chat/docs/leaderboards/)) |
|
||||||
|
| RepoBench | 2023 | 仓库级自动补全(Python/Java),跨文件/文件内函数,retrieval/completion/组合多层测试([2306.03091](https://arxiv.org/abs/2306.03091)) |
|
||||||
|
| SWE-Bench | 2024 | GitHub 真实 issue 求解:逻辑理解、跨文件编辑与执行、长上下文推理;推荐高质量子集 **SWE-Bench verified**([OpenReview](https://openreview.net/pdf?id=VTF8yNQM66)) |
|
||||||
|
|
||||||
|
- 作者建议关注 LiveCodeBench、AiderBench、SWE-Bench verified,并读 [METR 报告](https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/) 了解真实代码助手有用性。
|
||||||
|
|
||||||
|
#### 长上下文(Long context)
|
||||||
|
|
||||||
|
- 背景:3 年前最大上下文还是 2048 token,现在普遍 128K 以上。
|
||||||
|
|
||||||
|
| 数据集 | 年份 | 说明(链接) |
|
||||||
|
|---|---|---|
|
||||||
|
| NIAH(Needle in a Haystack) | 2023 | 把随机事实放进长无关文本再检索;可评估模型在上下文何处、多长之后最易遗忘;2023 年表现很差,2025 年接近解决([gkamradt 仓库](https://github.com/gkamradt/LLMTest_NeedleInAHaystack)) |
|
||||||
|
| RULER | 2024 | 多跳追踪(追踪变量链求值)、词频变化、NIAH 的 QA 变体;也接近解决([2404.06654](https://arxiv.org/pdf/2404.06654)) |
|
||||||
|
| Michelangelo / MRCR | 2024 | 多轮共指:精确复现上下文唯一片段、识别相关信息是否存在、理解文本修改序列;OpenAI 2025 扩展为 [OpenAI MRCR](https://huggingface.co/datasets/openai/mrcr)([2409.12640](https://arxiv.org/pdf/2409.12640v2)) |
|
||||||
|
| InfinityBench | 2024 | 中英多语言,100K token 合成数据,覆盖 QA、NIAH 式检索、超长上下文计算等;仍有信号([2402.13718](https://arxiv.org/abs/2402.13718)) |
|
||||||
|
| HELMET | 2024 | 任务与现有基准的大聚合:RAG/QA(Natural Questions、TriviaQA、PopQA、HotpotQA、NarrativeQA、InfinityBench)、recall(RULER、JSONKV)、带引用的生成(ALCE 子集)、摘要、重排(MS MARCO)、ICL(TREC、NLU、Banking77、CLINIC150);2025 年仍有足够区分度([2410.02694](https://arxiv.org/abs/2410.02694)) |
|
||||||
|
| Novel Challenge | 2024 | 关于近一年出版虚构小说的 1K 真/假判断题,由读者出题,须读完并理解全书([2406.16264](https://arxiv.org/abs/2406.16264)) |
|
||||||
|
| Kalamang 翻译集 | 2024 | 模型须读语法书后把英语译成 Kalamang——仅约 200 使用者的极低资源语言、无网络存在;可扩展到其他低资源语言,并可用规则语法检查器做严格准确率而非 BLEU([2309.16575](https://arxiv.org/abs/2309.16575)) |
|
||||||
|
|
||||||
|
- 提醒:聚合基准有**重复测量**风险——别同时测 HELMET 和 InfinityBench 再合并结果(等于同一评测跑两遍)。
|
||||||
|
|
||||||
|
#### 指令遵循(Instruction Following)
|
||||||
|
|
||||||
|
- 两大数据集:**IFEval**(2023,[2311.07911](https://arxiv.org/abs/2311.07911))与扩展 **IFBench**(2025,[2507.02833](https://arxiv.org/abs/2507.02833))。
|
||||||
|
- 作者评价:IFEval 是近几年最聪明的评测思路之一——要求模型遵循**格式指令**(关键词、标点、字数/句数、markdown/html 等文件类型格式),每个条件可用特定解析测试检查。
|
||||||
|
- 意义:少数**不依赖模型评委也能得到严格分数**的自由生成评测,属功能性正确/单元测试类评测(作者最偏爱的评测方式),也易再生成/扩展防污染。
|
||||||
|
- 反方向(non-compliance):**CoCoNot**(2024,[2407.12043](https://www.arxiv.org/pdf/2407.12043))测模型对不完整(未说明/不清晰)、不可回答(缺信息、AI 化、常触发幻觉)、不安全请求是否会拒绝遵循;人工写 query + 模型写违规请求再过滤,作为分类问题评测。
|
||||||
|
|
||||||
|
#### 工具调用(Tool-calling)
|
||||||
|
|
||||||
|
- 背景:工具的出现是把 LLM 推向 agentic 的关键之一。
|
||||||
|
|
||||||
|
| 数据集 | 年份 | 说明(链接) |
|
||||||
|
|---|---|---|
|
||||||
|
| TauBench | 2024 | 零售与航空领域查询求解(下单/预订/查产品等),合成样本模拟真实领域数据;判对标准:1) 动作正确更新数据库 2) 恰当回答用户;用户由 LLM 模拟(成本高、易错),但贴合真实用例、用得很多([2406.12045](https://arxiv.org/pdf/2406.12045)) |
|
||||||
|
| ToolBench | 2023 | 调 API(OpenWeather、Cat、HomeSearch、TripBooking、GoogleSheets、WebShop、Tabletop 等)解 100 个测试用例,每例需 1–10 次工具调用;部分 API 是 mock、部分真实 → 易意外失败([2305.16504](https://arxiv.org/pdf/2305.16504)) |
|
||||||
|
| StableToolBench | 2025 | 用通用 VirtualAPIServer 全部 mock 保证稳定,但引入 LLM judge 评分(又多一层偏差)([2403.07714](https://arxiv.org/pdf/2403.07714)) |
|
||||||
|
| BFCL | 2025 版 | 4 个子集:单轮简单调用、众包真实用户函数调用、多轮对话、agentic(web 搜索、记忆、SQL 数据交互);用 AST、执行响应与状态匹配判对;v3 测工具调用、v4 测 web/search 工具([OpenReview](https://openreview.net/pdf?id=2GmDdhBdDk)) |
|
||||||
|
| MCPBench | 2025 | 接真实 MCP 服务器(Wikipedia、HF、Reddit、Steam、arxiv 等),多轮合成任务;规则检查工具调用有效性 + LLM judge 评回答([2508.20453](https://arxiv.org/abs/2508.20453)) |
|
||||||
|
| MCP-Universe | 2025 | 11 个真实主题 MCP 服务器(IRL 导航、3D 设计、web 搜索等);多个严格评估器(格式 + 两个答案正确性);动态任务用**基于任务执行的框架**自动抓最新正确答案对比——比 LLM judge 干净得多([2508.14704](https://arxiv.org/abs/2508.14704)) |
|
||||||
|
| LiveMCPBench | 2025 | 大规模本地可部署 MCP 服务器集合,测模型在工具间分辨挑选的能力;最强模型已到 80%,接近饱和;"超长工具列表中选对工具"会随 web mcp 化越来越重要([2508.01780](https://arxiv.org/abs/2508.01780)) |
|
||||||
|
|
||||||
|
- 附:[Anthropic 的"为 agent 写工具"文档](https://www.anthropic.com/engineering/writing-tools-for-agents)。
|
||||||
|
- 过渡语:单项能力评测有价值,但真实助手表现来自能力组合——推理必须与工具调用、长上下文管理同时进行,所以需要"多能力编排"的评测。
|
||||||
|
|
||||||
|
### 助手任务(Assistant tasks)
|
||||||
|
|
||||||
|
- 作者认为这是下一代评测的主流方向:解一个助手任务需组合大量能力(长上下文、推理、工具调用…),同时具体领域表现被放进真实有用场景;比单项能力基准**更易懂**。
|
||||||
|
- 足够通用时,不检查用了什么具体工具,只看**最终结果对不对**(复杂任务有多条成功路径)。
|
||||||
|
|
||||||
|
#### 真实信息检索(Real life information retrieval)
|
||||||
|
|
||||||
|
| 数据集 | 年份 | 说明(链接) |
|
||||||
|
|---|---|---|
|
||||||
|
| GAIA | 2023 | 开创现代 agentic 评测——组合工具、推理、检索解真实查询(有时含文档);3 个难度级别,第一级已饱和、第三级仍难;公开榜见 [leaderboard](https://huggingface.co/spaces/gaia-benchmark/leaderboard);分数因评测方式(公开验证集 vs LLM judge 评私有测试集)差异很大([2311.12983](https://arxiv.org/abs/2311.12983)) |
|
||||||
|
| BrowseComp | 2025 | 测同样的事(用工具与在线信息找到具体查询的答案),但**结果不保证唯一**——从结果反推构造问题(如"哪篇关于 Topic 的论文发表在 Conference,作者含一位 Nationality 与两位 Entity 的人?"),多难度;目前可能更难([OpenAI PDF](https://cdn.openai.com/pdf/5e10f4ab-d6f7-442e-9508-59515c65e35d/browsecomp.pdf)) |
|
||||||
|
| GAIA2 | — | 用模拟移动环境,测助手靠事件链与工具调用正确回答查询;对 SOTA 模型,搜索与执行已极容易,**时间敏感与刻意加噪(模拟 API 失败)子集**最难([HF 博客](https://huggingface.co/blog/gaia2)) |
|
||||||
|
|
||||||
|
#### 科学助手(Science assistants)
|
||||||
|
|
||||||
|
| 数据集 | 年份 | 说明(链接) |
|
||||||
|
|---|---|---|
|
||||||
|
| SciCode | 2024 | 跨 STEM 领域用写科学代码解真实科研问题;核心问题分解为子问题;初版由科学家 + 模型评委评分,发布时模型表现很差(<5%)([2407.13168](https://arxiv.org/abs/2407.13168)) |
|
||||||
|
| PaperBench | 2025 | 复现 ML 研究——给定 ICML 高质量论文重建对应代码库(论文作者贡献 8K 个分级任务,rubric 树加权计总分);LLM judge 评分(作者怀疑部分可约束代码形态来自动化)([2504.01848](https://arxiv.org/abs/2504.01848)) |
|
||||||
|
| DSBench | 2025 | Kaggle + ModelOff(金融数据)的多模态数据分析;ModelOff 题以多选题形式给出(可能变简单),Kaggle 每题有自己的指标([2409.07703](https://arxiv.org/pdf/2409.07703)) |
|
||||||
|
| DABStep | 2025 | 用此前私密(未污染)的真实运营数据分析工作负载 + 真实问题与数据;全部需多步推理、多样文档解析、特定数据操作;难、贴近真实、每题有 ground truth → 评测无偏且不算贵([2506.23719](https://arxiv.org/abs/2506.23719)) |
|
||||||
|
|
||||||
|
### 游戏化评测(Game-based evaluations)
|
||||||
|
|
||||||
|
- 价值:测对**变化环境的适应**(多数助手任务是静态的)、需长上下文推理、**人人都能看懂**。
|
||||||
|
- 缺点:不扎根真实生活、未必反映真实有用场景的表现。
|
||||||
|
- **ARC-AGI**([arcprize.org](https://arcprize.org/arc-agi)):2019 初版是网格拼图序列,无显式规则,找序列最后一项;非常像逻辑导向的 IQ 测试;2024 年几乎被解决。
|
||||||
|
- **Baba is AI**(2024,[2407.13729](https://arxiv.org/abs/2407.13729)):同类规则外推基准。
|
||||||
|
- **ARC-AGI3**(2025,进行中):整批新游戏(探索、复杂规划、记忆管理等),当前最佳解还在暴力破解。
|
||||||
|
- 单机冒险/RPG:**TextQuests**(2025,[HF 博客](https://huggingface.co/blog/textquests))、**Pokemon**(2024,[benchflow 仓库](https://github.com/benchflow-ai/benchflow/tree/main/libs/pokemon-gym);Claude 与 Gemini 都有 Twitch 直播:[Claude plays Pokemon](https://www.twitch.tv/claudeplayspokemon)、[Gemini plays Pokemon](https://www.twitch.tv/gemini_plays_pokemon))——需超长规划、长上下文记忆管理、推理、回溯。
|
||||||
|
- 生存游戏:**Crafter**(2021,[2109.06780](https://arxiv.org/abs/2109.06780),Minecraft 启发)。
|
||||||
|
- 环境整合:**Balrog**(2024,[2411.13543](https://arxiv.org/pdf/2411.13543))整合了多个单人游戏环境。
|
||||||
|
- 竞争性虚张声势游戏(测逻辑、推理与**欺骗**):
|
||||||
|
- **Poker**(2025,[2501.08328](https://arxiv.org/html/2501.08328v1))。
|
||||||
|
- **Town of Salem**(2025,[仓库](https://github.com/summersonnn/Town-Of-Salem-with-LLMs))。
|
||||||
|
- **Werewolf 狼人杀**(2025,[2407.13943](https://arxiv.org/abs/2407.13943) / [网站](https://werewolf.foaster.ai/))。
|
||||||
|
- 例:Claude Opus 4 当狼人杀里的吸血鬼(欺骗角色)赢不了,但当农民(非欺骗角色)表现好。
|
||||||
|
- 合作游戏 **Hanabi**:测受限环境下的适应与沟通。
|
||||||
|
- 优势:单一明确的 **pass/fail 指标**(赢没赢)。
|
||||||
|
- 作者当前建议:能力看 TextQuests,安全看 Town of Salem。
|
||||||
|
|
||||||
|
### 预测类评测(Forecasters)
|
||||||
|
|
||||||
|
- 背景:去年新出现的、**本质上无法污染**的任务类别(股票市场预测理论上可被操纵,但希望还没到为搞坏评测而作弊的激励程度)。
|
||||||
|
- 定位:需跨来源推理回答尚未发生事件的问题;但不确定区分度是否够强,且可能强化 LLM 的"老虎机式成功"观感——事件上接近随机:因为不可预测还是模型差?反过来,预测对了:题太简单还是太模板化?
|
||||||
|
|
||||||
|
| 数据集 | 说明(链接) |
|
||||||
|
|---|---|
|
||||||
|
| FutureBench | 预测未来有新闻价值的事件;两个来源——浏览 + LLM 每周时间窗生成问题,以及博彩市场的用户预测;数据重度过滤清洗;模型在人类博彩题上勉强优于随机,在模型生成题上 3/4 成功(后者更简单)([HF 博客](https://huggingface.co/blog/futurebench)) |
|
||||||
|
| FutureX | 用一系列特定网站(预测市场、政府网站、通用排名网站、实时数据平台),模板生成未来事件问题("STOCK 何时到达 POINT?");每日生成 500 题并过滤意外无关题([2508.11987](https://arxiv.org/abs/2508.11987)) |
|
||||||
|
| Arbitrage | 类似生成方式,核心差异是时间窗——事件须在 2028 年前解决([2412.18544](https://arxiv.org/pdf/2412.18544)) |
|
||||||
|
|
||||||
|
### 2025 年 9 月的推荐评测组合
|
||||||
|
|
||||||
|
| 用途 | 推荐评测 |
|
||||||
|
|---|---|
|
||||||
|
| 核心能力(模型构建者) | 训练期用旧能力评测;后训练用 MATH500/AIME24、GPQA、IFEval、SWE-Bench;长程评测选一个如 HELMET;面向工具用 TauBench 或 BFCL |
|
||||||
|
| 核心能力(推理期对比模型) | IFBench、HLE、MathArena、AiderBench 与 LiveCodeBench、MCP-Universe |
|
||||||
|
| 长时程任务(真实世界表现) | GAIA、DABStep、SciCode 或针对自己用例的领域评测 |
|
||||||
|
| 游戏(测鲁棒性与适应性的趣味补充) | ARC-AGI3(发布后)、TextQuests;安全相关看 Town of Salem;或任何超越 Poker/Chess/Go 的游戏 |
|
||||||
|
|
||||||
|
### 结语
|
||||||
|
|
||||||
|
- 领域正从"测孤立技能"走向"测能力编排"以服务真实使用,契合"构建 work well 的模型"的目标。
|
||||||
|
- 作者希望未来评测更重视**功能性测试**而非模型评委,并保持数据集与任务的可理解性。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 参考资料
|
||||||
|
|
||||||
|
- 2023 原文(GitHub):[yearly_dives/2023-year-of-open-source.md](https://github.com/huggingface/evaluation-guidebook/blob/main/yearly_dives/2023-year-of-open-source.md)
|
||||||
|
- 2023 原文(博客首发):[2023, year of open LLMs](https://huggingface.co/blog/2023-in-llms)
|
||||||
|
- 2024 原文(GitHub):[yearly_dives/2024-evals-thoughts-from-iclr.md](https://github.com/huggingface/evaluation-guidebook/blob/main/yearly_dives/2024-evals-thoughts-from-iclr.md)
|
||||||
|
- 2024 原文(博客首发):[Let's talk about LLM evaluation](https://huggingface.co/blog/clefourrier/llm-evaluation)
|
||||||
|
- 2025 原文(GitHub):[yearly_dives/2025-evaluations-for-useful-models.md](https://github.com/huggingface/evaluation-guidebook/blob/main/yearly_dives/2025-evaluations-for-useful-models.md)
|
||||||
|
- 指南仓库:[huggingface/evaluation-guidebook](https://github.com/huggingface/evaluation-guidebook)
|
||||||
|
|
||||||
|
相关:[[00-Overview]] · [[07-Resources]]
|
||||||
+167
@@ -0,0 +1,167 @@
|
|||||||
|
---
|
||||||
|
type: reference
|
||||||
|
tags:
|
||||||
|
- llm-evaluation
|
||||||
|
- evaluation-guidebook
|
||||||
|
- resources
|
||||||
|
status: active
|
||||||
|
created: 2026-08-21
|
||||||
|
source: https://github.com/huggingface/evaluation-guidebook
|
||||||
|
---
|
||||||
|
|
||||||
|
# Resources —— 评测与 NLP 推荐资源清单
|
||||||
|
|
||||||
|
> 本页整理自 HuggingFace Evaluation Guidebook 的 `resources/about-evaluation.md` 与 `resources/about-NLP.md`,把原文链接按主题分类成清单。每项列出:链接、作者/来源、一句话中文说明(说明依据原文自带的描述翻译;原文只有链接的条目,只做最小的事实性描述,不额外发挥)。⚠️ 链接是否仍然有效、内容是否更新,以访问时为准。
|
||||||
|
|
||||||
|
## 快速导航
|
||||||
|
|
||||||
|
- [评测方法论与综述](#评测方法论与综述)
|
||||||
|
- [LLM-as-a-Judge(模型作评委)](#llm-as-a-judge模型作评委)
|
||||||
|
- [播客](#播客)
|
||||||
|
- [评测软件与工具](#评测软件与工具)
|
||||||
|
- [排行榜](#排行榜)
|
||||||
|
- [评测教程](#评测教程)
|
||||||
|
- [NLP 基础](#nlp-基础)
|
||||||
|
- [LLM 架构理解](#llm-架构理解)
|
||||||
|
- [提示词(Prompting)](#提示词prompting)
|
||||||
|
|
||||||
|
## 资源总览
|
||||||
|
|
||||||
|
> 全表共 21 项资源,按类别一览(详细清单见下文各节)。
|
||||||
|
|
||||||
|
| 类别 | 资源 | 作者/来源 | 一句话说明 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| 评测方法论 | Foundational Model Development Cheatsheet | AllenAI | 基础模型开发速查表 |
|
||||||
|
| 评测方法论 | Challenges in LM Evaluation | Hailey Schoelkopf & Lintang Sutawika(ICML 2024 Tutorial) | 自动评测挑战综述演示 |
|
||||||
|
| 评测方法论 | Lessons from the trenches on Reproducible Evaluation of LMs | EleutherAI | 可复现 LM 评测的经验论文 |
|
||||||
|
| LLM-as-a-Judge | LLM Evaluators | Eugene Yan | LLM 作评测器的总结 |
|
||||||
|
| LLM-as-a-Judge | LLM as a Judge | Cameron R. Wolfe | "LLM 作评委"方法综述 |
|
||||||
|
| LLM-as-a-Judge | LLM & VLM-as-a-Judge | Dylan(Digital Garden) | LLM/VLM 作评委经验 |
|
||||||
|
| 播客 | Benchmarks 101 | Latent Space | 自动基准历史与问题 |
|
||||||
|
| 播客 | Benchmarks 201 | Latent Space | 何时用哪种评测方法 + Leaderboard 讨论 |
|
||||||
|
| 工具 | `lm_eval`(the Harness) | Eleuther | 稳定可复现的 LLM 评测引擎 |
|
||||||
|
| 工具 | `lighteval` | Hugging Face | 轻量评测套件,聚焦定制与新基准 |
|
||||||
|
| 排行榜 | Open LLM Leaderboard | Hugging Face | 开源 LLM 静态基准中立评测 |
|
||||||
|
| 排行榜 | HELM | Stanford(CRFM) | 静态基准 + 胜率排名 |
|
||||||
|
| 排行榜 | Chatbot Arena | LMSys | 众包人工评测约 150 个 LLM |
|
||||||
|
| 排行榜 | LLM Performance Leaderboard | Artificial Analysis | LLM API 性能与定价对比 |
|
||||||
|
| 排行榜 | HF 评测/排行榜博客 | Hugging Face | 官方相关博客汇总 |
|
||||||
|
| 排行榜 | Leaderboard Finder | Hugging Face | 按用例找最相关排行榜 |
|
||||||
|
| 教程 | Argilla domain-eval tutorial | Argilla | 自定义领域评测端到端教程 |
|
||||||
|
| NLP 基础 | NLP for You | Lena Voita | 最好的在线 NLP 课程之一 |
|
||||||
|
| NLP 基础 | The NLP Course | Hugging Face | 完整 NLP 课程,含代码 |
|
||||||
|
| 架构 | Annotated/Illustrated 系列 + MoE 指南 | Bastings / Rush / Alammar / Grootendorst | Transformer、S4、MoE 图解与代码讲解 |
|
||||||
|
| 提示词 | Show me the prompt | Hamel Husain | 提示词相关博客 |
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 评测方法论与综述
|
||||||
|
|
||||||
|
> 来自 `about-evaluation.md` 的 Knowledge 部分:自动评测的两篇高质量综述 + 一篇入门速查。
|
||||||
|
|
||||||
|
- [Foundational Model Development Cheatsheet](https://fmcheatsheet.org/) —— 作者/来源:AllenAI
|
||||||
|
- 基础模型开发速查表(原文归在 "Knowledge > General",评测以外的整体入门参考)。
|
||||||
|
- [Challenges in LM Evaluation](https://github.com/lm-evaluation-challenges/lm-evaluation-challenges.github.io/blob/main/%5BMain%5D%20ICML%20Tutorial%202024%20-%20Challenges%20in%20LM%20Evaluation.pdf) —— 作者/来源:Hailey Schoelkopf 与 Lintang Sutawika(ICML 2024 Tutorial 演示文稿)
|
||||||
|
- 关于**自动评测挑战**的综述演示(原文明确推荐的两份自动评测综述之一)。
|
||||||
|
- [Lessons from the trenches on Reproducible Evaluation of LMs](https://arxiv.org/abs/2405.14782) —— 作者/来源:EleutherAI(arXiv 论文)
|
||||||
|
- 关于**可复现 LM 评测**的"战壕经验"论文(原文明确推荐的另一份自动评测综述)。
|
||||||
|
|
||||||
|
## LLM-as-a-Judge(模型作评委)
|
||||||
|
|
||||||
|
> 来自 `about-evaluation.md` 的 "LLM as a judge" 部分,原文归类为"总结与经验反馈"(Cool summaries and experience feedbacks)。
|
||||||
|
|
||||||
|
- [LLM Evaluators](https://eugeneyan.com/writing/llm-evaluators/) —— 作者/来源:Eugene Yan(博客)
|
||||||
|
- 关于用 LLM 做评测器的总结文章。
|
||||||
|
- [LLM as a Judge](https://cameronrwolfe.substack.com/p/llm-as-a-judge) —— 作者/来源:Cameron R. Wolfe(Substack 博客)
|
||||||
|
- 关于"LLM 作评委"这一评测方法的综述文章。
|
||||||
|
- [LLM & VLM-as-a-Judge](https://dylandigitalgarden.com/2024/July/July+31%2C+2024+LLM+%26+VLM-as-a-Judge) —— 作者/来源:Dylan(Digital Garden 博客,2024-07-31)
|
||||||
|
- 关于 LLM/VLM 作评委的经验与思考。
|
||||||
|
|
||||||
|
## 播客
|
||||||
|
|
||||||
|
> 来自 `about-evaluation.md` 的 Knowledge 部分,原文推荐的两个 Latent Space 播客。
|
||||||
|
|
||||||
|
- [Benchmarks 101](https://www.latent.space/p/benchmarks-101) —— 作者/来源:Latent Space(播客)
|
||||||
|
- 关于**自动基准的历史与已知问题**(自动评测入门)。
|
||||||
|
- [Benchmarks 201](https://www.latent.space/p/benchmarks-201) —— 作者/来源:Latent Space(播客)
|
||||||
|
- 关于**何时该用哪种评测方法**,并含与原作者(Clémentine Fourrier,指南作者)关于 Leaderboard 的讨论。
|
||||||
|
|
||||||
|
## 评测软件与工具
|
||||||
|
|
||||||
|
> 来自 `about-evaluation.md` 的 Software > Evaluation suites 部分。
|
||||||
|
|
||||||
|
- [`lm_eval`(lm-evaluation-harness)](https://github.com/EleutherAI/lm-evaluation-harness/) —— 作者/来源:Eleuther(GitHub 仓库)
|
||||||
|
- 常称 "the Harness",LLM 评测的"主力引擎":以稳定、可复现的方式在众多 benchmark 上评测来自多家供应商的任意 LLM。
|
||||||
|
- [`lighteval`](https://github.com/huggingface/lighteval) —— 作者/来源:Hugging Face(GitHub 仓库;指南作者也是作者之一,原文有利益声明)
|
||||||
|
- 轻量级 LLM 评测套件,聚焦定制化与较新的 benchmark。
|
||||||
|
|
||||||
|
## 排行榜
|
||||||
|
|
||||||
|
> 来自 `about-evaluation.md` 的 Software > Leaderboards 部分。
|
||||||
|
|
||||||
|
- [Open LLM Leaderboard](https://huggingface.co/spaces/open-llm-leaderboard/open_llm_leaderboard) —— 作者/来源:Hugging Face
|
||||||
|
- 对开源 LLM 在参考静态基准上的中立第三方评测,开放提交。
|
||||||
|
- [HELM](https://crfm.stanford.edu/helm/lite/latest/#/leaderboard) —— 作者/来源:Stanford(CRFM)
|
||||||
|
- 也在静态基准上评测模型,但用 **win-rates(胜率)** 排名。
|
||||||
|
- [Chatbot Arena](https://huggingface.co/spaces/lmsys/chatbot-arena-leaderboard) —— 作者/来源:LMSys
|
||||||
|
- 用众包人工评测(竞技场投票)为约 150 个 LLM 打分排名的 Arena。
|
||||||
|
- [LLM Performance Leaderboard](https://huggingface.co/spaces/ArtificialAnalysis/LLM-Performance-Leaderboard) —— 作者/来源:Artificial Analysis
|
||||||
|
- 主流 LLM API 提供商的性能基准与定价;想用 API 而非本地跑模型时看它。
|
||||||
|
- [Hugging Face 评测与排行榜相关博客](https://huggingface.co/blog?tag=leaderboard) —— 作者/来源:Hugging Face(博客标签页)
|
||||||
|
- 官方关于评测与排行榜的全部博客文章汇总。
|
||||||
|
- [Leaderboard Finder](https://huggingface.co/spaces/leaderboards/LeaderboardFinder) —— 作者/来源:Hugging Face(Space)
|
||||||
|
- 帮你找到与你的用例最相关的排行榜。
|
||||||
|
|
||||||
|
## 评测教程
|
||||||
|
|
||||||
|
> 来自 `about-evaluation.md` 的 Software > Tutorials 部分。
|
||||||
|
|
||||||
|
- [End-to-end custom domain evaluation tutorial](https://github.com/argilla-io/argilla-cookbook/tree/main/domain-eval) —— 作者/来源:Argilla(GitHub Cookbook)
|
||||||
|
- 端到端教程:为自己的领域构建自定义评测任务,使用合成数据 + 人工评测,配套工具 [Argilla](https://github.com/argilla-io/argilla/) 与 [distilabel](https://github.com/argilla-io/distilabel)。
|
||||||
|
|
||||||
|
## NLP 基础
|
||||||
|
|
||||||
|
> 来自 `about-NLP.md` 的 General knowledge 部分。
|
||||||
|
|
||||||
|
- [NLP for You](https://lena-voita.github.io/nlp_course.html) —— 作者/来源:Lena Voita
|
||||||
|
- 公认最好的在线 NLP 课程之一,循序渐进、阅读体验好(原文原话:step by step and nice to read)。
|
||||||
|
- [The NLP Course](https://huggingface.co/learn/nlp-course/chapter1/1) —— 作者/来源:Hugging Face
|
||||||
|
- 极其完整的 NLP 课程,含大量代码片段,可快速上手。
|
||||||
|
|
||||||
|
## LLM 架构理解
|
||||||
|
|
||||||
|
> 来自 `about-NLP.md` 的 Understanding LLM architectures 部分。
|
||||||
|
|
||||||
|
- [The Annotated Encoder Decoder](https://bastings.github.io/annotated_encoder_decoder/) —— 作者/来源:Jasmijn Bastings
|
||||||
|
- 逐步讲解 2015 年 Bahdanau 论文(带注意力的 RNN encoder-decoder),每一步都有代码解释。
|
||||||
|
- [The Annotated Transformer](https://nlp.seas.harvard.edu/2018/04/03/attention.html) —— 作者/来源:Sasha Rush
|
||||||
|
- 逐步讲解 2016 年 Vaswani 的 Transformer 论文,每一步都有代码解释。
|
||||||
|
- [The Illustrated Transformer](https://jalammar.github.io/illustrated-transformer/) —— 作者/来源:Jay Alammar
|
||||||
|
- 上一条的很好补充:用可视化(而非代码)讲 Transformer。
|
||||||
|
- [The Annotated S4](https://srush.github.io/annotated-s4/) —— 作者/来源:Sasha Rush
|
||||||
|
- 逐步讲解 Structured State Space for Sequence Modeling(S4)论文,每一步都有代码;想知道什么是状态空间模型就看它。
|
||||||
|
- [A Visual Guide to MoE](https://newsletter.maartengrootendorst.com/p/a-visual-guide-to-mixture-of-experts) —— 作者/来源:Maarten Grootendorst
|
||||||
|
- 混合专家(Mixture of Experts)可视化指南,大量直观图示;原文建议先读上面的 Transformer 指南再看本篇。
|
||||||
|
|
||||||
|
## 提示词(Prompting)
|
||||||
|
|
||||||
|
> 来自 `about-NLP.md` 的 Prompting 部分。
|
||||||
|
|
||||||
|
- [Show me the prompt](https://hamel.dev/blog/posts/prompt/) —— 作者/来源:Hamel Husain(博客)
|
||||||
|
- 关于提示词(prompt)的博客文章(原文仅给出链接,未附说明)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 使用建议
|
||||||
|
|
||||||
|
- **按需取用**:先看[评测方法论与综述](#评测方法论与综述)建立框架,再按场景选择[软件工具](#评测软件与工具)与[排行榜](#排行榜)。
|
||||||
|
- **补 NLP 基础**:需要 LLM/Transformer 基础时看 [NLP 基础](#nlp-基础) 与 [LLM 架构理解](#llm-架构理解)。
|
||||||
|
- **动手实践**:想自己搭评测流程,从 [评测教程](#评测教程) 的 Argilla 领域评测教程开始,工具用 `lm_eval` 或 `lighteval`。
|
||||||
|
- **持续跟踪**:排行榜与评测工具迭代很快,重要决定前请回到原文链接核对最新状态。
|
||||||
|
|
||||||
|
## 原文位置
|
||||||
|
|
||||||
|
- `resources/about-evaluation.md`:[GitHub blob](https://github.com/huggingface/evaluation-guidebook/blob/main/resources/about-evaluation.md)
|
||||||
|
- `resources/about-NLP.md`:[GitHub blob](https://github.com/huggingface/evaluation-guidebook/blob/main/resources/about-NLP.md)
|
||||||
|
|
||||||
|
相关:[[00-Overview]] · [[06-Yearly-Dives]]
|
||||||
+602
@@ -0,0 +1,602 @@
|
|||||||
|
---
|
||||||
|
type: reference
|
||||||
|
tags:
|
||||||
|
- llm-evaluation
|
||||||
|
- evaluation-guidebook
|
||||||
|
- 2025-edition
|
||||||
|
status: active
|
||||||
|
created: 2026-08-21
|
||||||
|
source: https://huggingface.co/spaces/OpenEvals/evaluation-guidebook
|
||||||
|
---
|
||||||
|
|
||||||
|
# HuggingFace LLM Evaluation Guidebook(2025 新版)提炼
|
||||||
|
|
||||||
|
> 本笔记提炼 **HuggingFace Evaluation Guidebook 新版(2025-12)独有/更新的内容**,与 [[00-Overview]]~[[07-Resources]] 整理自旧 GitHub 仓库的 8 篇笔记互补。旧版内容(judge 大章节、tokenization、yearly dives、resources 清单等)不在本文重复,重点写新版**新增与重构**的部分。
|
||||||
|
|
||||||
|
## 开篇:新版是什么
|
||||||
|
|
||||||
|
**The LLM Evaluation Guidebook(2025 版)** 是旧 GitHub 仓库(huggingface/evaluation-guidebook)停更后的**全新"科研论文形态"交互式 Space**:
|
||||||
|
|
||||||
|
- **地址**:<https://huggingface.co/spaces/OpenEvals/evaluation-guidebook>
|
||||||
|
- **作者**:Clémentine Fourrier、Thibaud Frere、Guilherme Penedo、Thomas Wolf(均为 Hugging Face)
|
||||||
|
- **副标题**:*"All the things you could want to know about LLM evaluation based on our experience scoring 15000 models over 3 years"*
|
||||||
|
- **发布时间**:2025-12-03
|
||||||
|
- **许可证**:CC BY 4.0
|
||||||
|
- **形态**:一个 Astro 构建的交互式论文页面(`app/src/content/article.mdx` 组装各章节 MDX,渲染结构见下),带可交互图表(d3 嵌入)、折叠块(Accordion)、侧注(Sidenote),而非旧版的线性 Git 文档
|
||||||
|
|
||||||
|
一句话关系:**同一团队对同一知识核心的现代化重组与再创作**——保留 tokenization/inference、自动评测设计、人类标注、troubleshooting 的骨架,但删除/压缩了旧版膨胀的部分(judge 独立大章节、troubleshooting 两个专项页、yearly dives、resources),把篇幅让给 2025 评测全景、统计有效性与成本、结构化生成、以及全新加入的 **FineWeb 预训练评测选型方法论**。
|
||||||
|
|
||||||
|
### 新版实际渲染结构(重要)
|
||||||
|
|
||||||
|
新版仓库含 **8 个章节 MDX 文件**,但页面正文(`article.mdx`)**按以下顺序渲染**,与文件布局不完全一一对应:
|
||||||
|
|
||||||
|
```
|
||||||
|
article.mdx(组装层,含正文过渡小节、saturation/contamination 定义、Conclusion)
|
||||||
|
├─ Intro ← chapters/intro.mdx
|
||||||
|
├─ ModelInferenceAndEvaluation ← chapters/general-knowledge/model-inference-and-evaluation.mdx
|
||||||
|
├─ (正文小节 "Evaluating with existing benchmarks")
|
||||||
|
│ ├─ EvalsIn2025(2025 评测全景) ← chapters/general-knowledge/2025-evaluations-for-useful-models.mdx
|
||||||
|
│ ├─ TroubleshootingReproducibility ← chapters/troubleshooting/troubleshooting-reproducibility.mdx
|
||||||
|
│ └─ PickingYourEval(FineWeb 选型) ← chapters/general-knowledge/picking-your-evaluation.mdx
|
||||||
|
├─ DesigningAutomaticEvaluation ← chapters/automated-benchmarks/designing-your-automatic-evaluation.mdx
|
||||||
|
│ └─ 其中通过 import 嵌入 UsingHumanAnnotators(在 "Using existing data" 与
|
||||||
|
│ "Creating a dataset synthetically" 之间)← chapters/human-evaluation/using-human-annotators.mdx
|
||||||
|
└─ Conclusion(结论)
|
||||||
|
```
|
||||||
|
|
||||||
|
8 个章节文件一览(`app/src/content/chapters/...`):
|
||||||
|
|
||||||
|
| 章节文件 | 路径 | 渲染方式 | 核心内容 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| intro | `intro.mdx` | article.mdx 直接 import | 评测视角(model builder vs model user)、智能定义的困境 |
|
||||||
|
| model-inference-and-evaluation | `general-knowledge/model-inference-and-evaluation.mdx` | article.mdx 直接 import | tokenization 与 inference 基础、MCF/CF/FG、calibration |
|
||||||
|
| 2025-evaluations-for-useful-models | `general-knowledge/2025-evaluations-for-useful-models.mdx` | article.mdx 直接 import | 2025 分能力评测全景与推荐 |
|
||||||
|
| troubleshooting-reproducibility | `troubleshooting/troubleshooting-reproducibility.mdx` | article.mdx 直接 import | 评测复现排错(与旧版基本一致) |
|
||||||
|
| picking-your-evaluation | `general-knowledge/picking-your-evaluation.mdx` | article.mdx 直接 import | **FineWeb 预训练评测选型方法论(全新)** |
|
||||||
|
| designing-your-automatic-evaluation | `automated-benchmarks/designing-your-automatic-evaluation.mdx` | article.mdx 直接 import | 设计自动评测:数据、prompt、指标、functional scorers、judge、structured generation |
|
||||||
|
| using-human-annotators | `human-evaluation/using-human-annotators.mdx` | **通过 `<UsingHumanAnnotators />` 嵌入 designing**(位于 "Using existing data" 与 "Creating a dataset synthetically" 之间),是设计流程的一部分 | 人类标注实践(与旧版基本一致) |
|
||||||
|
| some-evaluation-datasets | `automated-benchmarks/some-evaluation-datasets.mdx` | **存在于仓库,但页面正文不直接渲染**——2025 章节仅以一句 "you'll find a big list of older interesting benchmarks [here](...)" 链接到**旧 GitHub 仓库**的数据集清单 | 数学类 + 通用类数据集大表(作为仓库资产留存) |
|
||||||
|
|
||||||
|
要点:新版**没有**独立的 "Tips and Tricks" 章节、**没有** judge 独立大章节(judge 内容压缩进 designing 的 "With judge models" 小节)、**没有** yearly dives 2023/2024、**没有** resources 清单。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## §1 新版与旧版的差异总览
|
||||||
|
|
||||||
|
| 旧版章节(GitHub 仓库) | 新版去向 / 变化 |
|
||||||
|
|---|---|
|
||||||
|
| 00 Overview | 无独立 overview 章节;由 `intro.mdx` 承担"为什么要评测"的角色 |
|
||||||
|
| Automatic benchmarks / Basics(tokenization & inference、评测类型) | 精简合并为 `model-inference-and-evaluation.mdx`,**新增** MCF/CF/FG 三种任务形式与 log-likelihood 计算细节、calibration 讨论 |
|
||||||
|
| Automatic benchmarks / Designing your automatic evaluation | 重写强化为 `designing-your-automatic-evaluation.mdx`:**新增**数据创建流程检查清单、样本检查、指标详解(BLEU/ROUGE/TER/BLEURT)、normalization 与 Math-Verify 表格、sampling 指标(pass@k/maj@n/cot@n/avg@n)、functional scorers/IFEval、污染管理、constraining outputs(prompt/few-shot/**structured generation**)、统计有效性与成本 |
|
||||||
|
| Automatic benchmarks / Some evaluation datasets | 保留为 `some-evaluation-datasets.mdx`(数学大表 + 旧数据集表 + 可复现想法),**但仅作为仓库资产,页面正文不再渲染**——2025 章节只给出指向旧 GitHub 版清单的链接 |
|
||||||
|
| Human evaluation / Using human annotators | `using-human-annotators.mdx`(基本一致),**通过 import 嵌入 designing 章节内部**("Using existing data" 与 "Creating a dataset synthetically" 之间);Human evaluation basics 并入 designing 的 "With humans" 小节 |
|
||||||
|
| **LLM-as-a-judge(独立大章节)** | **删减合并**进 designing 的 "With judge models" 小节:judge-LLM 选择、prompt 设计、评估 evaluator、reward models 仍在但大幅压缩 |
|
||||||
|
| Troubleshooting / Troubleshooting reproducibility | `troubleshooting-reproducibility.mdx`(保留,基本一致) |
|
||||||
|
| Troubleshooting / Troubleshooting inference | **删除** |
|
||||||
|
| Troubleshooting / Troubleshooting math parsing | **删除独立页**;Math-Verify 内容移入 designing 的 Normalization 小节 |
|
||||||
|
| General knowledge / tokenization 独立页 | **精简**并入 `model-inference-and-evaluation.mdx` |
|
||||||
|
| Yearly dives(2023/2024 深度文章) | **删除**;以 `2025-evaluations-for-useful-models.mdx`(2025 评测全景)取代 |
|
||||||
|
| Resources 推荐清单 | **删除**独立章节(2025 章节末尾保留了旧数据集清单的链接) |
|
||||||
|
| ——(新增) | `picking-your-evaluation.mdx`:**FineWeb 团队预训练评测选型方法论(全新内容)** |
|
||||||
|
| ——(新增) | `intro.mdx`:model builder vs model user 视角、智能定义的困境 |
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## §2 评测视角与目的(来自 intro)
|
||||||
|
|
||||||
|
新版开篇不再直接讲技术,而是先回答"**为什么评测**"——因为**你是谁、你在做什么,决定了你需要哪些评测**。核心问题:
|
||||||
|
|
||||||
|
> How can one know if a model is *good*?(如何知道一个模型是"好"的?)
|
||||||
|
|
||||||
|
### model builder(模型构建者):Am I building a strong model?
|
||||||
|
|
||||||
|
- 目标:构建在任务集上表现良好的强模型。**基础模型**(从零训练)关心通用任务上的多种能力;**post-training**(针对特定用例微调)更关心该用例上的表现。
|
||||||
|
- 通过 **ablations**(消融实验)检验设计选择(数据混合、架构、超参)是否"搞坏了"预期表现或有所提升——因此 **评测任务的选择对 ablation 至关重要**,它决定了你在构建模型时优化什么。
|
||||||
|
- 除 ablation 外,还要在训练中评测中间 checkpoint(确保在逐步学习、没有因 spike 等回退),最后评测最终 checkpoint 以宣称 SOTA。
|
||||||
|
- 需求:**快、高信号(strong signal)、便宜**,才能快速迭代;也可基于小模型表现用 **scaling laws** 预测大模型。
|
||||||
|
- 重要限定(原文强调):对于任何复杂能力,目前不能说"这个模型在这项上最好",而只能说——
|
||||||
|
|
||||||
|
> "this model is the best **on these samples** for **this specific task** that we hope are a **good proxy for this capability**, without any guarantee"
|
||||||
|
|
||||||
|
### model user(模型使用者):Which model is the best for my use case?
|
||||||
|
|
||||||
|
- 目标:直接选用他人训练好的模型,或找最好的基础模型做进一步训练。
|
||||||
|
- 常见领域(math/code/knowledge)已有多个 leaderboard 可对比排名;通常**只需测试头部候选**(如果它们都不行,更差的模型大概率也不行)。
|
||||||
|
- 可自己重跑现有 benchmark 获取更细的成功/失败分析。
|
||||||
|
- 引用 ImageNet 时代 benchmark 设计教训论文(arxiv 2404.02112)的核心观点:**分数容易不稳定,唯一稳健的评测方式是排名(rankings),尤其是找到一批能给出一致且稳定排名的评测组**。作者认为这是非常值得采用的思路——LLM 在自动 benchmark 上的分数对 prompt 的微小变化极其敏感(见 [evaluation-structured-outputs blog](https://huggingface.co/blog/evaluation-structured-outputs)),人类评测也不更一致,而**排名**在稳健评测方法下更稳定。
|
||||||
|
|
||||||
|
### 智能(intelligence)定义的困境
|
||||||
|
|
||||||
|
- 目前**极度缺乏**对"什么是模型智能、如何评测智能"的良好定义与框架(有人尝试过:Chollet 2019 [arxiv 1911.01547](https://arxiv.org/abs/1911.01547)、Hendrycks 等人 [agidefinition.ai](https://www.agidefinition.ai/paper.pdf))。
|
||||||
|
- 这不是 ML 独有的难题:人类/动物研究中同样难定义,IQ/EQ 等指标备受争议。
|
||||||
|
- 以"智能"为目标是**有问题的**,三个理由:
|
||||||
|
1. **移动目标(moving target)**:每当我们达到一个曾被当作人类专属的能力,这个词就被重新定义。
|
||||||
|
2. **框架不迁移**:现有框架以人类(或动物)为出发点设计,底层行为与假设与模型不同,很可能不适用于模型。
|
||||||
|
3. **本质无用**:应该瞄准让模型擅长**具体、定义良好、有目的、有用**的任务(如会计、报告),而不是为了 AGI 而 AGI。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## §3 2025 评测全景(2025-evaluations-for-useful-models + article.mdx)
|
||||||
|
|
||||||
|
> 新版先给出两个贯穿全篇的核心概念(来自 article.mdx 的 "Evaluating with existing benchmarks" 引言):
|
||||||
|
>
|
||||||
|
> - **Saturation(饱和)**:模型在 benchmark 上的表现超过人类表现。更广义地指数据集失去模型间区分力、不再有用——"如果所有模型分数都接近最高分,它就不再是 discriminative benchmark,就像拿学前班题目考高中生:成功说明不了什么(虽然失败能说明问题)"。
|
||||||
|
> - **Contamination(污染)**:评测数据集进了模型训练集,导致分数被人为抬高、不反映真实任务表现——"就像考学生他事先知道答案的题目"。
|
||||||
|
|
||||||
|
另外注意 2025 章节开头的**方法论警告**:单独评测具体能力通常很有价值(训练中或比较 base/pretrained 模型时),但**如果你用下面的评测去选择和验证训练方法,最终模型上再报告这些评测就是有偏的**(你已经把训练方法朝它们调优了)。
|
||||||
|
|
||||||
|
### 推理与常识(Reasoning and commonsense)
|
||||||
|
|
||||||
|
- 多为 BERT/embedding 时代的"历史数据集",当时有挑战性(常为对抗式构建),现在 **1) 太简单 2) 被污染/饱和**,只适合 ablation 或预训练评测。大数据集还常含错误/低质量问题(当年靠 Amazon Mechanical Turk 快速低成本扩展,如今由 LLM 生成评测题替代)。
|
||||||
|
- 代表数据集:
|
||||||
|
- **ARC**(2018,[arxiv 1803.05457](https://arxiv.org/abs/1803.05457),注意与 ARC-AGI 区分):小学科学 MCQA,选项当年对词共现系统对抗式选取;高质量 `challenge` 子集至今仍用于预训练。
|
||||||
|
- **WinoGrande**(2019,[arxiv 1907.10641](https://arxiv.org/abs/1907.10641)):众包代词消解/填空,对抗式配对。两者对模型都难到 2022–2023 年。
|
||||||
|
- **HellaSwag**(2019,[arxiv 1905.07830](https://arxiv.org/abs/1905.07830)):从 ActivityNet 字幕/WikiHow 教程选正确下一句,多需物理常识 grounding。
|
||||||
|
- **CommonsenseQA**(2018,[arxiv 1811.00937](https://arxiv.org/abs/1811.00937)):基于 ConceptNet 的常识 MCQA。
|
||||||
|
- **PIQA**(2019,[arxiv 1911.11641](https://arxiv.org/abs/1911.11641)):物理常识,Instructables 例子 + 语义扰动对抗选项。
|
||||||
|
- **OpenBookQA**(2018,[arxiv 1809.02789](https://arxiv.org/abs/1809.02789)):提供"开卷"事实,仍需潜在常识。
|
||||||
|
- 较新的亮点:**Zebra Logic**([arxiv 2502.01100](https://arxiv.org/abs/2502.01100))用逻辑谜题测推理,方法允许**无限生成谜题 → 污染极少**。
|
||||||
|
|
||||||
|
### 知识(Knowledge)
|
||||||
|
|
||||||
|
- **MMLU**(2020,[arxiv 2009.03300](https://arxiv.org/abs/2009.03300))是知识评测主力,已饱和/污染;深查发现多项问题:**引用缺失文档的不完整问题、错误 ground truth、歧义问题、主题明显的美国中心主义**。
|
||||||
|
- 后续清理/扩展:**MMLU-Redux**(2024,[arxiv 2406.04127](https://arxiv.org/abs/2406.04127))、**MMLU-Pro**(2024,[arxiv 2406.01574](https://arxiv.org/abs/2406.01574),**当前社区主要替代**)、**Global-MMLU**(2024,[arxiv 2412.03304](https://arxiv.org/abs/2412.03304),翻译+文化偏差标注)。主要用于预训练评测与 ablation。
|
||||||
|
- Post-training 用更难的:**GPQA**(2023,[arxiv 2311.12022](https://arxiv.org/abs/2311.12022)):生物/化学/物理博士级定制题,本领域 PhD 才能答对;最常用 `diamond` 子集,但自 2023 发布以来也开始污染。
|
||||||
|
- **Humanity's Last Exam / HLE**(2024,[agi.safe.ai](https://agi.safe.ai/)):2.5K 各领域专家众包题,多为私有,需复杂知识与推理,尚未被攻破。问题:**无法快速打分 → 大家用 LLM judge 评估答案而非对照 ground truth → 野外结果不可比**。
|
||||||
|
- 作者的判断:纯 latent knowledge 评测会逐步退出,两个理由:
|
||||||
|
1. **对人类不可读**:题目越来越复杂,非专家几乎无法理解每题分数的含义(也无法确认数据集本身没错误)。
|
||||||
|
2. **从 closed book 走向 open book**:模型接上工具/联网后,latent knowledge 评测日益变成 web search / retrieval 评测(类比法国教育:高中闭卷,大学默认可查资料,考的是"给你自由获取信息的能力下你怎么推理")。
|
||||||
|
|
||||||
|
### 数学(Math)
|
||||||
|
|
||||||
|
- 参考基准 **GSM8K**(2021,[arxiv 2110.14168](https://arxiv.org/abs/2110.14168),小学应用题)与 **MATH**(2021,[arxiv 2103.03874](https://arxiv.org/abs/2103.03874),奥赛题聚合)近年已饱和/污染。
|
||||||
|
- 衍生:**GSM1K**(2024,[arxiv 2405.00332](https://arxiv.org/abs/2405.00332),1K 新题测哪些模型在 GSM8K 上被污染)、**GSM-Plus**([arxiv 2402.19255](https://arxiv.org/pdf/2402.19255),对抗改写:干扰项、数值变体等)、**GSM-Symbolic**(2024,[arxiv 2410.05229](https://arxiv.org/abs/2410.05229),模板化可无限再生成防污染)。
|
||||||
|
- 社区当前聚焦:
|
||||||
|
- **MATH-500**(MATH 的代表性子集,防过拟合)与 MATH-Hard(最难的 500 题)
|
||||||
|
- **AIME 24/25**(美国高中奥赛,逐年换题等难度 → 可对比"发布时分数 vs 前一年分数"来测污染)
|
||||||
|
- **Math-Arena**([matharena.ai](https://matharena.ai/)):持续更新的竞赛/奥赛聚合(含 AIME25 等)
|
||||||
|
- 高端:**FrontierMath**(2024,[arxiv 2411.04872](https://arxiv.org/abs/2411.04872),数学家专写、理论上私有——但 OpenAI 似乎接触过部分数据);HLE 也含"现做"的复杂数学题(含定理证明)。
|
||||||
|
- 作者建议:**预训练评测用 AIME25 + MATH-500;post-training 用 Math-Arena**。
|
||||||
|
|
||||||
|
### 代码(Code)
|
||||||
|
|
||||||
|
- 历史(2021):**MBPP**(1K 众包 Python 入门题)、**APPS**(10K 面试/分享网站题)、**HumanEval**(Codex 论文,专门"为发布而写"的题,还带沙箱防恶意代码执行;**pass@k 估算器就是它提出的**,此前 pass@k 是"n 次中成功次数 ≥ k"的字面检查)。
|
||||||
|
- 加强版:**EvalPlus**(2023)的 HumanEval+/MBPP+(更多测试用例、修 bug、加输入);**EvoEval**(2024,[arxiv 2403.19114](https://arxiv.org/abs/2403.19114),语义改写 + 难度标注)。
|
||||||
|
- 最终模型用更难/未污染的:
|
||||||
|
- **LiveCodeBench**(2024,[arxiv 2403.07974](https://arxiv.org/abs/2403.07974)):记录题目日期,比较模型在**训练截止前后**题目上的表现——优秀的污染免疫基准。
|
||||||
|
- **AiderBench**([leaderboards](https://aider.chat/docs/leaderboards/),2024 底上线):来自 Exercism,专门测**代码编辑与重构**。
|
||||||
|
- Post-training 需要更整体:**RepoBench**(2023,仓库级自动补全,Python/Java);**SWE-Bench**(2024,用 GitHub 真实 issue 测逻辑理解、跨文件编辑、长上下文推理);**CodeClash**(2025,代码版 arena,模型代码互相对战迭代)。
|
||||||
|
- 作者建议(2025 年 11 月):关注 **LiveCodeBench、AiderBench、SWE-Bench verified**,并读 [METR 报告](https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/) 了解代码助手的真实效用。
|
||||||
|
|
||||||
|
### 长上下文(Long context)
|
||||||
|
|
||||||
|
- 3 年前模型上下文上限约 2048 tokens,现在普遍 128K+。
|
||||||
|
- **NIAH(Needle in a Haystack)**(2023):长无关文本中埋一条事实让其检索。2023 年模型很差,**2025 年接近解决**。
|
||||||
|
- 复杂扩展:**RULER**(2024,[arxiv 2404.06654](https://arxiv.org/abs/2404.06654),多跳追踪、词频变化、NIAH 的 QA 变体,也接近解决);**Michelangelo / MRCR**(2024,[arxiv 2409.12640](https://arxiv.org/pdf/2409.12640v2),多轮共指,后扩为 [OpenAI MRCR](https://huggingface.co/datasets/openai/mrcr) 2025);**InfinityBench**(2024,[arxiv 2402.13718](https://arxiv.org/abs/2402.13718),中英双语 100K token 合成任务,仍有信号)。
|
||||||
|
- **HELMET**(2024,[arxiv 2410.02694](https://arxiv.org/abs/2410.02694)):聚合 RAG/QA(Natural Questions、TriviaQA、PopQA、HotpotQA、NarrativeQA、InfinityBench)、recall(RULER、JSONKV)、带引用生成(ALCE 子集)、摘要、重排(MS MARCO)、ICL(TREC、NLU、Banking77、CLINIC150)等的大数据集。⚠️ **聚合基准有重复计量风险**:不要同时对模型跑 HELMET 和 InfinityBench 再聚合结果(等于同一评测跑两遍)。2025 年仍足够区分模型。
|
||||||
|
- 作者偏爱:**Novel Challenge**(2024,[arxiv 2406.16264](https://arxiv.org/abs/2406.16264),近一年出版小说的 1K 条真假 claims,须读完整本书);**Kalamang 翻译集**([arxiv 2309.16575](https://arxiv.org/abs/2309.16575),读语法书从英语翻到 Kalamang——只有约 200 个使用者的极低资源语言)。
|
||||||
|
|
||||||
|
### 指令遵循(Instruction Following)
|
||||||
|
|
||||||
|
- **IFEval**(2023,[arxiv 2311.07911](https://arxiv.org/abs/2311.07911))与扩展 **IFBench**(2025,[arxiv 2507.02833](https://arxiv.org/abs/2507.02833))。作者评价 IFEval 是近几年**最聪明的评测思路之一**:要求模型遵循格式化指令(关键词、标点、字数/句数、markdown/html 文件格式等),每个条件可用一个特定解析测试校验 → **少数无需 model judge 就能拿到严格分数的 free-form generative evaluation**。属 functional correctness / unit-test 型评测,且**极易再生成/扩展以抗污染**。
|
||||||
|
- 反向评测:**CoCoNot**(2024,[arxiv 2407.12043](https://www.arxiv.org/pdf/2407.12043))测模型对不完整/不可答/不安全请求的**不服从**(non-compliance)。
|
||||||
|
|
||||||
|
### 工具调用(Tool-calling)
|
||||||
|
|
||||||
|
- **TauBench**(2024,[arxiv 2406.12045](https://arxiv.org/pdf/2406.12045)):零售/航空域模拟数据库,模型动作正确更新数据库 + 恰当回答用户才算对;用户由 **LLM 模拟** → 昂贵且易错,但贴近真实用例。
|
||||||
|
- **ToolBench**(2023,[arxiv 2305.16504](https://arxiv.org/pdf/2305.16504)):调用真实/模拟 API 解 100 个测试用例;因 API 不稳定被 **StableToolBench**(2025,[arxiv 2403.07714](https://arxiv.org/pdf/2403.07714))用通用 VirtualAPIServer 修复,但改依赖 LLM judge(引入新偏见层)。
|
||||||
|
- **BFCL**(2025,[OpenReview](https://openreview.net/pdf?id=2GmDdhBdDk),历史有几年):当前版本 4 个子集——single turn、众包真实函数调用、多轮对话、agentic(web search/memory/SQL);用 **AST + 执行响应 + 状态匹配**(最终状态是否预期)判定正确性;v3 测工具调用、v4 测 web/search。
|
||||||
|
- MCP 时代基准(多依赖 model judge + 真实 API → 网络故障/可复现性问题):
|
||||||
|
- **MCPBench**(2025,[arxiv 2508.20453](https://arxiv.org/abs/2508.20453)):连真实 MCP server(Wikipedia、HF、Reddit、Steam、arxiv…),规则检查工具调用有效性 + LLM judge 查回答。
|
||||||
|
- **MCP-Universe**(2025,[arxiv 2508.14704](https://arxiv.org/abs/2508.14704)):11 个真实主题 MCP server;**多个严格 evaluator**(格式 1 个 + 回答正确性 2 个),动态任务用基于执行的评估框架自动抓最新正确值对比——作者认为比 LLM judge 干净得多。
|
||||||
|
- **LiveMCPBench**(2025,[arxiv 2508.01780](https://arxiv.org/abs/2508.01780)):本地可部署的 MCP server 集合,测模型在工具列表中**辨别选对工具**的能力;最强模型已达 80% → **接近饱和**。
|
||||||
|
- 附:Anthropic 的 [Writing tools for agents](https://www.anthropic.com/engineering/writing-tools-for-agents) 文档。
|
||||||
|
|
||||||
|
### 助手任务(Assistant tasks)
|
||||||
|
|
||||||
|
> 作者认为 **assistant tasks 是下一代评测的主要方向之一**:解决它们需要多能力组合(长上下文 + 推理 + 工具调用…),又针对具体领域给出真实场景表现;对大众更可理解;若设计得够通用,不检查用了哪个具体工具,只检查最终结果是否正确(复杂任务允许多条成功路径)。
|
||||||
|
|
||||||
|
- **真实信息检索**:**GAIA**(2023,[arxiv 2311.12983](https://arxiv.org/abs/2311.12983))开启现代 agentic 评测,3 个难度级别(L1 已饱和,L3 仍难);因报告口径不一(公开验证集 vs LLM judge 打私有测试集)数值分散。**BrowseComp**(2025,[OpenAI PDF](https://cdn.openai.com/pdf/5e10f4ab-d6f7-442e-9508-59515c65e35d/browsecomp.pdf))反向构造题目(从结果反推问题,不保证答案唯一),目前可能更难。**GDPval**(2025,[arxiv 2510.04374](https://arxiv.org/abs/2510.04374))覆盖美国 GDP 前几大行业 44 个职业,用 model judges 对比人机表现。**GAIA2**([blog](https://huggingface.co/blog/gaia2))用 mock 手机环境测事件链 + 工具调用;**时间敏感与故意噪声子集(模拟失败 API 调用)最难**,search/execution 对 SOTA 已极容易。
|
||||||
|
- **科学助手**:**SciCode**(2024,[arxiv 2407.13168](https://arxiv.org/abs/2407.13168))写科学代码解 STEM 实际问题,发布时模型 <5%;**PaperBench**(2025,[arxiv 2504.01848](https://arxiv.org/abs/2504.01848))给 ICML 论文重建代码库(作者贡献 8K 个独立评分任务,rubric trees 加权),用 LLM judge;**DSBench**(2025,[arxiv 2409.07703](https://arxiv.org/pdf/2409.07703))Kaggle/ModelOff 多模态数据分析;**DABStep**(2025,[arxiv 2506.23719](https://arxiv.org/abs/2506.23719))用**此前私有的真实运营数据分析工作负载**(因此未污染),每道题有 ground truth → 评测无偏且不算太贵,作者很推荐。
|
||||||
|
|
||||||
|
### 游戏化评测(Game-based)
|
||||||
|
|
||||||
|
- 优点:测**对变化环境的适应性**(多数 assistant tasks 是静态的)、需要长上下文推理、**大众能理解**;缺点:不 grounded in real life,未必反映真实有用用例。
|
||||||
|
- **ARC-AGI**([arcprize.org](https://arcprize.org/arc-agi)):2019 版网格谜题(找序列下一项,不给显式规则),类似逻辑 IQ 测试,2024 年几乎被解;**ARC-AGI3**(2025 进行中)含全新游戏(探索、复杂规划、记忆管理),目前最佳解是暴力搜索。类似规则外推基准:**Baba is AI**(2024,[arxiv 2407.13729](https://arxiv.org/abs/2407.13729))。
|
||||||
|
- 单人冒险/RPG:**TextQuests**(2025,[blog](https://huggingface.co/blog/textquests))、**Pokemon**(2024,Claude/Gemini 在 Twitch 直播玩)——需要超长程规划、长上下文记忆管理、推理与回溯;生存游戏 **Crafter**(2021,[arxiv 2109.06780](https://arxiv.org/abs/2109.06780),Minecraft 灵感)同能力;多人游戏环境已集成进 **Balrog**(2024,[arxiv 2411.13543](https://arxiv.org/pdf/2411.13543))。
|
||||||
|
- 对抗/欺骗类:**Poker**(2025,[arxiv 2501.08328](https://arxiv.org/html/2501.08328v1))、**Town of Salem**(2025)、**Werewolf**([arxiv 2407.13943](https://arxiv.org/abs/2407.13943))、**Among Us**——测逻辑、推理与**欺骗能力**(例:Claude Opus 4 当不了吸血鬼这类欺骗角色,但当农民(非欺骗角色)表现好);合作游戏 **Hanabi**([arxiv 2510.04980](https://arxiv.org/abs/2510.04980))测受限环境下的适应与沟通。
|
||||||
|
- 妙处:**单一无歧义的 pass/fail 指标——LLM 赢没赢**。作者建议:能力看 TextQuests,安全看 Town of Salem。
|
||||||
|
|
||||||
|
### 预测未来(Forecasters)
|
||||||
|
|
||||||
|
- 一类**无法污染**的新任务:预测未发生事件。但不确定是否足够 discriminative,且可能强化 LLM 的"老虎机式成功"感(答对是因为题太简单/公式化,还是真会预测?答错是因为不可预测还是模型差?)。
|
||||||
|
- **FutureBench**([blog](https://huggingface.co/blog/futurebench)):浏览 + LLM 按周生成问题 + 博彩市场用户预测;目前模型对人类下注的题仅略好于随机,对模型生成题 3/4 正确(后者更简单)。
|
||||||
|
- **FutureX**([arxiv 2508.11987](https://arxiv.org/abs/2508.11987)):预测市场/政府网站/排名网站/实时数据平台 + 模板生成("STOCK 何时到 POINT?"),每天 500 题并过滤无关题。
|
||||||
|
- **Arbitrage**([arxiv 2412.18544](https://arxiv.org/pdf/2412.18544)):类似但事件要 2028 年才揭晓。
|
||||||
|
- 金钱交易类 arena(Alpha Arena、Trading Agents):因成本每个模型只跑一次 → **没有统计显著性**。
|
||||||
|
|
||||||
|
### 2025 年 11 月的评测推荐(Recommendations 原文)
|
||||||
|
|
||||||
|
- **核心能力(model builders)**:训练用老能力评测;post-training 用 AIME26(等它发布)、**GPQA、IFEval、SWE-Bench**、选一个长上下文评测(如 HELMET),目标工具使用就加 **TauBench 或 BFCL**。
|
||||||
|
- **核心能力(inference 对比模型)**:**IFBench、HLE、MathArena、AiderBench、LiveCodeBench、MCP-Universe**。
|
||||||
|
- **长 horizon 任务(真实世界表现)**:**GAIA2、DABStep、SciCode**,或你用例的领域评测。
|
||||||
|
- **游戏(鲁棒性与适应性)**:ARC-AGI3(出了再用)、TextQuests、Town of Salem(关注安全)或任何超越 Poker/Chess/Go 的游戏。
|
||||||
|
- 趋势总结:评测正从"孤立技能"转向"**能力编排(capability orchestration)**"——系统能可靠组合核心能力 + 工具使用来真正解决问题。作者希望行业**更重视 functional testing 而非 model judges**,以及更可理解的数据集与任务。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## §4 三种任务形式:MCF / CF / FG(与 log-likelihood 细节)
|
||||||
|
|
||||||
|
新版在 inference 基础章节重点讲清了"同一道选择题可以有不同的**任务表述(task formulation)**"以及 log-likelihood 的计算细节——这是旧版没有展开的部分。
|
||||||
|
|
||||||
|
### log-likelihood 评测的计算步骤
|
||||||
|
|
||||||
|
给定 prompt 与一个(或多个)答案,问"我的模型生成该答案的概率是多少":
|
||||||
|
|
||||||
|
1. 把**每个 choice 与 prompt 拼接**,传入 LLM,得到每个 token 的 logits;
|
||||||
|
2. **只保留 choice tokens 对应的 logits**,做 log softmax 得到 log-probabilities(范围 `[-inf, 0]` 而非 `[0, 1]`);
|
||||||
|
3. **对所有 token 的 log 概率求和**,得到该 choice 的整体 log probability;
|
||||||
|
4. 最后按 **choice 长度做归一化**(防止偏向短答案)。
|
||||||
|
|
||||||
|
由此可做:多选中的首选答案;测试某个 choice 概率是否 > 0.5;**研究模型 calibration**(well calibrated model = 正确答案拥有最高概率)。calibration 参考:[Anthropic 论文](https://arxiv.org/abs/2207.05221)(是什么、如何检测、如何训练校准良好)+ [校准的局限](https://arxiv.org/abs/2311.14648)。
|
||||||
|
|
||||||
|
### 三种常见任务表述(formulation)
|
||||||
|
|
||||||
|
| 表述 | 含义 | 示例 |
|
||||||
|
|---|---|---|
|
||||||
|
| **MCF**(Multiple Choice Format) | 选项**显式呈现在 prompt 中**,前缀 A/B/C/D,比较各选项 index 的 likelihood | MMLU |
|
||||||
|
| **CF**(Cloze Formulation) | **不提供选项**,直接比较不同 choice 的 likelihood | 填空式 |
|
||||||
|
| **FG**(Freeform Generation) | 对给定 prompt 的 **greedy generation** 计算 accuracy | 自由生成 |
|
||||||
|
|
||||||
|
### 如何选择(对评测的影响)
|
||||||
|
|
||||||
|
- **FG 需要大量潜在知识(latent knowledge),短预训练 ablation 期间对模型通常太难** → 小规模 ablation 一般用多选表述(MCF 或 CF)。
|
||||||
|
- 但研究显示**模型在训练早期学不会 MCF**(需要大量训练才获得该技能),CF 提供更好的早期信号 → **建议:小 ablation 用 CF;主 run(main run)加入 MCF**(模型过了某个阈值、SNR 足够后,MCF 给出更好的中期信号)。
|
||||||
|
- 关键数字:**MMLU MCF 何时脱离随机表现取决于模型规模与数据量**——7B transformer 约 **500B tokens**(OLMES 论文);1.7B 模型约 **6T tokens**(SmolLM2 实验)。
|
||||||
|
- 对于 post-trained 模型,**FG 是主要表述**(要测模型能否真正生成有用回答)。
|
||||||
|
- CF 类 sequence-likelihood 评测算 accuracy 时:**正确答案 log probability 最高(按字符/token 数归一化)的题占比**——归一化防止偏向短答案。
|
||||||
|
|
||||||
|
### tokenization 对 log-likelihood 比较的破坏(细节)
|
||||||
|
|
||||||
|
- 一般希望**把 context 与 choices 一起 tokenize**(产生对模型自然/可能的一串 token)。
|
||||||
|
- 但有些 tokenizer(如 Llama 的,[lm-eval issue](https://github.com/EleutherAI/lm-evaluation-harness/pull/531#issuecomment-1595586257))不满足 `tok(context + choice) = tok(context) + tok(choice)`(会增删空格)→ context tokens 会"渗入"choice,破坏比较。
|
||||||
|
- 具体例子:若 `C1C2` 恰好是一个 BPE token,context=`C1`、choices=`C2`/`C3`:一起 tokenize 比较的是 `C1C2`(1 token)vs `C1+C3`(2 tokens),**即使按长度归一化也没可比性**;分开 tokenize 比较 `C1+C2` vs `C1+C3`,但 `C1+C2` 这种组合在编码器数据里罕见,模型的 log-probability 会被压低。
|
||||||
|
- 解决方案(两害相权):**分别 tokenize context 与 choice,去掉可能附加的 start/end 特殊 token 后再拼接比较**。
|
||||||
|
|
||||||
|
### generative 评测
|
||||||
|
|
||||||
|
- 自回归生成:传 prompt → 取最可能下一 token → 重复直到结束条件(最大长度/停止 token)→ 全部生成 token 即答案。
|
||||||
|
- 与 reference 比较打分:exact match、BLEU 等简单指标,或 model judges。
|
||||||
|
- 补充参考:⭐ [Open LLM Leaderboard MMLU blog](https://huggingface.co/blog/open-llm-leaderboard-mmlu)(多选 log-likelihood 与 generative 的差异及分数含义);⭐ [EleutherAI 对上述推理方法的数学形式化](https://arxiv.org/abs/2405.14782v2)(直接看 Appendix)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## §5 设计自动评测(designing-your-automatic-evaluation + article.mdx)
|
||||||
|
|
||||||
|
新版把"设计自动评测"重写为完整方法论。**与旧版不同的章节结构**(原文实际顺序):
|
||||||
|
|
||||||
|
```
|
||||||
|
Dataset(使用现有数据/聚合 → [嵌入 UsingHumanAnnotators] → 合成创建 → 污染管理)
|
||||||
|
→ Choosing a prompt(选 prompt)
|
||||||
|
→ Choosing an inference method(选推理方法)
|
||||||
|
→ Scoring(打分:log-prob 简单 / generative 复杂)
|
||||||
|
→ Evaluation's main challenge: Scoring free form text(自由文本评分)
|
||||||
|
├─ Automatically:Metrics → Normalization → Sampling → Functional scorers
|
||||||
|
├─ With humans
|
||||||
|
├─ With judge models(judge 获取 → prompt 设计 → 评估 evaluator → tips → reward models)
|
||||||
|
└─ Constraining model outputs(prompt → few-shot/ICL → structured generation)
|
||||||
|
→ The forgotten children of evaluation(统计有效性 / 成本效率)
|
||||||
|
```
|
||||||
|
|
||||||
|
其中 **"With judge models" 小节与旧版 03-LLM-as-a-Judge 笔记内容重叠**(judge-LLM 获取、prompt 设计、评估 evaluator、偏差缓解、reward models),但新版表述更精炼,本笔记只简要提及差异点,重点写旧版没有的内容(数据检查清单、指标详解、normalization/Math-Verify、sampling、functional scorers、constraining outputs、统计有效性与成本)。
|
||||||
|
|
||||||
|
### 5.1 数据集:使用现有 / 聚合 / 合成
|
||||||
|
|
||||||
|
**使用现有数据与聚合**
|
||||||
|
- 可直接用现有数据集改 prompt 或指标;也可**聚合多个数据集**建针对性评测套件(例:"Measuring AGI"论文作者的做法)。
|
||||||
|
- 聚合时注意:**冗余数据**(大多数数学数据集是同一批初始题的改写/聚合);**来源平衡**(避免单数据集主导偏斜,这也决定按样本还是按子集聚合分数);**格式与难度兼容**(尤其别混用需要 sampling 与不需要的样本)。例子:MMLU、Big-Bench、HELM。
|
||||||
|
- EpochAI 2025 研究:如何在单一框架下[最佳聚合 benchmark](https://epoch.ai/blog/a-rosetta-stone-for-ai-benchmarks),让聚合数据集整体更难、更不易饱和。
|
||||||
|
|
||||||
|
**规则式(rule-based)合成——近乎无限的样本 + 免污染**
|
||||||
|
- 程序化生成几乎无限的新测试用例,算法可控难度、自动验证。典型任务:数学/逻辑/代码。
|
||||||
|
- 例子:**NPHardEval**(图问题、自动验证、月度刷新防过拟合)、**DyVal**、**MuSR**(neuro-symbolic 生成 1000 字谋杀谜题等复杂推理实例)、**BabiQA**(实体按动作序列模拟)、**ZebraLogic**(SAT solver 生成解并迭代最小化线索)、**IFEval**(500+ 条含可程序校验约束的 prompt)、**GSM-Symbolic**(模板生成多样数学题)。
|
||||||
|
|
||||||
|
**用模型合成数据**
|
||||||
|
- 流程:从若干 **seed documents**(内部文档或 Wikipedia/Stack Overflow 等高质量公开源,作为 ground truth)出发 → **chunk 成自包含语义单元** → 用 **frontier model + 精心设计的 prompt** 从数据出题(最好要求模型给出题目所依据的 source)→ 用**另一模型家族**的模型当 judge 做自动验证 → **每个步骤都要人工检查数据**("无论多诱人,别全自动")。
|
||||||
|
- 进阶:可用 seed prompts 当示例,让外部模型替你写"出题 prompt"。
|
||||||
|
|
||||||
|
### 5.2 数据创建流程检查清单(来自 article.mdx "Understanding what's in there")
|
||||||
|
|
||||||
|
无论怎么选数据集,**最重要的一步永远是看数据**(看数据本身、看模型生成、看分数),这是确认评测是否贴合用例的唯一方式。检查三点:
|
||||||
|
|
||||||
|
1. **谁创建了样本?** 理想排序:专家 > 付费标注者 > 众包 > 合成 > MTurk。看 data card 的标注者人口统计(理解语言多样性/潜在文化偏差)。
|
||||||
|
2. **样本是否被其他标注者或作者复核过?** 看 inter-annotator agreement 是否高、数据集是否被作者整体检查过。对低薪标注者(尤其非目标语言母语的 MTurk)尤其重要,否则会有 typo/语法错误/无意义答案。
|
||||||
|
3. **标注者是否拿到清晰的数据创建指南?** 即数据集是否一致。
|
||||||
|
|
||||||
|
### 5.3 样本检查(Samples inspection)
|
||||||
|
|
||||||
|
- **取 50 个随机样本人工检查——要自己看,不要"让 LLM 帮你找异常"**。
|
||||||
|
- 内容质量:prompt 是否清晰无歧义?答案是否正确(例:**TriviaQA 每个问题有多个 gold answers(aliases 字段),有时互相冲突**)?信息是否缺失(例:**MMLU 一些题引用不存在的图表**)?
|
||||||
|
- 与任务的相关性:这些题是不是你想让 LLM 回答的那类题?是否贴合用例?
|
||||||
|
- 一致性(尤其要用于 few-shot 或聚合统计时):多选题各样本选项数是否一致?prompt 前后空格是否一致?带环境的话弄清环境会调用什么。
|
||||||
|
- **样本数量**:确认足以统计显著——**自动 benchmark 通常最少 100 个样本**。
|
||||||
|
- 指标类型也在此检查:automatic / functional / model judge 三类,成本、可复现性、偏差类型不同;**最好(也最稀有)的是 functional 或 rule-based verifier 类指标**。⚠️ code eval 里要小心**过简单的 pass/fail 单元测试**:现在的 LLM 很会"改写全局变量作弊"(尤其 Python 这种作用域可被搞乱的语言)。
|
||||||
|
|
||||||
|
### 5.4 选择 prompt 与推理方法
|
||||||
|
|
||||||
|
**Prompt 组成**:可选 task prompt(介绍任务与输出格式)+ 附加 context(source、image 等)+ problem prompt(你问模型的问题)+ 多选时的选项。注意:
|
||||||
|
- **语义等价的 prompt 微小改动可让结果差很多**,某些 prompt 格式会偏袒/亏待特定模型。
|
||||||
|
- 缓解:多次运行不同 prompt 变体(贵);或**一次运行中把多种 prompt 格式分配给等价难度的不同样本**。
|
||||||
|
- 用 few-shot 示例帮模型跟格式,加 connector words 有帮助。
|
||||||
|
|
||||||
|
**推理方法选择**:
|
||||||
|
- **log-probabilities**(适合 MCQA、测知识/消歧):
|
||||||
|
- Pros:所有模型都能"看到"正确答案;提供 confidence/calibration 代理;快(尤其只预测一个 token:A/B/C/D 或 Yes/No);小模型也能拿到任务信号。
|
||||||
|
- Cons:**略微高估小模型**(若自由生成它们可能生成选项之外的内容);部分模型有 **choice order bias**([arxiv 2309.03882](https://arxiv.org/abs/2309.03882))——除非预算允许打乱样本顺序重跑 n 次取显著性。
|
||||||
|
- 加速技巧:若选项都是单 token,**只跑一次 context 的 forward pass**,直接在完整词表概率分布上取各选项的 logprob,省掉 n 次拼接推理。
|
||||||
|
- **generative**(测流畅度、推理、是否真能作答;**评测 reasoning 模型最相关**):
|
||||||
|
- Pros:与真实兴趣一致;**唯一能同时评测开源与闭源模型的方式**。
|
||||||
|
- Cons:更难打分;比 log-likelihood 贵(尤其带 sampling 或 reasoning 模型)。
|
||||||
|
|
||||||
|
### 5.5 指标详解(打分自由文本)
|
||||||
|
|
||||||
|
log-probability 打分容易:accuracy 变体(最可能 choice 是否最佳),**务必按序列长度归一化**(字符/token/PMI),也可看 perplexity/recall/f1。generative 打分是难点:
|
||||||
|
|
||||||
|
**基于匹配(match-based)的指标**:
|
||||||
|
- **exact match**:最简单最不灵活,无部分 credit(错一个词 = 全错)。注意 "exact match" 是伞形称呼,常包含 fuzzy 变体:带 normalization、只比 token 子集(如 prefix)。
|
||||||
|
- **BLEU**:与参考译文做 n-gram 重叠;仍广泛使用但有**偏向短译文的长度偏差**、句级与人类相关性差(语义等价但写法不同就不行)。
|
||||||
|
- **ROUGE**:类似但更偏向 recall 的 n-gram 重叠。
|
||||||
|
- **TER**(translation error rate):从预测到参考所需的编辑次数(类似编辑距离)。
|
||||||
|
- **BLEURT**:基于 BERT 的学习表示,用 WMT 人类判断训练,语义理解强于 n-gram,但需下载模型 + task-specific fine-tuning 才最优。
|
||||||
|
- 变体/扩展:CorpusBLEU、GLEU、MAUVE、METEOR 等。
|
||||||
|
|
||||||
|
**聚合方式**:
|
||||||
|
- binary 分数:**precision**(FP 代价高时关键)、**recall**(漏报代价高时关键)、**F1**(平衡二者,适合不平衡数据)、**MCC**(Matthews Correlation Coefficient,考虑全部混淆矩阵元素,适合不平衡数据)。
|
||||||
|
- continuous 分数:**MSE**(重罚大误差、但对 outlier 权重高)、**MAE**(更均衡);若假设线性回归(如研究 calibration):**R²**、**Pearson**(线性关系、假设正态)、**Spearman**(单调关系、无正态假设)。
|
||||||
|
- **别只测平均**:对某些领域(医疗、面向公众的 chatbot、毒性)需要评估**最差表现**。
|
||||||
|
|
||||||
|
**自动评测的优缺点**:一致可复现(同一模型跑 10 次同结果,可做公平排名)、规模成本低、可理解;缺点:复杂任务上用途有限——自动指标需要**完美、唯一、无歧义的 reference/gold**,复杂能力很难分解成单一简单答案。
|
||||||
|
|
||||||
|
### 5.6 Normalization 与 Math-Verify
|
||||||
|
|
||||||
|
- Normalization = 把字符串改写成适配特定参考格式(不惩罚多余空格/标点/大小写);对数学评测等**需要从长预测中提取方程并对比参考**的任务至关重要。
|
||||||
|
- 原文件列出了用 SymPy 朴素提取 MATH 数据集答案时的典型问题,以及 **Math-Verify**(专用数学解析器)如何解决:
|
||||||
|
|
||||||
|
| 示例 | 问题 | ✅ Math-Verify | 🛑 朴素方法 |
|
||||||
|
|---|---|---|---|
|
||||||
|
| "Therefore, the perimeter of one of these triangles is $14 + 7\sqrt{2}$ inches, expressed in simplest radical form." | 提取失败 | `7\*sqrt(2) + 14` | None |
|
||||||
|
| "Therefore, the sum of the infinite geometric series is \(\frac{7}{9}\)." | 提取失败 | `7/9` | None |
|
||||||
|
| "The final answer is $2x + 4y + z - 19 = 0$. I hope it is correct." | 参数方程部分解析 | `Eq(2\*x + 4\*y + z - 19, 0)` | `0` |
|
||||||
|
| \(23\) | latex 边界导致提取失败 | `23` | None |
|
||||||
|
| \((- \infty, -14) \cup (-3, \infty)\). | 区间提取失败 | `Union(Interval.open(-oo, -14), Interval.open(-3, oo))` | None |
|
||||||
|
| 100\% | 无效符号提取失败 | `1` | None |
|
||||||
|
| 1/3 == 0.333333 | 不支持舍入 | `True` | `False` |
|
||||||
|
| sqrt(1/2)\*7 == sqrt(0.5)\*7 | 不支持数值求值 | `True` | `False` |
|
||||||
|
|
||||||
|
- 详见 [Math-Verify leaderboard blog](https://huggingface.co/blog/math_verify_leaderboard)。⚠️ Normalization 设计不好**很容易不公平**([open-llm-leaderboard-drop](https://huggingface.co/blog/open-llm-leaderboard-drop)),但总体上在任务层面仍提供信号。
|
||||||
|
- 对 CoT / reasoning 生成,**需先从输出中移除 reasoning trace**(不是最终答案的一部分)再取答案。
|
||||||
|
|
||||||
|
### 5.7 Sampling 指标(pass@k / maj@n / cot@n / avg@n)
|
||||||
|
|
||||||
|
多次采样聚合比单次 greedy 更稳健,对复杂推理任务尤其重要:
|
||||||
|
|
||||||
|
- **pass@k over n**:n 个生成样本中至少有 k 个通过。两种实现:朴素 `pass@k = (c >= k)`;**无偏估计量** `pass@k = 1 - C(n-c,k)/C(n,k)`(c = n 个样本中正确的数量)。
|
||||||
|
- **maj@n(majority voting)**:采 n 次取最频繁答案;能滤掉杂散输出,当模型**正确推理路径比错误更一致**时效果好;常用于数学与推理。
|
||||||
|
- **cot@n**:采 n 条推理链评估;可与 majority voting 或 pass@k 组合(采 n 条链、提取最终答案、取多数或设阈值)。
|
||||||
|
- **avg@n**:n 个样本分数平均;比"取最好"或"取最常见"更稳定的性能估计。
|
||||||
|
|
||||||
|
使用要点:
|
||||||
|
- **永远报告全部采样参数**(temperature、top-p、k),它们显著影响结果。
|
||||||
|
- **训练评测/ablations:❌ 一般避免 sampling 指标**(贵、加方差),用固定 seed 的 greedy decoding。
|
||||||
|
- **post-training 评测:✅ 需要**,sampling 能暴露 greedy 看不到的能力(推理/数学/代码类复杂任务)。
|
||||||
|
- **推理时:✅ 有用**——估计多次采样能提升多少,尤其研究 test-time compute 能把小模型推到多远。
|
||||||
|
- ⚠️ 采样 k 次使评测成本 ×k,贵模型/大数据集上累积很快。
|
||||||
|
|
||||||
|
### 5.8 Functional scorers(函数式打分 / 功能测试)
|
||||||
|
|
||||||
|
- 核心思想:**不做模糊字符串匹配,而是检查输出是否满足可验证的约束**。更灵活、允许通过规则生成"无限"更新测试用例(降低过拟合)。
|
||||||
|
- **IFEval / IFBench 是最佳范例**:不问"文本是否匹配参考答案",而问"文本是否满足指令中的格式约束",例如:
|
||||||
|
- *"Include exactly 3 bullet points"* → 校验输出恰好 3 个 bullet
|
||||||
|
- *"Capitalize only the first sentence"* → 解析并检查大小写模式
|
||||||
|
- *"Use the word 'algorithm' at least twice"* → 数词频
|
||||||
|
- *"Your response must be in JSON format with keys 'answer' and 'reasoning'"* → 校验 JSON 结构
|
||||||
|
- 每个约束配一个 rule-based verifier → 评测更无歧义、可解释、快、且**远便宜于 model judges**。
|
||||||
|
- 灵感来自代码评测(单元测试是标准做法)。关键挑战:**找到能用程序验证的文本属性**,对指令遵循效果很好,扩展到其他文本属性需要创造力。
|
||||||
|
|
||||||
|
### 5.9 人类评测(简述,与旧版一致)
|
||||||
|
|
||||||
|
- **Vibe-checks**:社区个人在未公开 prompt 上的手动"体感"评测,多为轶事证据、易受确认偏差影响;但[是自家用例的好起点](https://olshansky.substack.com/p/vibe-checks-are-all-you-need)。
|
||||||
|
- **Arena**:社区投票排名(如 LMSYS chatbot arena),Elo 聚合;主观性强、标注者偏好有文化差异([arxiv 2404.16019](https://arxiv.org/abs/2404.16019v1)),靠"群众智慧"规模效应平滑。
|
||||||
|
- **Systematic annotations**:付费精选标注者 + 极其具体的指南;贵、不自动、仍有人类偏差(不同身份者对毒性打分差异很大,[arxiv 2205.00501](https://arxiv.org/abs/2205.00501))。
|
||||||
|
- 扩展规模三条路:无数据集(给任务+评分指南+模型)→ 有数据集(preprompt + 输出 + 指南)→ 有数据集和分数(error annotation 复核评测方法)。
|
||||||
|
- 人类评测的已知偏差(第一印象、语气、与标注者价值观对齐等)必须考虑:**任何要求事实性的任务(代码、知识)都应叠加更稳健的评测方式**(专家、自动指标等)。详见 [[02-Human-Evaluation]]。
|
||||||
|
|
||||||
|
### 5.10 Judge models(新版压缩版,与 [[03-LLM-as-a-Judge]] 重叠)
|
||||||
|
|
||||||
|
> 本节与旧版 03 笔记内容重叠:新版把整个 judge 大章节压缩进 designing 的 "With judge models" 小节,表述更精炼、几乎没有新增论点。以下是压缩后的要点,供快速对照;完整展开见 [[03-LLM-as-a-Judge]]。
|
||||||
|
|
||||||
|
- 定义:用神经网络(或其衍生品)评估另一神经网络的输出;多数情况评文本生成。
|
||||||
|
- 两条路线:**通用高能力模型**(LLM + prompt)或**小型专用模型**(从偏好数据训练判别,如"毒性垃圾邮件过滤器")。
|
||||||
|
- **闭源模型(Claude、GPT-o)**:不可复现(API 更新随时变)、黑盒、隐私风险;优点是免本地部署。**开源模型正在追平**(DeepSeek R1、gpt-oss、最新 Qwen 是竞争性替代)。
|
||||||
|
- **小型专用 judge**(数 B 参数、可本地跑):Flow-Judge-v0.1(3.8B,Phi-3.5-mini-instruct 微调)、Prometheus(13B,从零训练)、JudgeLM(7–33B)。**自训 judge 除非 niche 领域否则不建议**;偏好数据可来自 [lmsys 竞赛](https://www.kaggle.com/competitions/lmsys-chatbot-arena) 或 Prometheus collections;[从 reward model 起步优于从 instruct model](https://x.com/dk21/status/1826292289930674590)。
|
||||||
|
- **judge prompt 设计**:任务描述 → 评估标准(含详细评分系统)→ 推理步骤 → 指定输出格式(如 JSON `{"Score": ..., "Reasoning": ...}`)。参考 [MixEval](https://github.com/huggingface/lighteval/blob/main/src/lighteval/tasks/extended/mix_eval/judge_prompts.pyy)/[MTBench](https://github.com/huggingface/lighteval/blob/main/src/lighteval/tasks/extended/mt_bench/judge_prompt_templates.py) 模板。**Pairwise 比较比打分与人类偏好相关性更好**([arxiv 2403.16950](https://arxiv.org/abs/2403.16950));整数刻度要给每个分数的详细解释或用 additive prompt;**每个能力一个 prompt**;可用 few-shot / reference / CoT(先输出推理再打分)/ 多轮分析 / **jury(多个 judge 聚合,可用多个小模型降本)** 提升准确率。
|
||||||
|
- **评估你的 evaluator**(上线前必做):选 baseline(**约 50 个示例即可**,但必须 representative / discriminative / high quality)→ 选 metric(binary/pairwise 的 accuracy/precision/recall 易解释;score 相关性难)→ 评估并定阈值:**pairwise 对比可设 80%–95% accuracy;score 相关性文献常满意于 0.8 Pearson**(也有人宣称 0.3 就算与人类标注相关良好——"ymmv")。
|
||||||
|
- **judge 偏差与缓解**:internal consistency(self-consistency prompting 取多数)→;self-preference(用 jury);input perturbation blindness(**先给 reasoning 再给分**、给连贯评分刻度);position-bias(随机交换答案位置、用 logprob 归一);verbosity/length-bias(考虑长度差,[arxiv 2404.04475](https://arxiv.org/abs/2404.04475));format bias(遵守模型训练 prompt 格式)。
|
||||||
|
- **LLM evaluators 的已知弱点**:整体上**不擅长识别幻觉**(尤其 partial hallucinations,[arxiv 2305.11747](https://arxiv.org/abs/2305.11747)、[2303.08896](https://arxiv.org/abs/2303.08896));在摘要/忠实性上与人类标注相关性低到中等,跨任务不持续与人类一致([arxiv 2406.18403](https://arxiv.org/abs/2406.18403))。
|
||||||
|
|
||||||
|
**Reward Models(奖励模型)**
|
||||||
|
- 学人类标注预测 prompt/completion 对得分,目标是与人偏对齐;最常用 **Bradley-Terry**:`p(completion b better than a) = sigmoid(score_b - score_a)`,只用 pairwise 比较训练(比收集分数容易),但**只能比较同一 prompt 内的 completion**。
|
||||||
|
- 变体:更细粒度概率版([RLHFlow pair-preference](https://huggingface.co/RLHFlow/pair-preference-model-LLaMA3-8B));**绝对分数**版 **SteerLM**([arxiv 2311.09528](https://arxiv.org/abs/2311.09528),评测易用但数据难收集——绝对分数比 pairwise 不稳定);两者皆出的 **HelpSteer2-Preference**([2410.01257](https://arxiv.org/abs/2410.01257))与 **ArmoRM**([2406.12845](https://arxiv.org/abs/2406.12845))。
|
||||||
|
- **评测用法**:绝对分数可平均成汇总;但**相对分数不要直接平均 raw reward**(outlier 与 prompt 难度不同会偏置)——改用 **win rates**(对参考 completion 集合,胜率百分比)或 **win probabilities**(均值概率,更细更平滑)。
|
||||||
|
- 特性:**非常快**(小模型一次 forward pass)、**确定性**、**少 position bias**、**无需 prompt engineering**;缺点:需专用微调、分布外任务表现差、**同一 RM 既用于 RL 又用于评测会过拟合**(reward hacking)。
|
||||||
|
- 资源:RewardBench Leaderboard、Nemotron 论文用法、用 win rate 跟踪训练以**检测退化并选最优 checkpoint**([arxiv 2410.11677](https://arxiv.org/abs/2410.11677v1))。
|
||||||
|
|
||||||
|
### 5.11 约束模型输出(Constraining outputs)
|
||||||
|
|
||||||
|
三级递进,目的都是让输出格式可预测、简化评测:
|
||||||
|
|
||||||
|
1. **用 prompt**:task prompt 里给非常具体的指令(`Provide numerical answers in digits.`、`Use no abbreviation.`)。不一定总有效,但对高能力模型通常够用——**GAIA 论文就是这么做的**。
|
||||||
|
2. **Few-shots / in-context learning**:提供示例隐式引导模型跟随重复的 prompt 形状。**2023 年底之前整体很好用**;此后 instruction tuning 与持续预训练里的指令数据把更新模型**偏向特定输出格式**([arxiv 2407.07890](https://arxiv.org/abs/2407.07890) 称之为 *Training on the test task*,作者称之为 *overfitting the prompt format*);**reasoning 模型因 reasoning trace 与 few-shot 配合不好**;小上下文旧模型也可能塞不下示例。
|
||||||
|
3. **Structured text generation(结构化生成)**:用 grammar 或正则约束输出路径。**`outlines` 库用有限状态机(FSM)实现**(其他方法如 guidance 的 interleaved generation 用于 JSON 等特定格式)。效果:**降低评测中的 prompt variance,结果与排名更稳定**([evaluation-structured-outputs blog](https://huggingface.co/blog/evaluation-structured-outputs))。⚠️ 但近研究([arxiv 2408.02442](https://arxiv.org/abs/2408.02442))显示**结构化生成可能降低某些任务(如推理)的表现**——把先验推离了期望的概率分布。入门:⭐ [outlines 的 FSM 讲解](https://blog.dottxt.co/coalescence.html)、[方法论文](https://arxiv.org/abs/2307.09702)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## §6 FineWeb 预训练评测选型方法论(重点:全新内容)
|
||||||
|
|
||||||
|
> 来自 `picking-your-evaluation.mdx`(标题 "Picking good automatic evaluations for pretraining")。场景:**训练进行中**就想知道模型学得怎么样——这时需要的评测与"最终性能"评测性质不同:**即使模型还不好,任务也要给出好信号**。FineWeb 团队为此设计了完整方法,覆盖 9 种语言。
|
||||||
|
|
||||||
|
### 6.1 规模与多样性(185 tasks)
|
||||||
|
|
||||||
|
- 对这 9 种语言**收集并实现能找到的所有任务,共 185 个**。
|
||||||
|
- 任务选择两大目标:**评测多样性** + 每个任务提供**可靠信号(reliable signal)**。
|
||||||
|
- 多样性覆盖五类能力:
|
||||||
|
- **Reading comprehension (RC)**:理解给定上下文并作答
|
||||||
|
- **General knowledge (GK)**:无上下文的事实问答
|
||||||
|
- **Natural Language Understanding (NLU)**:理解输入语义
|
||||||
|
- **Common-sense reasoning (RES)**:需要具身知识(embodied knowledge)的简单推理
|
||||||
|
- **Generative tasks**:无多选题"辅助"时用目标语言生成文本
|
||||||
|
|
||||||
|
### 6.2 实验设置(代价与规模)
|
||||||
|
|
||||||
|
- 每种语言训练多个 **1.5B 参数模型**,用 **30B tokens**(取自 5 个最大的开放多语言 web 数据集的子集);同一超参与 tokenizer;**0-shot、无 instruction、无 system prompt**;按固定 checkpoint 间隔评测。
|
||||||
|
- 因任务实现反复迭代,总消耗 **73,000 GPU hours** 🔥;共训练 **49 个模型**,由此定义"可靠信号"。
|
||||||
|
|
||||||
|
### 6.3 可靠信号(Reliable Signal)的四个标准
|
||||||
|
|
||||||
|
原文定义:任务提供可靠信号 = 分数**高于随机基线**、**随训练推进而上升**、**跨不同 seed 低方差**、**每个训练步给出一致的模型排序**(对同规模、同超参、同数据量的模型)。
|
||||||
|
|
||||||
|
1. **单调性(Monotonicity)**:任务必须能从训练数据中学会、且学习过程可随训练逐步观察到(若随时间不提升,未来能否提升都不确定)。
|
||||||
|
- 度量:**Spearman rank correlation**(steps ↔ score)——能捕捉非线性的单调提升。
|
||||||
|
- 阈值:**平均相关性 ≥ 0.5**(跨所有模型训练 run)。
|
||||||
|
|
||||||
|
2. **低噪声(Low noise)**:区分"评测噪声"与"真实性能差异"。噪声来源:训练随机性(token 采样、数据打乱、初始化;[Madaan et al., 2024](https://arxiv.org/abs/2406.10229))。做法:在自家单语语料(未过滤 CommonCrawl)上**用不同 seed 再训 4 个模型**,然后:
|
||||||
|
- 每步(约每 1B tokens)算模型分数的标准差 → **per-step-std**;
|
||||||
|
- 对所有 per-step-std 取平均 → **avg-std**(因用的是更"脏"数据训练的模型、方差偏高,视为全架构/数据集的上界);
|
||||||
|
- **signal-to-noise ratio (SNR) = 30B tokens 时所有 run 的分数均值 ÷ avg-std**,作为任务变异性的主指标。
|
||||||
|
- 阈值:**SNR > 20**。唯一例外:**generative 任务**(SNR 通常偏低,但保留有价值——能看出模型在无选项自由生成时表现如何;多语言场景尤其重要,有些模型任务分数很高但生成任务会突然用错语言回答!)。
|
||||||
|
- 额外要求:假设模型表现跨 seed 正态分布,benchmark-run 表现至少高于随机基线 **3 个 final-stds**(形式上 `benchmark-run performance - benchmark random baseline > 3 * final-std`),即 99.85% 的 seed 分数高于随机。
|
||||||
|
|
||||||
|
3. **非随机表现(Non-Random Performance)**:很多能力训练后期才习得,**许多任务(尤其数学这类较难的)长时间停留在基线水平**——有用但不适合早期预训练评测,所以**不保留**。
|
||||||
|
- 计算:任务随机基线(多选题 = 所有样本 `sum(1/n_choices)`;生成式 = 0),任务距基线距离 = 所有模型中的最高分 − 基线。
|
||||||
|
|
||||||
|
4. **模型排序一致性(Model Ordering Consistency)**:评测的最终目的是比较模型与数据集——我们希望任务在**很少 token(30B ablation)时对数据集的排序,与训练更久(300B+)后的排序一致**,即任务对预训练未来表现有预测力。严格证明不可能,但有可测的必要条件:**大规模一致的前提是小规模一致**。
|
||||||
|
- 度量:相邻两个训练步之间模型排名的**平均 Kendall's Tau**(只取 15B tokens 之后的步——之前排序噪声太大)。高值 = 排序随训练推进保持一致。
|
||||||
|
- 无严格最小值,用来**在任务之间做比较**。
|
||||||
|
|
||||||
|
**交互式图表:好/坏信号示例**(新版 Space 特有的 d3 图,直观展示四标准的判例;图表配置还揭示了实际使用的指标名,如 `acc_norm_token`、`acc_norm_pmi`):
|
||||||
|
|
||||||
|
| 标准 | ✅ 好例子 | ❌ 坏例子 |
|
||||||
|
|---|---|---|
|
||||||
|
| Monotonicity(`acc_norm_token`) | `mlmm_hellaswag_fra_cf [fr]`(法语 HellaSwag,随 tokens 平滑上升) | `mlmm_truthfulqa_ara_cf:mc1 [ar]`(阿拉伯语 TruthfulQA,无趋势) |
|
||||||
|
| SNR(`acc_norm_token`) | `xstory_cloze_tel_cf [te]`(泰卢固语,各 seed 紧密) | `tydiqa_tel [te]`(`prefix_match`,噪声大) |
|
||||||
|
| Non-Randomness | `agieval_zho_cf` 用 `acc_norm_pmi [zh]`(中文 AGIEval,明显高于随机) | 同一任务用裸 `acc [zh]`(停留在随机水平)——同一任务换个指标信号天差地别 |
|
||||||
|
| Kendall's Tau(`acc_norm_token`) | `xcsqa_ara_cf [ar]`(阿拉伯语,排序稳定) | `thai_exams_tha_cf [th]`(泰语考试题,排序漂移) |
|
||||||
|
|
||||||
|
> 注意 `agieval_zho_cf` 一例:**同一个任务,用 `acc_pmi` 就是非随机、用裸 `acc` 就是随机表现**——这正是 §6.4 强调"指标选择决定信号"的直观证据。
|
||||||
|
|
||||||
|
### 6.4 指标选择(Metrics)
|
||||||
|
|
||||||
|
多选任务的 CF target 就是选项本身,每个选项的 token 数、字符数、无条件概率(无上下文前缀下生成该选项的概率)都不同——不归一化的话模型会偏好更少 token 的答案。考虑的 accuracy 变体:
|
||||||
|
|
||||||
|
| 指标 | 公式 |
|
||||||
|
|---|---|
|
||||||
|
| `acc` | $\underset{i}{\arg\max}\big(ln(P(a_i \mid q))\big)$ |
|
||||||
|
| `acc_char` | $\underset{i}{\arg\max}\dfrac{ln(P(a_i \mid q))}{num\_characters(a_i)}$ |
|
||||||
|
| `acc_token` | $\underset{i}{\arg\max}\dfrac{ln(P(a_i \mid q))}{num\_tokens(a_i)}$ |
|
||||||
|
| `acc_pmi` | $\underset{i}{\arg\max}ln\dfrac{P(a_i \mid q)}{P(a_i \mid u)}$,其中 $u = $ `"Answer:"` |
|
||||||
|
|
||||||
|
> 实际落地时,FineWeb 团队在 lighteval 中使用的指标名是 **`acc_norm_token`**(= 上面的 `acc_token`)与 **`acc_norm_pmi`**(= 上面的 `acc_pmi`)——交互图表配置里出现的就是这些名字,"norm" 指长度/概率归一化。
|
||||||
|
|
||||||
|
- `acc_pmi` 度量"给了问题上下文相比没有上下文,模型更可能选 $a_i$ 多少"——当正确选项含普遍罕见 token、模型天然不爱选它时有用。详见 [Gu et al., 2024](https://arxiv.org/abs/2406.08446)(OLMES)与 [Biderman et al., 2024](https://arxiv.org/abs/2405.14782)。
|
||||||
|
- 生成式任务用:**`prefix_match`**(只要求答案前缀 exact match)与 **`f1`**(用 word tokenizer 在预测/gold 词上算 F1);两者都做轻预处理:去冠词、去标点、小写化。
|
||||||
|
- 选指标本身就是难题:**没有单一指标全面胜出**,常出现"一个指标单调性更好、另一个 SNR 更高"的两难,团队只能按其他语言的既有实现来定(并承认这种手挑未必可复制)。给出建议:
|
||||||
|
|
||||||
|
➡️ **多选任务**
|
||||||
|
- **base accuracy**:适合选项细微变化的任务(如 Yes/No/Also 的 NLI 类),此时选项常各是单 token。
|
||||||
|
- **PMI**:对"难"推理与知识任务(**AGIEVAL、MMLU**)极其有效——常是唯一高于随机的指标;但**平均而言是全场最弱指标,且计算贵 2 倍** → 只在复杂推理与知识任务用。
|
||||||
|
- **长度归一化指标(token 或 character)整体最可靠**,但最优选择取决于**语言**而非任务 → **推荐取 `max(acc_char, acc_token)`** 得到最可靠结果。注意 `acc_token` 高度依赖 tokenizer(好在 ablation 中所有模型用同一 tokenizer)。
|
||||||
|
|
||||||
|
➡️ **生成式任务**
|
||||||
|
- 选择更清晰:**除非必须 exact match(如数学),建议用 F1**——F1 噪声更小、对生成的小变化更稳健。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## §7 统计有效性与成本效率("The forgotten children of evaluation")
|
||||||
|
|
||||||
|
> 新版把这两件事命名为"**评测中被遗忘的孩子**",来自 designing 章节结尾——旧版没有的独立主题。
|
||||||
|
|
||||||
|
### 统计有效性(Statistical validity)
|
||||||
|
|
||||||
|
- 报告评测结果时必须**在点估计(point estimate)之外附上置信区间(confidence intervals)**。
|
||||||
|
- 自动指标:从分数的标准差或 **bootstrapping** 得到(相对简单)。
|
||||||
|
- model judge:近期论文([arxiv 2511.21140](https://arxiv.org/pdf/2511.21140))建议用估计器做 **bias correction**。
|
||||||
|
- 人类评测:报告 **agreement**(一致性)。
|
||||||
|
- 也可用 **prompt variations** 来算:以略微不同的方式问同一问题、或对不同 prompt 格式重跑同一样本。
|
||||||
|
|
||||||
|
### 成本与效率(Cost and efficiency)
|
||||||
|
|
||||||
|
作者呼吁集体开始**按模型运行成本报告评测结果**——一个要思考 10 分钟、花 10K tokens 回答 `10 + 1` 的 reasoning 模型(还可能在二进制 vs 十进制算术上跑题),比用几十 token 答 30 道题的 smol 模型低效得多。建议报告:
|
||||||
|
|
||||||
|
- **Token 消耗**:评测所用的**输出 token 总数**——估计效率的关键,直接影响 model-as-judge 评测成本;token 数直接影响货币成本并帮他人估算算力需求。**货币成本**也是效率的良好代理。
|
||||||
|
- 成本指标在**比较评测方法**时也很关键:强 LLM judge 信号可能更好,但**相对自动指标的 100x 成本**未必值当;sampling 类指标(pass@k、maj@n)成本随样本数倍增,要与其信号增益权衡。
|
||||||
|
- **时间**:模型完成评测的推理时间(含实际推理 + API rate limit 开销)——对时间敏感应用(如 GAIA2 这类 agentic 工具使用)尤其重要。
|
||||||
|
- **环境足迹**:报告运行模型的碳排放在资源有限的当下越来越重要——含**训练碳排放与推理能耗**,取决于模型大小、硬件(若已知)与生成的 token 数。**一些更小或量化模型达到非常有意思的 performance-to-consumption 比值**。(原文在此段结束。)
|
||||||
|
|
||||||
|
> 注:`2025-evaluations-for-useful-models.mdx` 在 Recommendations 一节自然收尾,无截断;`designing-your-automatic-evaluation.mdx` 在 environmental footprint 段结束——**原文到此**。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## §8 新版结论要点(来自 article.mdx Conclusion)
|
||||||
|
|
||||||
|
> "Evaluation is both an art and a science."
|
||||||
|
|
||||||
|
作者希望读者记住五点:
|
||||||
|
|
||||||
|
1. **Think critically about what you're measuring(批判性看待你在测什么)**:评测是能力的**代理(proxy)**,benchmark 高分不保证真实世界表现;自动指标、人类 judge、model judge 各有偏差、局限与权衡。
|
||||||
|
2. **Match your evaluation to your goal(让评测匹配目标)**:训练 ablation → 快、可靠、在小模型上也有强信号的基准;最终模型选型 → 更难、未污染、测整体能力的基准;特定用例 → 建贴合你问题与数据的自定义评测。
|
||||||
|
3. **Reproducibility requires attention to detail(可复现性需要抠细节)**:prompt、tokenization、normalization、模板、随机种子的微小差异就能让分数差几分;报告结果要透明交代方法;复现别人结果时,**即使你试图控制每个变量,精确复现也极其困难**。
|
||||||
|
4. **Prefer interpretable evaluation methods(优先可解释的评测方法)**:能选时,functional testing 与 rule-based verifiers 优于 model judges;能理解、能 debug 的评测给出更清晰可操作的洞察——**评测越可解释,你越能改进模型**。
|
||||||
|
5. **Evaluation is never finished(评测永无止境)**:模型变强 → benchmark 饱和;训练数据增长 → 污染更易发生;用例演进 → 新能力需要测量。**评测是一场持续的战役。**
|
||||||
|
|
||||||
|
收尾金句:
|
||||||
|
|
||||||
|
> "The models we build are only as good as our ability to measure what matters."
|
||||||
|
> (我们构建的模型,其好坏只取决于我们测量重要之事的能力。)
|
||||||
|
|
||||||
|
致谢名单(Acknowledgments):Hynek Kydlicek、Loubna Ben Allal、Sander Land、Nathan Habib 等直接或间接贡献者。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 参考资料
|
||||||
|
|
||||||
|
**新版 Space(主入口)**
|
||||||
|
- 交互式页面:<https://huggingface.co/spaces/OpenEvals/evaluation-guidebook>
|
||||||
|
|
||||||
|
**各章节 raw 链接**(`https://huggingface.co/spaces/OpenEvals/evaluation-guidebook/raw/main/app/src/content/...`)
|
||||||
|
- 总组装(含结论、saturation/contamination 定义、数据检查清单):`article.mdx`
|
||||||
|
- Intro(评测视角、智能定义困境):`chapters/intro.mdx`
|
||||||
|
- Model inference and evaluation(MCF/CF/FG、calibration):`chapters/general-knowledge/model-inference-and-evaluation.mdx`
|
||||||
|
- 2025 evaluations for useful models(2025 评测全景):`chapters/general-knowledge/2025-evaluations-for-useful-models.mdx`
|
||||||
|
- Designing your automatic evaluation(设计自动评测):`chapters/automated-benchmarks/designing-your-automatic-evaluation.mdx`
|
||||||
|
- Picking good automatic evaluations for pretraining(FineWeb 方法论):`chapters/general-knowledge/picking-your-evaluation.mdx`
|
||||||
|
- Some evaluation datasets(数据集大表,**存在于仓库但页面正文不渲染**,仅被 2025 章节以链接引用):`chapters/automated-benchmarks/some-evaluation-datasets.mdx`
|
||||||
|
- Using human annotators(**嵌入 designing 章节内部**,位于 "Using existing data" 与 "Creating a dataset synthetically" 之间):`chapters/human-evaluation/using-human-annotators.mdx`
|
||||||
|
- Troubleshooting reproducibility:`chapters/troubleshooting/troubleshooting-reproducibility.mdx`
|
||||||
|
|
||||||
|
**本专区相关笔记**
|
||||||
|
- [[00-Overview]](旧版总览,含新版迁移说明)
|
||||||
|
- [[01-Automatic-Benchmarks]](旧版自动评测)
|
||||||
|
- [[02-Human-Evaluation]](旧版人类评测)
|
||||||
|
- [[03-LLM-as-a-Judge]](旧版 judge 大章节——新版压缩版的可对照全文)
|
||||||
|
- [[05-General-Knowledge]](旧版 tokenization/inference)
|
||||||
|
- [[06-Yearly-Dives]](旧版年度深潜)
|
||||||
|
|
||||||
|
**正文出现的关键论文/资源(按章节)**
|
||||||
|
- ImageNet 时代 benchmark 设计教训:[arxiv 2404.02112](https://arxiv.org/pdf/2404.02112)
|
||||||
|
- OLMES(PMI 推荐):[arxiv 2406.08446](https://arxiv.org/abs/2406.08446);推理方法数学形式化:[arxiv 2405.14782v2](https://arxiv.org/abs/2405.14782v2)
|
||||||
|
- MMLU 各实现差异(lm_eval/helm/作者原实现):[Open LLM Leaderboard MMLU blog](https://huggingface.co/blog/open-llm-leaderboard-mmlu)
|
||||||
|
- Training on the test task(prompt 格式过拟合):[arxiv 2407.07890](https://arxiv.org/abs/2407.07890)
|
||||||
|
- 结构化输出评测(prompt variance):[evaluation-structured-outputs blog](https://huggingface.co/blog/evaluation-structured-outputs);outlines:[arxiv 2307.09702](https://arxiv.org/abs/2307.09702)
|
||||||
|
- Math-Verify:[blog](https://huggingface.co/blog/math_verify_leaderboard)
|
||||||
|
- EpochAI benchmark 聚合(Rosetta Stone):[epoch.ai](https://epoch.ai/blog/a-rosetta-stone-for-ai-benchmarks)
|
||||||
|
- 旧数据集清单(2025 章节末尾保留链接):[GitHub evaluation-guidebook/automated-benchmarks/some-evaluation-datasets.md](https://github.com/huggingface/evaluation-guidebook/blob/main/contents/automated-benchmarks/some-evaluation-datasets.md)
|
||||||
@@ -63,3 +63,4 @@ created: 2026-08-21
|
|||||||
- 职业与岗位背景:[[02_Areas/Job/llm_data_annotation_programmer_roadmap|大模型数据标注与程序员入门]](原文存于 02_Areas/Job)
|
- 职业与岗位背景:[[02_Areas/Job/llm_data_annotation_programmer_roadmap|大模型数据标注与程序员入门]](原文存于 02_Areas/Job)
|
||||||
- 入门认知草案:[[02-Intro-Cognitive-Framework-Draft|入门认知框架(草案)]]
|
- 入门认知草案:[[02-Intro-Cognitive-Framework-Draft|入门认知框架(草案)]]
|
||||||
- 路线图重构草案:[[03-Roadmap-Refactor-Outline-Draft|实战路线图重构大纲(草案)]]
|
- 路线图重构草案:[[03-Roadmap-Refactor-Outline-Draft|实战路线图重构大纲(草案)]]
|
||||||
|
- 外部权威知识参考:[[04-Reference-Archive/evaluation-guidebook/00-Overview|HuggingFace Evaluation Guidebook 中文提炼]](自动基准 / 人工评测 / LLM-as-judge / 排错,按主题查阅)
|
||||||
|
|||||||
Reference in New Issue
Block a user