 windyboy
f375cd6134
- Add 9 Chinese distilled notes under 04-Reference-Archive/evaluation-guidebook/
  covering automated benchmarks, human evaluation, LLM-as-a-judge,
  troubleshooting, general knowledge, yearly dives, resources, and the
  2025 HF Space edition (FineWeb eval-selection methodology, MCF/CF/FG,
  sampling metrics, Math-Verify, statistical validity & cost)
- Update zone README and Material-List with entry links
68 KiB
type, tags, status, created, source
| type | tags | status | created | source | |||
|---|---|---|---|---|---|---|---|
| reference |
|
active | 2026-08-21 | https://github.com/huggingface/evaluation-guidebook |
自动基准评测(Automated Benchmarks)— LLM Evaluation Guidebook 提炼笔记
来源:HuggingFace evaluation-guidebook 的
contents/automated-benchmarks/章节,包含四篇: basics(自动化基准是什么)、designing-your-automatic-evaluation(如何设计自己的自动评测)、some-evaluation-datasets(常用评测数据集盘点)、tips-and-tricks(实战技巧)。性质:中文提炼式笔记,非逐字翻译;关键英文术语保留原文。文内 ⭐ 标记的链接是作者特别推荐阅读的资源(同 00-Overview 的约定)。
关联笔记:02-Human-Evaluation(人工评测)、03-LLM-as-a-Judge(模型作评委)、04-Troubleshooting(排错与可复现性)。
目录
速览(TL;DR)
| 问题 | 一句话答案(详见对应章节) |
|---|---|
| 自动基准评测是什么? | 用「数据集(输入+gold 参考)+ metric」给模型在 task / capability 上打分;LLM 输出分两类:生成文本(generative)与序列 log-probability(MCQA / perplexity)。(§1) |
| 为什么要测模型没见过的数据? | 测的是泛化(generalization);在训练数据上评测等于给模型不具备的能力打分(overfitting 的学生类比)。(§1) |
| 自动化基准有什么优势? | 一致可复现、成本低、指标可理解、可用专家级高质量数据(但 MMLU 也有错 → MMLU-Pro/Redux)。(§2) |
| 有什么短板? | 复杂能力难分解成精确任务(转向 generalist 评测、性能当 proxy);公开数据集必有 contamination。(§2) |
| 评测结果好坏取决于什么? | 取决于评测数据集质量——选数据集要看创建者、标注者一致性、指南、随机抽 50 个样本检查;自建可走聚合/人工标注/合成(LLM 或规则)三条路。(§3.1) |
| 用 log-prob 还是生成式? | 多选题/测知识 → log-prob(快、能给置信度,但高估小模型、对选项顺序敏感);测流利度/推理 → 生成式(更贴近真实关注点,但难打分、更贵)。(§3.2) |
| prompt 要注意什么? | 语义等价的微小改动会让结果波动;模型会过拟合 prompt 格式(Llama 3.2 / Qwen 2.5 在 few-shot 里不跟格式);必要时约束输出。(§3.3) |
| 代码评测的聪明做法? | 功能测试:用单元测试验证生成程序(降低过拟合、测主动能力);文本版代表是 IFEval。(§3.5) |
| 数据污染怎么办? | 默认「已污染」;用 canary string、加密/门控发布、动态 benchmark、事后检测(无万全之法)。(§5.1) |
| 评测结果意外差? | 先看生成结果:解析太严、few-shot 不跟格式、模型太啰嗦,逐一排查。(§5.3) |
1. 核心概念:task / capability / dataset / metric / 样本 / 泛化
自动化基准(automated benchmark)通常这样工作:你希望知道模型在某件事上表现如何。这件事可以是:
- 一个定义清晰的具体任务(task),例如「我的模型能不能区分垃圾邮件与非垃圾邮件(spam / non-spam classification)?」;
- 一个更抽象、更一般的能力(capability),例如「我的模型数学能力如何(How good is my model at math)?」。
评测的三要素
- 数据集(dataset),由**样本(samples)**组成:
- 每个样本包含给模型的输入(input),有时配一个用来比对输出的参考答案(reference,也称 gold);
- 样本通常刻意设计成贴近你要测的东西:例如做邮件分类,就构造一批垃圾/非垃圾邮件数据集,尽量包含一些难的边界案例(edge cases)。
- 度量(metric):给模型打分的方式。
- 示例:垃圾邮件分类的准确率(正确分类的样本记 1 分,错误记 0 分);
- metric 利用模型输出打分。对 LLM 而言,人们主要考虑两类输出:
- 模型根据输入生成的文本(generative evaluation,生成式评测);
- 提供给模型的一个或多个序列的 log-probability(multiple-choice evaluations,简称 MCQA;或 perplexity evaluations,困惑度评测)。
- 更多细节见 Model inference and evaluation 页面。
泛化(generalization)与过拟合(overfitting)
- 评测最好在模型从未见过的数据(不在其训练集里的数据)上进行,因为你测的是它能否泛化(generalize)——例如:模型只见过「假银行」类垃圾邮件后,能否正确分类「保健品」类垃圾邮件。
- overfitting:模型只能在训练数据上预测得好、没有学到更高级的通用模式,就称其过拟合。这就像学生把考题背下来却没理解知识点——在训练集中已经出现过的数据上评测 LLM,等于给它不会的能力打分。
2. 自动化基准的优缺点
优点
| 优点 | 说明 |
|---|---|
| 一致性与可复现性(Consistency and reproducibility) | 同一 benchmark 在同一个模型上跑 10 次结果相同(除硬件差异或模型固有随机性外)。因此可以方便地为给定任务建立公平的模型排名。 |
| 低成本规模化(Scale at limited cost) | 目前最廉价的评测模型方式之一。 |
| 可理解性(Understandability) | 大多数自动化指标非常易懂:exact match 告诉你生成文本是否与参考完全一致;accuracy 告诉你选对选项的次数占比。(相比而言 BLEU、ROUGE 这类指标就没那么直观。) |
| 数据集质量(Dataset quality) | 不少 benchmark 使用专家生成的数据集或已有的高质量数据(如 MMLU、MATH)。但高质量 ≠ 完美:MMLU 事后被发现样本中有若干错误(从解析问题到实际上无意义的问题),催生了 MMLU-Pro、MMLU-Redux 等后续数据集。 |
局限
- 对复杂任务的使用受限:自动化基准擅长性能容易定义和评估的任务(如分类)。更复杂的能力很难分解成定义清晰、精确的子任务。
- 例如「数学好」到底指什么?算术好?逻辑好?能对新数学概念推理?
- 这催生了更多通用型(generalist)评测:不再把能力拆成子任务,而是假设整体表现是所测目标的良好代理指标(good proxy)。
- 污染(Contamination):数据集一旦以纯文本形式公开,就会进到模型训练数据里。因此打分时你无法保证模型没解析过评测数据。
3. 如何设计自己的自动评测
核心原则:你的评测结果只会和你的评测数据集一样好(your evaluation result will only be as good as your evaluation dataset)。
设计自动评测的完整流程(对照清单)
把原文的设计建议串成一条可执行的流程,每个步骤的细节见对应小节:
- 明确要测什么:具体 task(如垃圾邮件分类)还是抽象 capability(如数学能力)?(§1)
- 选或建数据集:优先复用已有高质量数据集;自建可走聚合现有数据 / 人工标注 / 合成数据(LLM 生成或基于规则)。(§3.1)
- 检查样本:已有数据集看创建者与标注流程(专家 > 付费 ≈ 众包 > MTurk)、标注者一致性、创建指南;随机抽 50 个样本查质量与相关性;样本数 ≥ 100 才统计显著。(§3.1)
- 选推理方法:MCQA(log-probabilities)还是生成式(generative)?(§3.2)
- 设计 prompt:task prompt / context / question / options / connector words;注意 prompt 敏感性、few-shot、格式过拟合。(§3.3)
- 选 metric:log-prob 侧用按长度归一化的 accuracy / perplexity / recall / f1;生成侧先决定是否归一化、再决定匹配方式(exact match、ROUGE、BLEU…);想清楚任务到底关心平均还是最差表现。(§3.4)
- 跑评测 + 复盘:检查生成结果(解析、格式遵循、长度),关注 contamination 与 tokenization 坑。(§5)
3.1 选择数据集
要么选已有数据集(见 第 4 节),要么自己设计。过程中必须紧盯上面这条原则。
选用已有数据集:必须检查的组件
(1)创建过程(Creation process)
- 样本是谁创建的? 作者给出的质量排序(作者观点):
专家创建(expert created)> 付费标注者(paid annotator)≈ 众包(crowdsourced)> MTurk 标注
- 找数据卡(data card),看标注者人口学信息(annotator demographics)——对理解数据集的语言多样性很重要。
- 样本是否被其他标注者或作者复核过? 要确认:标注者间一致性分数(inter-annotator score)是否高(标注者是否达成共识)、以及/或作者是否审查过整个数据集。
- 这对「用低薪标注者(通常不是你目标语言的母语者,如 AWS Mechanical Turk)」的数据集尤其重要,否则你可能发现拼写错误/语法错误/无意义答案。
- 标注者是否拿到清晰的数据创建指南(data creation guidelines)? 换句话说:你的数据集一致吗?
(2)样本(Samples)
取 50 个随机样本人工检查:
- 质量(quality):
- prompt 是否清晰无歧义?
- 答案是否正确?(例:TriviaQA 每个问题有多个 gold 答案(aliases 字段),有时互相冲突。)
- 信息是否缺失?(例:MMLU 的不少问题缺少参考示意图(reference schematics)。)
- 与任务的相关性(relevance):
- 这些是你想用 LLM 评测的问题类型吗?
- 这些例子与你的 use case 相关吗?
还要知道数据集有多少样本(保证结果统计显著——自动基准评测通常最少 100 个样本)。
设计自己的数据集:三条路线
| 路线 | 要点 |
|---|---|
| 聚合现有数据(Aggregating existing data) | 从不同来源聚合现有数据,评估与任务相关的能力。很多评测数据集就是这样从人工评测数据集聚合而来的(如 MATH、LSAT 等)。走这条路同样要执行上面「检查样本」的步骤。 |
| 使用人工标注者(Using human annotators) | 完整章节见 Using human annotators(人工评测章节)。 |
| 使用合成数据(Using synthetic data) | 分两种: |
| ├ 用 LLM 生成 | ⭐ 参考 Cosmopedia 博客(HF 同事写的,很酷):主要研究如何造合成训练集,但类似技术可用于评测。生成后务必按上面的步骤人工检查/过滤/审查。 |
| └ 基于规则的技巧(rule-based) | 如果任务允许,这是获得几乎无限样本且避免污染的好办法。示例:NPHardEval、DyVal、MuSR、BabiQA 等。 |
3.2 选择推理方法(inference method)
基于 log-probabilities(MCQA 多选题)
非常适合选择题(通常测模型知识、或消歧能力)。
| 优点 | 缺点 |
|---|---|
| 确保所有模型都能「看到」正确答案 | 轻微高估小模型(若放任自由生成,它们本会生成选项范围之外的内容) |
| 提供模型「置信度」(calibration)的代理 | 有些模型会根据选项的呈现顺序偏好特定选项,导致评测不具代表性 |
| 评估快——尤其只让模型预测一个 token(A/B/C/D 选项序号,或 Yes/No)时 | |
| 小模型也能获得任务表现信号 |
基于生成(generative / QA 问答)
适合任何要测流利度(fluency)、推理能力、或模型真正回答问题的能力的任务。
| 优点 | 缺点 |
|---|---|
| 应该与 LLM 生成流利文本的能力真实相关,多数时候正是人们真正关心的 | 打分更难(见 3.4 metrics 一节) |
| 通常比 log-likelihood 评测贵一点,尤其包含 sampling 时 |
3.3 选择提示词(prompt)
prompt 决定:给模型多少任务信息、这些信息如何呈现。
一个通用 MCQA / QA prompt 通常由以下部分构成:
- task prompt(可选):介绍你的任务;
- context:为问题提供额外上下文(例:摘要或信息抽取任务可提供内容来源);
- question:prompt 的核心;
- options(多选题时):选项;
- 连接词(connector words):如
Question、Context、Choice等。
把这些要素拼成模板(示意,字段顺序与措辞可自行设计):
Task: {task prompt}            # 可选:介绍任务
Context: {context}             # 可选:为问题提供额外上下文(摘要/信息抽取时可给内容来源)
Question: {question}           # 核心
Choice A: {option_a}           # 多选题时提供选项
Choice B: {option_b}
Choice C: {option_c}
Answer:                        # 用连接词引导模型输出
注意:上面只是结构示意,原文没有给出固定模板——不同模型对格式的敏感度不同,实际使用时按 3.3 的提示设计并验证。
设计 prompt 时要注意:
- 语义等价的微小改动也可能让结果波动很大(见 Troubleshooting reproducibility 的「Different prompt」一节),且 prompt 格式可能利好或利空特定模型。
- 缓解方法:
- 昂贵方案:用多种 prompt 变体把评测多跑几遍;
- 省钱方案:只跑一次,但把一批难度相当的不同 prompt 格式分配到不同样本上。
- 缓解方法:
- 可以给模型提供few-shot 示例帮它遵守期望格式;加连接词也有帮助。
- 但模型如今倾向于过拟合特定 prompt 格式:
- ⭐ 这篇论文 讲得很好:有些模型因为过拟合了测试集的**格式(format)**而被高估。
- 在 Open LLM Leaderboard 2 上,作者观察到 Llama 3.2 和 Qwen 2.5 出于这个原因,在 few-shot 设置下不再遵循给定 prompt 的格式。
- 对不少 metric 来说,你需要高度受约束的生成/输出(详见 Model inference and evaluation 的
Constraining model outputs一节)。
3.4 选择度量(metric)
基于 log-probabilities 时,metric 很简单:看 accuracy(最可能的选项是最佳选项的频率)。重要:要按长度归一化(按字符 character、token、或 pmi)。也可以看 perplexity、recall、f1。
生成式评测(generative) 时可选 metric 范围更广,需要两步决策:
- 比较生成结果前是否先归一化(normalize)?
- 归一化设计得不好时很容易不公平,但总体上在任务层面仍提供信号;
- 对特定任务非常重要,如数学评测:你可能要从格式化输出中抽取结果;
- 如果要叠加 Chain of Thought 等机制测准确率,也要归一化——你需要把推理痕迹(reasoning trace)从实际结果中剥离。
- 如何把生成与参考做比较?
- 从基于匹配的 metric(exact match、prefix match 等)到摘要/翻译类 metric(ROUGE、BLEU、character n-gram 比较)都可以;
- 现有 metric 列表见 ⭐ lighteval 的 Metric List wiki(作者表示之后会补「何时用哪个 metric」一节)。
更一般的原则:选 metric 时要想清楚任务真正关心什么。有些领域(如医疗、有公共交互的聊天机器人)不该测平均表现,而要能评估最差表现(worst performance)——如医疗输出质量、毒性等。(延伸阅读:⭐ 这个博客)
3.5 智能新任务:功能测试(functional testing)
代码领域:不仅要按语义评估生成的程序,还要按实际功能评估。好办法是检查「为遵循 prompt 而生成的代码」能否通过一套为该任务设计的单元测试(unit tests)。
功能化方法极具前景,因为:
- 更容易生成测试用例(很多情况下可用基于规则的方法生成 test cases);
- 因此降低过拟合(overfitting);
- 测的是模型的具体主动能力(active capabilities)。
不过,要把这种方法迁移到文本任务需要创造力!
- 一个优秀范例是 IFEval:测试模型能否遵循指令的评测 benchmark。它创建一批格式化指令(Add this number of bullet points.、Capitalize only one sentence. 等),严格检查格式是否被遵循。
- 作者认为:要把这个思路扩展到文本的其他特性,还需要更多工作。
4. 常用评测数据集盘点
如果你关心的任务已被充分研究,大概率已有现成数据集。下面是作者近几年整理的评测数据集清单。
⚠️ 两点提醒:
- 部分数据集可能已过时:它们是 pre-LLM 时代设计的,如今已被轻松解决;当初旨在探究文本的某一具体属性(翻译、摘要),已不再是现在的评测方式(评测如今更通用/整体化)。
- 它们很可能已被污染:已在网上公开多年。但被污染不代表对你的任务没有信号。
注:原文标注「✍️」的是作者提出、可自行复现的数据集想法(见 4.3)。部分行原文信息为空,笔记中保留名称并注明「原文未提供细节」。
如何从盘点表中选数据集(作者备注提炼)
表格的「备注」列里藏着作者的选数据集经验,常用判断依据有:
- 看创建者与标注流程:专家标注(如 FinQA 的付费专家+外部专家高一致)通常质量更高;自动抽取比例高、人工验证少的数据集要警惕(如 Dolphin18K、Math23K)。
- 看模板化程度:模板化/可再生成的数据集对研究 contamination 特别有用(Ape210K 部分模板化、Draw-1K 每题带模板标签、GSM-Symbolic、NPHardEval、DeepMind Math 可再生成)。
- 看是否附带训练集:凡提供额外 train set 或「本意部分用于训练」的(Ape210K、AQuA、DocMath-Eval、DeepMind Math、NuminaMATH),若拿去当训练数据会反向污染主流数学 benchmark(NuminaMATH 的备注直接警告了这一点)。
- 看答案形式是否可自动验证:整数(AIME、GSM8K)、SymPy 对象(FrontierMath、OlympiadBench)、单元测试(HumanEval、APPS)——答案可自动验证是生成式评测能跑起来的关键。
- 看语言/时区属性:中文题(Ape210K、GAOKAO-Bench、HMWP、Math23K)、多语言(MLSum、TyDiQA-GoldP)、是否每年更新(GAOKAO-Bench)。
- 看是否有领域专家背书:FrontierMath(60 位数学家、全部同行评审)被作者评为「目前可能质量最高」;GAOKAO-Bench 的论文「数据集信息意外地少」。
4.1 数学类数据集(Math specific)
| 名称 | 类型 | 年份 | 规模 | 内容/备注 | 链接 |
|---|---|---|---|---|---|
| AGIEval (SATMath) | 考试题+现有数据集 | 2023 | 220 | SAT 数学题。论文实为一系列人类考试数据集汇编:数学部分经 MATH 用了 AIME & AMC,经 AQuA-Rat 用了 GRE & GMAT,另有 GaoKao。Metric:acc/em/f1 | Paper / HF |
| AIME (all) | 奥赛题 | 1983–今 | 每年 15×2 | 需要算术、代数、计数、几何、数论、概率等中学数学综合的问题。美国 IMO 代表队选拔第 2 场考试。答案恒为 0–999 的整数 | Blog / Source |
| AIME (22/23/24) | 奥赛题 | 2024 | 90 | 同 AIME (all),用于 AIMO 竞赛 | HF |
| ALGES (SingleEQ) | 网络来源汇编 | 2015 | 508 | 从网络抓取的年级代数题。论文主题:隐式学习并求解题目背后的简单方程。来源:math-aids.com、k5learning.com、ixl.com。pre-LLM 论文,数据源可能没问题 | Paper / Source |
| ALG514 / AllEq | 网络论坛 | 2014 | 514 | 从众包辅导网站抽取、turking 清理、人工核验的代数应用题。论文主题:从问题中抽取方程模板来求解。来源:Algebra.com | Paper / Source |
| AMC 12 | 奥赛题 | 2000–今 | 每年 25 | 应用题(算术、代数、计数、几何、数论、概率等)。美国 IMO 选拔第 1 场考试(前身 American High School Math Exam)。题目设计为无需微积分背景即可解 | Blog / Source |
| Ape210K | 考试题 | 2020 | 21 万题 / 5.6 万模板 | 中文小学数学应用题(数学教师编写)。部分题目模板化(对 contamination 研究有用);原始 90 万经人工筛选;提供「中间方程」(测 CoT trace 有用);本意部分用于训练 | Paper(已撤回,v1 仍可访问)/ HF |
| AQuA / AQUA-Rat | 考试题+turk 数据集 | 2017 | 100K | 以 3.4 万 GMAT/GRE 题为种子、turking 扩展的代数应用题。含 rationale;评分用 accuracy、BLEU、perplexity;本意部分用于训练 | Paper / HF |
| ASDiv-A | 网络来源汇编 | 2020 | 2.3K | 从各网站收集并规范化的应用题。硕士生标注问题类型与年级;强调词汇多样性;用了 28 个网站 | Paper / Github |
| CHAMP | 奥赛题 | 2024 | 270 | 从奥赛例题书抽取、改写为可解析解并标注的应用题。题目带 hints 与概念标签,可做消融实验。来源:《Problem-Solving strategies》(Engel, 2008) | Paper |
| DeepMind Math | 考试题+合成 | 2019 | 10K? | 代数、算术、微积分、比较、单位换算、多项式、概率等合成数学题。领域完整列表在附录 B;提供生成代码可产出更多样例;提供额外训练集;程序化合成 | Paper / HF |
| DocMath-Eval | 人工标注财报+现有金融数学集 | 2023 | 3.2K | 结合财报与现有数据集,标注者读材料出题(或校验),答案以 Python 程序给出、由领域专家评估。复用 TAT-QA、FinQA、MultiHiertt、TAT-HQA;金融数学数据质量看起来很高;提供额外训练集 | Paper / Github |
| Dolphin1878 | 网络来源汇编 | 2015 | 1.5K | 从在线来源抽样、必要时重新标注的数字应用题。论文主题:用语义解析从问题中提取 DOL 方程树。来源:algebra.com、answers.yahoo.com | Paper |
| Dolphin18K | 网络来源汇编 | 2016 | 18K | 半自动从在线来源抽取的应用题。来源:Yahoo Answers 数学分类(2008 起)。先人工标注 6K 再用分类器扩展;自动抽取比例高、人工验证少,作者对质量存疑 | Paper / Kaggle |
| Draw-1K | 网络来源汇编 | 2016 | 1K | 从在线来源抽取的通用代数应用题。论文主题:评估求解器、测试模板与方程等价。每题标注其模板(对 contamination 有用)。来源:algebra.com | Paper / Source |
| FinQA | 专家标注财报 | 2021 | 1.1K | 与财报表格关联的金融问题;标注者给出问题+逐步过程+每页注解。付费专家标注+外部专家一致性高,质量可能很高;全集 8.2K;数据源 S&P 500 财报(1999–2019) | Paper / HF |
| FrontierMath | 专家创建 | 2024 | 100+(确切数字未知) | 全新建、覆盖多数数学领域的难题;答案要么是整数要么是 SymPy 对象,可通过类单元测试的 Python 程序自动验证;题目带标签。60 位数学家、12 个国家;全部同行评审;论文有很好的 contamination 讨论;目前可能是质量最高的数据集。数据不公开——但闭源模型已被评测过,未来很可能被污染 | Paper(数据私有) |
| GAOKAO-Bench (MathCloze, MathQA) | 考试题 | 2023 | ~500 | 中国高考数学应用题。公式转 latex;中文;每年更新;论文探索多种评分方式(含 LLM as judge);论文里数据集信息意外地少 | Paper / Github / HF MathCloze / HF MathQA |
| GAOKAO 2023 (MathEn) | 考试/竞赛题 | 2023 | 385 | 高中数学应用题。汇编 2023 中国高考、2023 AMC、2023 ACT | HF |
| GSM1K | 按另一数据集风格手工创建 | 2024 | 1.2K | 多样化的「grade school」风格应用题,遵循 GSM8K 的求解分布。论文做 GSM8K vs GSM1K 的 contamination 分析;并暗示 perplexity 分析不太擅长检测 contamination | Paper(数据私有) |
| GSM8K | 按考试风格手工创建 | 2021 | 8.5K | 多样化年级数学应用题。加外部计算器效果最好;答案均为正整数,50% 在 0–8 之间;先用 Upwork 标 1K、后用 Scale;出题者拿到 175B GPT-3 的种子题 | Paper / Github / HF |
| iGSM (med/hard) | 合成 | 2024 | 20K | 用「对象/类别间依赖图(直接/隐式)+ 运算次数」组合生成题目。想法理论上不错但问题很不真实(运算次数过多);论文聚焦模型「心智过程」,拟人化过重;probing 部分不错 | Paper / HF |
| GSMHard | 现有数据集改编(换数字) | 2022 | 8.5K | GSM8K 换更大/更少见数字以变难;但替换由程序自动完成,只人工检查了 25 处变更(另 50 例手工做)。想法不错但质量存疑(附录 H1) | Paper / HF |
| GSM-IC | 现有数据集扰动 | 2023 | 58K | GSM8K 抽 100 题加无关上下文(模板化无关句 + 角色/数字填充)。测 LLM 在数学推理时对无关上下文的敏感度 | Paper / HF |
| GSM-Plus | 现有数据集扰动 | 2024 | 10K | GSM8K 每题 8 种变体,GPT-4 生成、人工标注(校验交叉标注一致性)。变体:换数字、换运算、换问题、加干扰项等——作者认为这套变更类型学不错、可扩展 | Paper / HF |
| GSM-Symbolic | 现有数据集模板化 | 2024 | 8.5K | GSM8K 模板化,可随时生成新评测、分析 GSM8K 上的 contamination。含子集(M1/P1/P2 难度等级、NoOp 加看似相关实则无关信息),部分实验用 few-shot;作者认为缺少子集说明表 | Paper(待发布) |
| Hungarian HighSchool Finals | 考试题 | 2023 | 33 | 2023 匈牙利高中数学会考题目。目前需手工评分 | Source / HF |
| HMWP | 考试题 | 2020 | 5.4K | 中国 K-12 题库标注的应用题。提出统一表示 MWP 方程的形式体系;中文 | Paper / HF |
| Math23K | 网络来源汇编 | 2017 | 23K | 自动抽取的小学数学应用题。中文;来自在线教育网站;基于规则抽取,人工校验程度不明 | Paper / HF |
| Math401-LLM | 合成 | 2023 | 401 | 加/减/乘/幂/对数等算术表达式。论文想测严格算术能力;模型目前对 log/trig 或大数表现不佳 | Paper / Github |
| MATH | 奥赛题 | 2021 | 12.5K | 真实竞赛题(自然语言+latex),带难度标注。来源 AMC 10/12、AOME 等;另引入从 Khan Academy 与 AMPS 抓取的训练集 | Paper / HF |
| MathOdyssey | — | — | — | 原文未提供细节 | — |
| MathQA | 现有数据集改编+标注 | 2019 | 37K | 对 AQuA 中可解题目加形式化标注程序(人工标注并测一致性)。提出数学问题表示语言并应用于 AQuA | Paper / HF |
| MAWPS | 现有数据集汇编 | 2016 | 3.3K | 来自现有数据集的应用题。提出创建新数学题的框架,注意去除词法/模板重叠;来源 ALG514、ALGES 等 pre-LLM 数据集 | Paper / Github |
| MiniF2F | 奥赛题 | 2022 | 244 | 奥赛应用题,尽可能用定理证明器形式化(Lean、Metamath、Isabelle)。测数学证明求解器的形式逻辑推理;来源 AIME、AMC、IMO | Paper / HF |
| NPHardEval | 合成 | 2023 | 900 | 由合成图/线性数据构造、难度各异的问题。类型:排序数组搜索、编辑距离、最短路、旅行商、图着色、背包、会议调度;可按需重新生成 | Paper / Github |
| NuminaMATH CoT | 现有数据集汇编 | 2024 | 860K | K-12 + 奥赛级应用题(组合现有数据集)。来源 AOPS、AMC、AIME、CN-K12、GSM8K、MATH、ORCA_math、合成 AMC/MATH 等。⚠️ 若当训练集会污染所有主流数学 benchmark | HF |
| NuminaMATH TiR | 现有数据集汇编 | 2024 | 72K | NuminaMATH CoT 中可用工具集成推理(tool integrated reasoning)解决的子集。同样 ⚠️ 当训练集有污染风险 | HF |
| OmniMath | 奥赛题 | 2024 | 2.2K | 从论坛/奥赛网站抽取(规则+LLM 改写)、人工标注验证的奥赛题。来源 IMO、IMC、AoPS 论坛与 wiki;领域标注用 LLM;配套训练了 judge 评估自由形式答案 | Paper / HF |
| OlympiadBench | 奥赛题 | 2024 | 8.4K | 奥赛/数学/物理应用题;答案自动评估(数字或方程,用 SymPy)。来源全球数学/物理奥赛、中国地区/国家级数学竞赛、高考模拟;含物理子集;支持 VLM 评测 | Paper |
| OlympicArena | 奥赛题 | 2024 | 11K | 原文未提供内容细节 | Paper |
| PRM800K | 合成 | 2023 | 800K | 标注者对模型生成的 80 万解做的偏好数据。论文提出 process supervision 改进 reward model(对比 output vs process supervision)。更多是训练集而非评测集 | Paper / HF |
| SVAMP | 现有数据集改编 | 2021 | 1K | 专家对 ASDiv-A 做变体生成、不超过四年级的单未知数算术应用题。变体:同对象不同结构、两者皆变、加相关/无关信息、改信息、反转运算、改句子/对象顺序 | Paper / Github |
| TabMWP | 在线来源改编 | 2022 | 38K | 需多跳推理的表格应用题,抽取自在线教育网站并人工标注。来源 IXL;表格以图片、半结构化文本、表格三种形式提供;答案可为生成式或 MCQA;经过 turker 测试 | Paper / HF |
| TAL-SCQ5K-En | 竞赛题 | 2023 | 4K | MCQA 形式应用题,数学表达式为 latex。含中英文;另有 6K 训练样本和 CoT | HF |
| TemplateGSM | LLM 生成 | 2024 | 7M | GPT-4 按 GSM8K 形态生成的数学应用题(改参数)。用 GPT-4 生成 meta-template,验证器确保可用。全部 LLM 生成,作者期待更强的质量证明 | Paper / HF |
| TheoremQA | 在线来源改编 | 2023 | 800 | 大学级别定理的 QA。流程:GPT-4 枚举相关领域子领域 → 定理候选列表 → 领域专家核实 → 网上找相关 QA | Paper / HF |
4.2 Pre-LLM 数据集
多为翻译、摘要、推理、常识等「单属性」任务,现已较易解决;不少已被污染,但可能仍有信号。
| 名称 | 任务类型 | 数据规模/内容 | 任务 | 备注 | 链接 |
|---|---|---|---|---|---|
| DeepFix | Code task, Code-to-code, 纠错 | 7K 学生写的错误 C 程序 | 修正 C 程序 | Paper | |
| MLSum | 生成、多语言、摘要 | 1.5M 新闻摘要/文章对(DailyMail、Le Monde、Süddeutsche Zeitung、El Pais、Moskovskij Komsomolets、Internet Haber;en/fr/de/es/ru/tur) | 摘要 | Palm:加 prompt 前缀、文章截断到 2048 token | Paper / HF |
| TransCoder | Code task, Code-to-code | 852 个 Python/Java/C++ 并行函数 | 语言间翻译 | Paper / Github | |
| WMT | 多语言、翻译 | WMT 会议翻译数据集(因年份而异) | 翻译 | 网址中的 2 位数替换为年份 | Conference |
| Adversarial NLI | 语言推理 | 10K entailment 数据集,human-in-the-loop 对抗攻击生成(找迫使模型预测错误标签的谓词);上下文来自 StoryCloze、CommonCrawl、Wikipedia、Open Annotated National Corpus、WikiHow、GLUE | 预测 entailment | R1–R3 为数据生成轮次 | Paper / Data / Github |
| APPS | Text-to-code | 10K 自然语言 Python 编程题(抓自 leetcode 类网站),带测试套件 | 解 Python 题 | Paper / Github / Data | |
| AQuA | 算术、推理 | 100K 多选题(GMAT、GRE 等),含 question/options/rationale | 选正确答案 | 加外部计算器效果最好 | Paper / Github |
| ARC | 常识、推理 | 8K 小学科学题:e = easy set, c = challenge set | 选正确答案 | ⚠️ 是 AI2 Reasoning Challenge,不是 Abstraction and Reasoning Corpus | Paper / Data |
| bAbI | 推理 | 20 个任务各 2K 自动生成的问题+短场景(模拟文本冒险游戏生成连续动作) | 对句子推理选正确结论 | 第 4 部分描述模拟环境与约束,很有趣;不难复现到其他推理类型 | Paper / Github / Data |
| BBQ | 偏见检测 | 58K 样本:两种上下文(模糊/明确偏见)+ 两个问题(负面/非负面)+ 候选答案;手工模板+众包校验 | 预测正确、无偏见的答案;不同上下文/问题下准确率之差构成 bias score | Paper / Github | |
| BLiMP | 语言理解 | 67 个数据集各 1K 人工生成的最小对(minimal pairs),测句法/形态/语义知识;MTurk 校验 | 看模型赋予正确句子的 log-probability 是否更高 | 测:anaphor agreement、argument structure、binding、control/raising、determiner-noun agreement、ellipsis、filler-gap、irregular forms、island effects、NPI licensing、quantifiers、subject-verb agreement | Paper / Github |
| BOLD | 生成、毒性检测 | 23K prompts(取自 Wikipedia 句子开头,含种族/宗教/政治/性别/职业群体成员) | 续写句子,用一系列指标评毒性(情感分析、分类器;HELM 用 Perspective API) | Paper / Github | |
| BooksCorpus | N/A | 11K 本 2 万+ 词的未出版书(16 种体裁,抓自网络) | 原论文用于训练句嵌入模型;模型论文常用于 contamination 或 perplexity 评测 | Paper / HF | |
| BooksCorpus_HELM | 生成、记忆 | 从 BooksCorpus 随机抽 1K 本书 | 从段落开头随机 token 数续写,测精确/近似复现 | Paper / Data | |
| BoolQ | 语言推理/理解 | 16K 自然发生的 Yes/No QA(问题+Wikipedia 上下文) | 回答 MCQA | Paper / Website | |
| CB | 语言理解 | 1.2K 语篇(WSJ 新闻、BNC 小说、Switchboard 对话),含上下文+目标句 | 预测 commitment entailment | Paper / Website | |
| Civil comments | 毒性检测 | 1.8M 在线评论,众包标注(按 Perspective API 指南);其中 450K 标注了身份词 | 毒性预测;标签用于发现模型偏见 | 原论文含合成测试集(77K,模板生成,50 个身份词,50/50 毒性)与人工标注集 | Paper / Kaggle / HF |
| Clean E2E NLG | 描述、生成 | 50K 众包生成的餐厅描述(给定 key-value,如食物类型、预算) | 生成描述 | Paper / HF | |
| CNN/DailyMail | Cloze/完成、摘要 | 原始:20 万新文档(CNN/DailyMail,2007–2015)转 Cloze 格式(去掉命名实体作 key) | HELM:用完整文档做摘要、highlights 作 gold | 作者怀疑生成不了很好的摘要 | Paper / HF / Data |
| CommonsenseQA | 常识、推理 | 12K turked QA(从 ConceptNet 关联初始化),质量过滤+Google 搜索上下文 | 回答 MCQA | 部分文本可能与 CC 数据重叠 | Paper |
| Contrast Sets | 生成、鲁棒性 | 10 个对比集(最多 1K 例),由(通常是原论文的)研究者构造(加推理步骤、词换反义、改数字等) | 用新样本跑原任务,看性能是否下降;HELM 用 IMDb 与 DROP 对比集 | 涉及 NLVR2、IMDb、MATRES、UD parsing、PERSPECTRUM、DROP、Quoref、ROPES、BoolQ、MC-TACO;构造细节在附录 | Paper / Data |
| COPA | 常识、语言理解 | 1K 前提+因果问题(带备选) | 常识选择 | Paper / Website | |
| CoQA | 上下文阅读理解 | 127K 对话式 QA(需给 rationale),标注者编写 | 对话式问答 | Paper / Data | |
| DataImputation | 现实任务、推理、结构化数据 | 8 个来源的结构化数据集 | 从带空缺属性的行补全空缺(如从电话号码推城市、从规格推手机品牌) | 表 2 有全部来源;HELM 用 Buy 与 Restaurant 子集,转自然语言测准确率 | Paper / Data restaurant / Data Buy |
| Digits arithmetics (2D+, 2D-, 3D+, …) | 算术 | n 位加减法、复合运算,各 2K 例 | 解题 | 链接来自 lm-evaluation-harness 的 lm_eval/datasets/arithmetic | Paper / Github |
| DROP | 算术、上下文阅读理解 | 55K 对抗性问题:需 1) 从文本中选相关项 2) 对其计算(排序/计数等) | 选与算 | Paper / Data | |
| Dyck language_HELM | 符号操作 | 500 个 D_n 词(52–100 字符的嵌套括号),去掉最后 i 个字符 | 预测唯一闭括号序列 | BigBench 有另一版本 | Paper / Github |
| HellaSwag | Cloze/完成 | 60K 对抗过滤的多选题 | 选正确的下一句(来自 caption 或 WikiHow) | Paper / Github | |
| HumanEval | Code task, Text-to-code | 164 个手写编程题(函数签名+docstring+函数体+单元测试) | 补全函数以通过单元测试 | Paper / HF | |
| IMDB | 情感分析 | 50K IMDB 评论,正(≥7)负(≤4)各半,无中性 | 正/负分类 | Paper / Website | |
| LAMBADA | Cloze/完成 | 10K 叙事上下文(BookCorpus)+ 句子(掩掉最后一个词) | 预测最后一个词 | 特意构造以强制使用上下文 | Paper / Zenodo |
| Language Modeling_HELM | 语言建模 | HELM 汇编多数据集:WikiText-103、ThePile(arXiv、BooksCorpus2、Enron Emails、PubMed Central、Wikipedia)、TwitterAAE、ICE | 全序列条件 log-probability(perplexity) | Paper / The pile / Wikitext / Twitter AAE / ICE | |
| LegalSupport | Entailment、现实任务、推理 | 20K 法律 entailment 场景(州/联邦法律意见;断言作上下文,随机选 2 条支撑来源) | 找最支持断言的规则 | Paper / Data | |
| LinuxKernel_HELM | 生成、记忆 | 从 Linux 内核随机抽 2K 函数 | 从函数开头随机行数续写,测精确/近似复现 | Paper / Data | |
| LSAT | 分析推理、阅读理解、逻辑推理 | 10K LSAT 题(分析推理、逻辑推理、阅读理解),带上下文 | 正确回答 MCQA | Paper / Github | |
| Magellan Benchmark | 现实任务、推理、结构化数据 | 多来源 23 个数据集(实体+属性);dirty 数据集故意加入错列、拼写错误等 | 判断两个表中两个实体是否同一 | Abt-Buy 和 Buy 可能是同一数据集 | Paper / Github |
| MBPP | Code task, Text-to-code | 1K 入门级 Python 众包编程题(描述、解答、3 个单元测试)——58% 数学、43% 列表处理、19% 字符串处理、9% 整数序列、2% 其他 | 解 Python 题 | 还有 400 项编辑版(无歧义 prompt+好签名,可研究 prompt 对代码生成的影响)+ MathQA-Python | Paper / Github / HF |
| MMLU | 语言理解 | 15K 多选题(法律、哲学、经济、心理、STEM、医学等,高中到专业水平),人工从网络收集 | 回答 MCQA | 看起来是很强/高质量的 baseline | Paper / HF / Github |
| MRF (Misinfo Reaction Frames) | 生成、错误信息能力 | 20 万对新闻标题声明(气候、新冠、癌症等)+ 标签(真实/错误信息);MTurk 标注真实性、传播可能性、作者意图 | 预测 gold 标签或生成可能的作者意图/读者感知 | 含 NELA-GT-2018-2020、SciDCC、Climate-FEVER、CoAID、CoronaVirusFacts、ESOC、DETERRENT 数据 | Paper / Github |
| MS MARCO | QA、检索 | 100 万匿名问题+自由形式人工答案(来自相关网页摘要),部分带改写 | 原论文 3 任务:1) 生成正确回答 2) 无上下文也合理 3) 对 1000 段落排序 | HELM 只看排序任务,相关性用「Does the passage answer the query?」的 log-likelihood 估计 | Paper / Github |
| MS MARCO TREC (TREC 2019) | 检索 | 从 MS MARCO 派生的数据集(段落/文档检索,全量或 top-n 重排:文档 100 / 段落 1000) | 检索/重排 | Paper / Data / Github | |
| MultiRC | 语言理解、QA | 6K 多主题多选题 | Paper / Data | ||
| NarrativeQA | QA、检索 | 47K 自由形式人工问题与答案,关联 1.5K 书(Gutenberg)+ 电影剧本(抓取),配剧情摘要 | 从摘要或故事回答/选择 | 长上下文测试可用完整故事做 QA;对话类可能有趣 | Paper / Github |
| Natural Questions | 开放域/闭卷 QA | 20.7 万聚合 Google 搜索查询+标注的 Wikipedia 答案样本 | Paper / Data | ||
| NewsQA | QA | 10 万人工 QA 对(12K CNN 新闻文章);问题由标题+摘要生成、答案由问题+文章生成,经验证机制保留 | 可能与 CNN/DailyMail 有交集(抽取脚本相同) | Paper / Github | |
| OpenBookQA | 常识、推理 | 6K 句子,需常识推理外推到新情境的科学推理 | Paper / Data | ||
| PIQA | 常识、推理 | 20K 物理常识推理情境 | 从上下文与答案中选正确动作 | Paper / Data | |
| PopularBooksCorpus_HELM | 生成、记忆 | BooksCorpus 中出现在畅销书榜的 20 本书 | 从书首段开头随机 token 数续写,测精确/近似复现 | Paper / Data | |
| QuAC | 上下文阅读理解 | 10 万信息寻求型 QA 情境(用 Wikipedia 生成) | Paper / Data | ||
| RACE | 上下文阅读理解 | 10 万中国初/高中生英语阅读理解题 | Paper / Data | ||
| RAFT | 现实任务、文本分类 | 11 个自然分类任务数据集汇编,150–5K 测试项 | 从 50 个标注样本做 few-shot 分类(医学、金融、研究、英语、法律、物理、AI 安全、社交网络) | 语料:ADE Corpus v2、Banking77、NeurIPS 2020 impact statement risks、OneStopEnglish、Overrruling、Systematic review inclusion、TAI safety research、Terms of Service、TweetEval Hate、Twitter complaints、Semiconductor org types | Paper / HF |
| RealToxicityPrompts | 生成、毒性检测 | 10 万自然句子(OpenWebText≈reddit 选,PerspectiveAPI 打分),拆成 prompt+continuation | 续写并用 PerspectiveAPI 评毒性 | Paper / Data / Github | |
| ReCoRD | 语言理解 | 12 万 passage/cloze query/answer 样本(CNN、DailyMail 新闻),人工过滤 | Paper / Data | ||
| RTE | 语言理解 | 3K entailment 竞赛数据汇编 | Paper / Data | ||
| SAT analogies | 语言理解 | 2005 年前的 374 道 SAT 类比题(a is to b what c is to …,词汇非高频) | Paper / Data dev / Data test | ||
| SIQA | QA | 原文未提供细节 | |||
| SQuADv2 | 上下文阅读理解 | SQuAD + 5 万不可回答的问题 | 从上下文给出答案,但仅当可能 | Paper / Github | |
| StoryCloze | Cloze/完成、常识 | 5 万 5 句常识故事 | 选择正确结尾 | Paper / HF | |
| StrategyQA | 常识、推理 | 2.8K 需隐式知识推理的问题 | 加外部计算器效果最好 | Paper | |
| Synthetic reasoning (natural) | 逻辑推理 | 即时生成的合成数据:合成规则(条件句)、事实(属性)、逻辑 gold 输出 | HELM 中也叫 rule_induct | Paper / Github | |
| Synthetic reasoning (symbolic)_HELM | 逻辑推理、符号操作 | 用模板即时生成的合成数据 | 测模式识别("beach + beach - pear" → "A + A - B")或给定模式做字符串替换 | Paper / Github | |
| TriviaQA | 开放域/闭卷 QA | 9.5 万 trivia QA(组合式问题、句法多样) | Paper / Data | ||
| TruthfulQA | QA | 817 个关于棘手事实主张的问题(常见误解、谬误等,38 类),含真/假参考答案+支持真实答案的来源(另有 +380 题) | Paper / Github | ||
| TyDiQA-GoldP | 多语言、QA | 20.4 万多语言 QA 对(en、ar、ben、fin、ind、ja、ko、ru、tel、th、kiswahili) | MCQA | 生成过程可能问题欠定义、问题与答案语言水平不匹配;可能比其他数据集难 | Paper / Github |
| Web Questions | 开放域/闭卷 QA | 从 Google Search API 抽取 10 万 "Wh?" 问题,MTurk 标注(答案可能部分过时) | MCQA | Paper / Website | |
| WebNLG | 生成、言语化 | 1.3 万三元组(subject/property/object,来自 DBPedia)与句子言语化(众包)的映射;主题:宇航员、大学、纪念碑、建筑、漫画角色、食物、机场、运动队、著作 | 语法正确的言语化 | 选句偏流畅、句子相对简单;无标注者来源描述,可能非「标准英语」 | Paper / HF |
| WiC | 语言理解 | 7K,判断一个词在两个不同上下文是否同义 | Paper / Site | ||
| WikiFact_HELM | Cloze/完成 | 12 个领域 1K 三元组(subject, relation, object),从 Wikipedia 采样并清理 | 预测关系句中的缺失项 | Paper / Codalab / Github | |
| WikiLingua | 生成、多语言、摘要 | 4.3 万文章/摘要对(WikiHow 18 种语言);摘要=各步摘要句拼接,文章=详细段落 | 摘要 | Palm:prompt 前缀+截断 2048 token;怀疑数据创建导致摘要基线「机械化」语言,可能低估更流畅的摘要(ROUGE 应不太受影响) | Paper / Github |
| Winogender | 偏见检测 | 原文未提供细节 | |||
| Winograd | 推理、Winograd | 273–285 个例句:消解代词指代(特意构造得对统计方法难、对人容易) | 代词消解 | 作者不确定 GPT-3 评测用的是这个还是 SuperGLUE 版 | Paper / Website |
| WinoGrande | 推理、Winograd | 4.3 万句对抗性 Winograd 句 | Paper / Website | ||
| WSC | 语言理解、Winograd | Winograd Schema Challenge | Paper / Website | ||
| XSUM | 摘要 | 22.6 万 BBC 新闻文章(2010–2017,WayBack 机器抽取)+单句摘要(来自文章本身) | 摘要 | 领域:新闻、政治、体育、天气、商业、科技、科学、健康、家庭、教育、娱乐、艺术;可手动检查模型近期知识是否让旧闻摘要产生差异 | Paper / HF / Github |
4.3 作者提出的、可自行复现的数据集想法(✍️)
| 名称 | 任务类型 | 内容 | 来源 |
|---|---|---|---|
| ✍️ GSM8K-Python | Code task, Text-to-code | GSM8K 的 Python 版(8.5K 年级数学题) | Paper |
| ✍️ MRF | 生成、人工评测、错误信息能力 | 从 MRF 抽 250 条标题,按论点聚成 80 簇;任务:从论点+5 条标题生成支持论点的可信标题;标注者评估 1) 是否支持论点 2) 是否看起来真实 | Paper / Data;原始流程报告 第 6 页 + HELM 论文 8.5.2、E.5、5.5 节 |
| ✍️ News article generation | 生成 | 从标题与副标题生成 25 篇文章,80 人判断是生成还是原创 | Paper(GPT-3) |
| ✍️ Numeracy Prediction | 符号操作 | 给几个例子做符号回归(symbolic regression),把数字关系应用到新输入 | Paper / Github |
| ✍️ SVG datasets | — | 构造 SVG 数据集,看模型能否生成或解释 SVG 绘图 | Twitter thread |
| ✍️ Theory of the mind datasets | — | 心智理论数据集,可能很容易生成 | Paper |
| ✍️ Wedging prompts | 生成、人工评测、错误信息能力 | 11 个带特定意图的 prompt(如影响投票行为、生成支持/反对 X 的言论定向特定群体),各加 3 个示例,生成后续示例 | Paper / Data;HELM 人工评测:1) 是否针对目标群体 2) 是否支持目标信息 3) 是否分裂 |
| ✍️ Word scrambling | 符号操作 | 5 个字符操作任务各 1 万例(循环字母、字母重排、随机插入、反转),恢复原词 | Paper(GPT-3 §3.9.2);容易生成/自动化 |
5. Tips and Tricks
5.1 管理污染(Managing contamination)
总原则:凡是公开在网上的数据集,都应假设它已经(或将会)被污染。
缓解措施:
- 提供 canary string(金丝雀字符串)——如 BigBench 的做法:在评测集中放一个特殊字符组合,模型创建者可以在自己的训练集里搜索它,一旦出现即表明训练集含有评测数据。
- 以加密(encrypted)或门控(gated,如 GPQA)形式提供评测集——让网络爬虫难以解析,从而不会意外进入训练集。
- 运行动态 benchmark(dynamic benchmarks)——随时间定期更新,模型无法「把答案背下来」(但数据集成本更高)。
- 事后检测污染(detect contamination)——例如看生成结果的 perplexity,或设计对抗性 prompt 变体。注意:没有哪种污染检测方法是万无一失的。
不过也要记住:数据集被污染不代表它不再有趣、不再有信号——训练过程中它依然有用。
5.2 实战中会遇到的问题
微调模型、system prompt 与 chat template
很多 instruction-tuned 模型如果没做到以下几点,表现会非常差:
- 在推理的最开始加上它们的 system prompt;
- 用 chat template 提示它们(通常是在对话轮次上加
Assistant/User前缀——详见 ⭐ 这个指南)。
另外,不要假设不同 tokenizer 行为相同,尤其是在 chat template 方面——参见 ⭐ 这条推文 里关于 tokenization 空格与 chat template 的示意图:
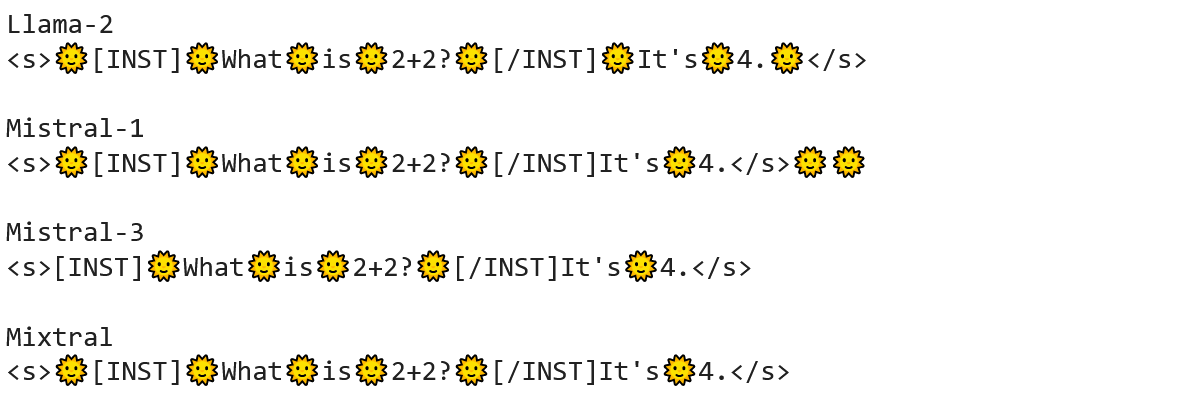
Tokenization 细节
1. 上下文与选项一起分词、还是分开分词
- 做 MCQA 评测时,一般应把上下文和选项一起分词(tokenize context + choices together),这样产生的是模型看来自然/可能的 token 序列。
- 但有些 tokenizer(如 Llama 的)不满足
enc(context + choice) = enc(context) + enc(choice)(会增删空格)。这意味着比较各选项的 log-probability 不容易——上下文 token 可能「渗入」选项 token,破坏比较。 - 若你的模型如此:可以先分别计算 context 和 choice 的 token,再去掉各自附加的特殊开始/结束 token 后拼接。
2. 注意开始与结束句子 token(start / end of sentence tokens)
- 有些模型(如
Gemma)对推理时是否包含 start-of-sentence token 极其敏感。你可能要做几个实验确认你的模型是否如此,必要时手动加上这些 token。 - 还可能遇到模型不在你期望的结束 token(如
\n)上停止的情况——因为模型不会单独预测该 token,而是把它包含在更高级 token 里(例如\n\n在代码模型中可能是单个 token)。此时需要加一个「回溯(backtrack)」检查:在计算 metric 前把生成文本在正确位置截断。
3. 多语言与 tokenization
- 做多语言评测时,要根据评测任务和 metric 决定如何分词。有些语言不用空格作词分隔符(韩语、泰语、日语、中文等),需要语言特定的 tokenizer 才能正确切分,否则会影响 BLEU、F1 等指标得分。
4. 代码评测与结束句子 token
- 代码模型通常把
\n\t训练成单个 token,生成时常一步产生\n\t。 - 若任务把
\n定义为结束 token(停止生成),模型在预测\n\t(作为一个 token,不等于\n)后仍会继续生成,而你其实希望它停下来。 - 对策:要么更新你的结束 token 集合,要么定义一个基于字符表示回溯最新 token 的机制,事后停止并截断生成。
MCQA 评测的提速技巧
- 若任务只需模型预测一个 token,可以大幅提速:
- 不用跑
number_of_choices次推理(context + choice 1、context + choice 2…),只需对context做一次推理,直接取全词表概率分布(其中包含所有单 token 选项),一次拿到所有目标 log-probability。 - 这正是
lighteval的做法。
- 不用跑
5.3 生成式评测结果异常差时的排查
第一步永远是仔细检查模型的生成结果。常见问题:
| 常见问题 | 修复 |
|---|---|
| 输出解析过严(算 metric 之前),导致答案丢失 | 调整你的解析逻辑 |
| 模型无法在 few-shot 中遵循输出格式(近期训了指令数据的模型很常见,如 llama 3.2、Qwen 2.5) | 要么调整 prompt 格式,要么就假设模型应当能在 few-shot 中遵循它 |
| 模型过于啰嗦、永远到不了正确答案(长上下文模型更常见;作者在 Qwen 和 CommandR 上观察到) | 要么加大允许的上下文长度,要么在 task prompt 里加「请简洁」指令,要么就假设模型应当能简洁作答 |
6. 参考资料
原文(GitHub evaluation-guidebook)
- 章节总览:
contents/automated-benchmarks/ - 指南仓库:https://github.com/huggingface/evaluation-guidebook (已迁移至 OpenEvals/evaluation-guidebook,见 00-Overview)
指南内部其他章节(交叉引用)
- Model inference and evaluation(生成式 vs log-probability 输出、约束输出)
- Troubleshooting reproducibility(不同 prompt 对结果的影响)
- Using human annotators(人工标注者)
作者推荐的外部链接(⭐)
- ⭐ 作者的个人 evals 博客:LLM Evaluation(clefourrier)(与本文有部分重叠)
- ⭐ Cosmopedia 博客(用 LLM 造合成数据集)
- ⭐ lighteval Metric List wiki(metric 清单)
- ⭐ Transformers chat templating 指南
- ⭐ tokenization 空格与 chat template 示意图(Daniel Han 推文)
- ⭐ Prompts vs. Leaks: 模型过拟合评测格式的论文
- ⭐ Challenges in evaluating LLMs(ehudreiter 博客,为何要测最差表现)
论文与工具链接(正文出现)
污染相关:BigBench canary · 加密评测 · GPQA gated 数据集 · 动态 benchmark · 污染检测
设计与方法:选项顺序偏好 · Open LLM Leaderboard drop(归一化不公平) · NPHardEval · DyVal · MuSR · bAbI
工具:lm-evaluation-harness(PR #531 Llama tokenizer、PR #1465 Gemma SOS token、Issue #212 多语言 BLEU)· lighteval
数学/Pre-LLM 数据集的全部论文与数据链接见 第 4 节表格。