vault backup: 2026-09-23 17:44:54
This commit is contained in:
 windyboy
@@ -0,0 +1,389 @@
|
||||
---
|
||||
title: "万字长文|Web出海第一步,从选需求到关键词研究,教你选出第一个赚美刀的方向"
|
||||
source: "https://x.com/momo_peggy/status/2099415429831876747"
|
||||
author:
|
||||
- "[[@momo_peggy]]"
|
||||
published: 2026-09-14
|
||||
created: 2026-09-21
|
||||
description: "大家好,我是夏林果~!好么,上回那篇Web出海的完整闭环流程写完,很多准备做出海的小伙伴关注了我,跟我说已经开始采购域名了,这家伙,大家这执行力很棒啊!夏林果的出海日记@momo_peggy·9月8日今天开始,来讲讲我最熟悉的Web出海业务,小白友好~! 文章万字长文|从 0 到..."
|
||||
tags:
|
||||
- "clippings"
|
||||
- "webclipper"
|
||||
---
|
||||
> [!info] Source
|
||||
> URL: https://x.com/momo_peggy/status/2099415429831876747
|
||||
> Title: 万字长文|Web出海第一步,从选需求到关键词研究,教你选出第一个赚美刀的方向
|
||||
> Clipped:
|
||||
|
||||

|
||||
|
||||
大家好,我是夏林果~!
|
||||
|
||||
好么,上回那篇Web出海的完整闭环流程写完,很多准备做出海的小伙伴关注了我,跟我说已经开始采购域名了,这家伙,大家这执行力很棒啊!
|
||||
|
||||
> 9月8日
|
||||
>
|
||||
> 今天开始,来讲讲我最熟悉的Web出海业务,小白友好~!
|
||||
|
||||
我知道你很急,但你先别急,我建议你不要急着注册域名,也不要让ai开始写代码。先花点时间确认你要做个什么站,解决什么问题,赚谁口袋里的钱
|
||||
|
||||
所以这一篇开始讲第一步:**怎么从一个想法开始,找到真实需求,再把它变成用户会搜索的关键词,从而确认好赚美刀的方向。**
|
||||
|
||||
这篇第一步的流程,是我认为最重要的,最核心的,如果你是想做Web出海的小白,看看这篇吧(文章有点长,你可以收藏了回头用的时候再看hhh)
|
||||
|
||||

|
||||
|
||||
## 一、Web 出海的第一步是找好需求
|
||||
|
||||
**为什么 Web 出海第一步是找好需求**
|
||||
|
||||
这一步最最最最重要!!你得找能产生收益的需求~选不好后面全完犊子!
|
||||
|
||||
新手最常见的情况是,想到一个自认为很妙的产品,然后马上开始自嗨式开发了。做了几周,功能越来越多,页面越来越复杂,最后鼓捣上线了。结果过了三个月没什么流量,更没有用户付费,这时才开始怀疑是不是推广做得不够好。
|
||||
|
||||
但很多时候,问题根本不在推广,而在一开始就没有确认:谁会用,为什么现在就要用,他会去哪里寻找解决办法。
|
||||
|
||||
比如,我高中同学之前打算给宠物主人做个社交类的网站,类似于宠物主人版的人人网。我听完其实心里觉得有点不靠谱,这个功能太大了,太泛了,你有自信做的比脸书和ins还牛吗。费心费力做出来,最后可能连一个真正愿意用的人都没有。
|
||||
|
||||
所以我现在更愿意先问另一组问题:**海外用户正在为什么问题花时间、花钱?** 这个问题是不是反复出现?他们现在怎么解决?现有方案到底差在哪里?
|
||||
|
||||
**好需求如何定义**
|
||||
|
||||
是不是好需求方向,看四个点:
|
||||
|
||||
- **问题是否具体**:能不能说清楚是谁,在什么场景下,要完成什么动作?哪怕是一个小问题都行
|
||||
- **问题是否重复**:是偶尔发生的一次意外,还是用户每周、每天都会遇到?
|
||||
- **用户是否在找办法**:他有没有搜索、提问、比较工具,或者已经找人帮忙?
|
||||
- **有没有付费理由**:解决它能不能省时间、少出错、赚到钱,或者避免一笔损失?
|
||||
|
||||
别妄想给所有人做一个万能工具,用户不明确,问题不具体,关键词发散,竞品又多。你很难知道第一版到底该做什么。
|
||||
|
||||
反之,你可以选择**做一个精细垂直的小工具,解决一个小问题**,比如“帮独立卖家在发货前自动检查地址格式”,用户、场景和动作就清楚多了。接下来要查的也很具体:这类卖家多久遇到一次?现在怎么处理?是自己忍着,还是找人帮忙,或者已经在买别的工具?
|
||||
|
||||
## 二、怎么找到一个好的需求
|
||||
|
||||
这个过程我一般分成三个动作:捞、筛、掂(怎么那么像厨子呢hhh)
|
||||
|
||||

|
||||
|
||||
**第一步:捞,把需求的线索先捞上来**
|
||||
|
||||
从哪捞?海底捞吗?当然不是了,怎么就惦记吃呢hhh
|
||||
|
||||
我给你找了6种可以捞需求线索的方向,往下看吧兄弟~⬇️⬇️⬇️
|
||||
|
||||
**1️⃣用户表达:他们正在怎么说**
|
||||
|
||||
先听用户怎么在平台去吐槽,甚至去骂,这个来源又可以分成两种:
|
||||
|
||||
- **社交媒体和社区**:看 Reddit 的行业小板块、X、Facebook 群组、LinkedIn、Discord、Indie Hackers 等。这里更容易看到用户日常抱怨、经验分享和临时解决方案。
|
||||
- **论坛和问答**:看 Quora、Stack Overflow,以及各种垂直论坛。这里的问题通常更具体,能看到用户卡在了哪一步、尝试过什么办法。
|
||||
|
||||

|
||||
|
||||
**2️⃣用户反馈:现有产品哪里没有接住**
|
||||
|
||||
如果已经有竞品,甚至有付费的竞品,说明这个需求起码已经被市场验证可行,这时候就去看它的低星评价。G2、Capterra、App Store、Chrome Web Store,以及竞品自己的评论区都可以看。
|
||||
|
||||
不要只看评分,重点看用户原本想完成什么,产品在哪一步没有满足。但一条差评只代表一个人的经历。把相似评价多找几条,看它到底是偶发问题,还是很多人都在遇到。当然了,光看可不行啊,你得上手试试,看看用户说的是真是假,有没有可能这些吐槽已经被竞品解决了呢。
|
||||
|
||||
**3️⃣产品市场:这个领域已经有什么**
|
||||
|
||||
**导航站和综合目录**,比如 Product Hunt、AlternativeTo、SaaSHub、BetaList、Uneed,以及各种行业工具目录,适合用来建立一个领域的产品地图。
|
||||
|
||||
你可以记录产品服务谁、解决什么问题、怎么分类、怎么收费,以及用户正在寻找哪些替代品。它们只能帮你看市场上有哪些产品,不能直接证明产品有流量或销量。被目录收录,最多说明它出现过,不能说明用户真的在用,更不能说明它卖得好,有可能就是花钱做外链了。
|
||||
|
||||
4️⃣**付费行为:用户已经为哪些事情花钱**
|
||||
|
||||
可以分成两类看:
|
||||
|
||||
- **服务交易平台**:Upwork、Fiverr、Freelancer、Contra、PeoplePerHour。这里能看到用户愿意花钱请人完成什么任务,以及他们如何描述需求、预算大概在哪个范围。
|
||||
- **招聘平台**:LinkedIn Jobs、Indeed、Wellfound、Remote OK。这里能看到企业愿意长期花工资让人做什么重复劳动,以及这个岗位需要哪些固定能力。
|
||||
|
||||
这两类信息要分开理解。服务平台说明有人愿意为一次任务付钱,招聘平台说明企业愿意长期为一类工作付费。它们都不能直接推出用户会买软件,你还要看这项工作是不是重复、能不能标准化,以及人工流程里有没有一段可以被工具替代。
|
||||
|
||||
**5️⃣搜索行为:用户有没有主动找解决办法**
|
||||
|
||||
Google 的自动联想、相关搜索和搜索结果,也值得顺手看一眼。这里先做轻量观察,不需要马上展开完整关键词研究。
|
||||
|
||||

|
||||
|
||||
你可以先记下用户使用的原词,以及搜索结果到底是工具、教程、论坛还是产品对比。这样能帮助你判断:用户是在了解问题,还是想马上完成一个动作。
|
||||
|
||||
正式的搜索量、CPC、KD 分析放到后面的关键词研究部分。前面只需要确认这个问题有没有被用户用搜索表达。
|
||||
|
||||
**6️⃣亲身体验:你自己在哪里被卡住**
|
||||
|
||||
这个最常见吧,你在使用海外产品时遇到的卡点,也可以成为线索。比如操作很绕、某个功能缺失、价格不透明、导出麻烦,或者一个简单任务需要反复手动完成。
|
||||
|
||||
但个人体验只能作为起点,不能直接当成市场结论。把它记下来,再去用户讨论、竞品评价和搜索结果里找印证。你过去工作里如果出现过要是有人做了某个工具,我们马上就买这样的表达,也值得先记录,再验证。
|
||||
|
||||
你不需要把这些来源全部逛一遍。新手可以先选一个用户表达的地方,再选一个能观察付费行为的地方,最后用搜索结果做一次交叉验证。**至少有两类证据对得上,再进入下一步;不要因为某个平台上出现一个热门帖子,就马上开始做产品。**
|
||||
|
||||
**第二步:筛,伪需求你不要过来啊!**
|
||||
|
||||
这步你得把每条线索重新过一遍,主要看三个点:问题够不够具体,是否反复发生,遇到它的人是不是一群相对清楚的人。
|
||||
|
||||
- **第一道:数次数,而且要跨地方数。** 同一个抱怨在不同地方出现,比一个帖子里有很多点赞更有参考价值。比如 Reddit 有人在讨论,竞品差评区有人提到,论坛里也有人问,三个地方各出现一次,往往比单个平台刷屏更可靠。
|
||||
- **第二道:分清用户是在发泄,还是在找办法。** 光骂现有产品,可能只是情绪。骂完以后还在问有没有替代品、大家正在用什么、有没有更快的做法,这就不一样了。后面这类人已经开始找答案,离一个可被解决的需求更近。
|
||||
- **第三道:看是谁在骂。** 如果抱怨的人都是小会计、独立卖家、摄影师,或者某一类具体用户,后面就比较好验证具体场景。
|
||||
|
||||

|
||||
|
||||
**第三步:掂,确认它有没有变现机会**
|
||||
|
||||
这里要看的,是它有没有付费理由,市场上有没有空隙,以及你自己能不能做出来、推广出去。
|
||||
|
||||
- **第一关:看市场上有没有人真金白银在付。** 打开竞品定价页,看同行如何收费,免费版和付费版的边界在哪里,哪些功能被放在付费墙后面。这能告诉你市场里已经存在什么收费方式,但不要把定价页当成销量证明。
|
||||
- **第二关:看这个赛道有没有现实的切入口。** 用候选关键词搜索前几页结果,把排名靠前的产品列出来,简单看它们的域名经营时间、网站权重、引荐域名数量、内容规模和产品质量。如果前几页几乎都是经营多年的强品牌,且外部链接和内容积累明显领先,新手就要谨慎,不要只因为有搜索量就冲进去。
|
||||
- **第三关:先做一次最低限度的功能对齐。** 不需要马上做完整竞品调研,但要把首页排名靠前的产品打开,走一遍它们的核心流程:用户怎么进入,怎么完成任务,最后拿到什么结果。把这个流程拆成几个基础功能,再问自己:这些功能我能不能做?第一版能不能至少完成同样的核心任务?
|
||||
- **第四关:问用户的行为,不要问意愿。** 找到前面发帖抱怨、留下差评的人,尝试和他们交流。比如上一次遇到这个问题时,你是怎么处理的?花了多少时间和钱?最后怎么解决?现在还会遇到吗?用户能讲出具体过程,说明他真的经历过。
|
||||
- **第五关:重新掂一遍问题本身。** 重点问四件事:做错了有没有后果,用户烦不烦,这个问题是不是隔三差五就来一次,用户有没有已经到处找办法。能帮用户省时间、赚钱、减少错误或降低麻烦的需求,通常比纯娱乐需求更容易找到付费理由。
|
||||
- **第六关:算一算成本。** 用 AI、现成接口或无代码工具,能不能先做出一个可用版本?单个用户的服务成本是多少?未来可能的定价和成本之间有没有利润空间?同时写出这批用户可能聚集的三个地方。暂时说不出来,不代表需求一定不存在,但说明你的获客路径还没有出现,需要继续查。
|
||||
- **第七关:掂自己能不能接得住。** 你能不能做出至少不输给竞品的基础体验?能不能理解这批用户?能不能持续处理客服、反馈和后续需求?有些方向看起来有钱,但你没有能力或兴趣长期服务,最后也很难做成。
|
||||
|
||||
行了,这三步你看完,需求也就基本选择的差不多了。
|
||||
|
||||
## 三、选好需求后做关键词研究
|
||||
|
||||
**为什么选好需求后还要做关键词研究**
|
||||
|
||||
需求确认之后,你得琢磨琢磨,用户在谷歌是怎么去搜的。对 Web 工具来说,关键词研究是在继续追问三件事:
|
||||
|
||||
- **用户会怎么说:** 他会在搜索框里输入什么词?
|
||||
- **他搜这个词想做什么:** 是了解问题、比较方案,还是马上使用工具?
|
||||
- **这个词值不值得做:** 有没有足够的需求、商业价值和进入机会?
|
||||
|
||||
它至少会影响后面的产品决策:
|
||||
|
||||
- 决定你的首页应该围绕什么词和什么动作来写;
|
||||
- 决定你要做工具页、产品页,还是先做教程和对比内容;
|
||||
- 决定你是依靠搜索获客,还是要换成社媒、社区或其他渠道。
|
||||
|
||||
比如“做一个去水印工具”是产品想法,不是关键词。用户可能搜索 image watermark remover,也可能搜索 remove watermark from photo。这两个词看起来相近,背后的用户表达和搜索结果却可能不一样。
|
||||
|
||||
所以,关键词研究最后要回答的不是“哪个词搜索量最高”,而是:**用户真的在搜什么,我应该用什么页面接住他,以及这个词有没有机会给产品带来用户和收入。**
|
||||
|
||||

|
||||
|
||||
**关键词研究怎么做**
|
||||
|
||||
你可以先把这件事记成一条很简单的路线:**先把用户可能搜索的词找出来,再弄清楚每个词背后的意图,最后从里面选出第一批真正值得做的核心词。**
|
||||
|
||||
**第一步:从需求里提炼核心词,再把词池扩展开**
|
||||
|
||||
核心词,就是你对这个需求最直接、最基础的几种叫法。不要一开始就追求“最准确的词”,先把用户可能使用的表达收回来。
|
||||
|
||||
可以从四个方向列核心词:
|
||||
|
||||
- **产品词:** 用户可能直接搜索的工具或产品名称;
|
||||
- **动作词:** 用户想完成的动作,比如 translate、remove、convert、generate;
|
||||
- **场景词:** 用户在什么场景下使用,比如 academic paper、online、for students;
|
||||
- **用户原话:** Reddit、论坛、差评和客服沟通里出现过的自然表达。
|
||||
|
||||
以 PDF Translator 为例,第一批核心词可以先从 pdf translator、translate pdf、online pdf translation 这些核心表达开始。像“扫描件翻译”“论文翻译”属于后面扩展出来的场景词,不要一开始就把词池做得很散。
|
||||
|
||||
- 看 Google 搜索框的自动联想和底部相关搜索。
|
||||
- 看竞品首页、标题、描述和产品功能中反复出现的表达。竞品已经在用的词,至少说明这个词和市场有关系,但不代表你可以直接照抄。
|
||||
- 看 Reddit、论坛、问答和用户评价中的原话。工具给你的是数据,用户原话能告诉你他们真实怎么描述问题。
|
||||
- 用 Ahrefs、Semrush、Google Keyword Planner 等工具扩展相关词;预算有限,可以先用 Google 自动联想、Google Trends 和 Keyword Planner。
|
||||
- 让 AI 帮你发散,但只把它当成候选词生成器。AI 可以帮你把说法想宽,最后能不能留下,要回到真实搜索数据和 Google 首页结果。
|
||||
|
||||
英文市场可以这样问 AI:
|
||||
|
||||
```text
|
||||
你是一名 SEO 关键词研究员。
|
||||
我要做一个工具网站:[一句话描述这个工具给谁用、解决什么问题]。请想象一个真实用户,他正被 [这个工具解决的问题] 困扰,正在谷歌上搜索解决办法。
|
||||
列出 20 个他真正会敲进谷歌的英文关键词短语。
|
||||
每个关键词标注搜索意图:想直接用工具、想找教程、还是在比较产品。最后按“关键词—搜索意图”的清单输出。
|
||||
```
|
||||
|
||||
如果你想看小语种市场,不要让 AI 把英文清单逐词翻译过去。可以这样问:
|
||||
|
||||
```text
|
||||
现在把同样的事再做一遍,换成 [德语] 市场。
|
||||
列出 20 个母语者遇到同样问题时,真正会敲进谷歌的 [德语] 关键词短语。
|
||||
不要把英文清单逐词翻译过去,要按当地人的真实搜法来想。
|
||||
每个关键词标注搜索意图,结果用 [德语] 输出,并按“关键词—搜索意图”的清单排列。
|
||||
```
|
||||
|
||||
小语种最容易踩的坑,是把英文逐词翻译成当地语言,但当地人根本不这么搜。AI 和翻译工具可以帮你列候选词,最后一定要回到目标国家的搜索结果,最好再找母语者确认。这个后面我单独写一篇怎么找小语种的关键词。
|
||||
|
||||
**第二步:判断搜索意图,并把相近的词归到一起**
|
||||
|
||||
拿到一批候选词之后,先别急着看数字。先判断用户搜索这个词时到底想做什么。常见的搜索意图可以简单分成四类:
|
||||
|
||||
- **信息型:** 想了解、学习或解决一个问题,比如 how to translate a pdf;
|
||||
- **商业调研型:** 想比较工具或方案,比如 best pdf translator;
|
||||
- **交易型:** 想直接完成动作,比如 pdf translator online;
|
||||
- **导航型:** 想找某个已经知道的品牌或网站。
|
||||
|
||||
判断意图最简单的办法,就是把词放进 Google,看首页结果。是工具页多,还是教程、论坛和对比文章多?Google 首页已经告诉你这个词背后的主要需求。
|
||||
|
||||

|
||||
|
||||
接下来要做关键词分组。不要把每个词都当成一个独立页面,也不要为了凑词给同一个需求写十篇差不多的文章。
|
||||
|
||||
- 搜索意图和 Google 首页结果高度相似的词,可以归为一组;
|
||||
- 一组词选一个主关键词,其余作为相关词自然覆盖;
|
||||
- 如果两个词的首页结果完全不同,说明它们可能是两个不同主题,需要分别判断。
|
||||
|
||||
比如 pdf translator 和 online pdf translator 的搜索结果可能高度重叠,可以先作为一个工具页主题;而 how to translate a pdf 更像教程意图,可以单独做内容页,再把用户引导到工具页。
|
||||
|
||||
**第三步:从候选词里选出真正要做的核心词**
|
||||
|
||||
好词其实可以先用一句话理解:**用户搜完确实想完成一个动作,搜索量或流量潜力够用,KD 没超过你的红线,而且你的产品能直接接住这个需求。**
|
||||
|
||||
确定了什么叫好词之后,再用数据做粗筛。对我自己做 Web 工具来说,我会先用一条比较直接的标准:**优先看搜索量或流量潜力在 10K 以上、KD 不超过 60,而且搜索结果里确实有工具或产品页的词。**
|
||||
|
||||
这不是 Google 的规则,而是用来帮自己快速缩小范围的工作门槛,一般会用semrush看:
|
||||
|
||||
- **搜索量 / 流量潜力:** 先看这个词有没有足够大的搜索入口。搜索量低于 10K,我通常先放到后面;如果新手觉得门槛太高,可以先从 1K 以上的词练手。
|
||||
- **KD:** 看竞争难度。KD 大于 60,我通常先不考虑;新手可以优先找 KD 30—50 的词。
|
||||
|
||||

|
||||
|
||||
- **CPC:** 看广告主是否愿意为这类点击付费。CPC 越高,商业价值通常越明显,但它只是参考,不能单独证明能赚钱。
|
||||
- **搜索结果:** 如果首页主要是工具、产品页或落地页,说明用户有直接完成动作的需求;如果全是教程和论坛,商业价值通常要打折。
|
||||
|
||||
## 四、小白跟练实操案例:PDF Translator
|
||||
|
||||
前面讲的是方法,下面把这个方法真正走一遍。PDF Translator 这个方向是我先拿到的一个具体想法,接下来要做的不是马上开发,而是按照前面的流程去确认:它到底是不是一个值得做的需求。
|
||||
|
||||
**第一步:捞,收集 PDF Translator 的需求线索**
|
||||
|
||||
我自己在处理外语论文、报告或说明书时,遇到过一个很直接的卡点:想把 PDF 翻译成自己能读的语言,但复制、分段翻译、对照原文和重新排版都很麻烦。
|
||||
|
||||
所以后来我基本用Dechecker的pdf translator的功能去翻译,因为可以保留文档的布局格式,不会乱码,也不会串行,主要是我觉得还算便宜,文档很大也不用等非常久,但我还是想自己做一个
|
||||
|
||||

|
||||
|
||||
[dechecker.ai](https://dechecker.ai/)
|
||||
|
||||
后来我在 Reddit 上继续搜,发现这不是我一个人的问题。有人在问怎么翻译整份 PDF,有人在问扫描版 PDF 怎么处理,也有人抱怨翻译完以后标题、表格和原来的版式全乱了。
|
||||
|
||||

|
||||
|
||||
这时我开始认真看 PDF Translator 这个方向。自己的卡点只能算第一条线索,Reddit 上的重复讨论说明问题可能普遍存在,现有产品没有形成完整体验,则说明市场里可能有缺口了。
|
||||
|
||||
**第二步:筛,确认问题是否反复出现**
|
||||
|
||||
接下来要确认的其实是同一件事:用户是不是经常遇到这个问题,而且已经为解决它付出了时间或金钱。
|
||||
|
||||
我把 Reddit 上的讨论、现有产品的低星评价和用户正在使用的替代方案放在一起看。看大家是不是在描述相似的过程:上传失败,扫描件识别不了,翻译后格式混乱,表格和公式不能处理,或者只能复制文字后分段翻译。再看他们现在怎么解决。有的人复制粘贴,有的人购买通用翻译工具,有的人请人处理,还有的人在不同工具之间来回切换。这些行为说明用户已经在付出成本。
|
||||
|
||||
从这些讨论和评价里,还能整理出几个核心痛点:比如 PDF 不能直接复制,扫描件需要识别;翻译后标题、表格和页码容易乱;专业术语前后不一致;用户最终想要的是一份可以继续阅读、下载和复查的文件,而不是网页里零散的翻译结果。
|
||||
|
||||
**第三步:掂,判断这个需求有没有机会做**
|
||||
|
||||
**先把用户场景和服务闭环梳理出来**
|
||||
|
||||
确认问题可能存在之后,我会把用户从进入网站到拿到结果的流程写出来。假设一个用户拿到一篇外语论文:
|
||||
|
||||
1. 他搜索 PDF 翻译工具,进入网站。
|
||||
2. 上传 PDF,先看到支持的文件大小、页数和语言。
|
||||
3. 选择原语言和目标语言,开始处理文件。
|
||||
4. 系统识别 PDF 内容,再进行翻译,同时尽量保留标题、段落和页码关系。
|
||||
5. 用户预览结果,发现某一段或某个术语有问题,可以单独重新处理。
|
||||
6. 用户下载结果,或者复制内容回到自己的笔记和文档里。
|
||||
7. 用户提交反馈,告诉产品哪一页有问题、哪个术语不准确。
|
||||
|
||||
这样梳理下来,PDF Translator 提供的就不只是一个翻译接口,而是一条完整服务流程:**上传文件,识别内容,翻译内容,保留基本结构,预览结果,下载文件,再收集反馈。**
|
||||
|
||||
第一版先处理常见的文字型 PDF,让用户完成上传、翻译、预览和下载。扫描件 OCR、复杂表格、公式、双栏论文的完美还原,可以作为后续功能,不要一开始全部塞进去。
|
||||
|
||||
然后问自己一个很现实的问题:第一版能不能把这条基础闭环做出来?不要求一开始比竞品更快、更便宜,也不要求马上覆盖所有复杂 PDF,但至少要能完成同一个核心任务。如果连基础功能都接不住,需求再真实也还不能进入开发。
|
||||
|
||||
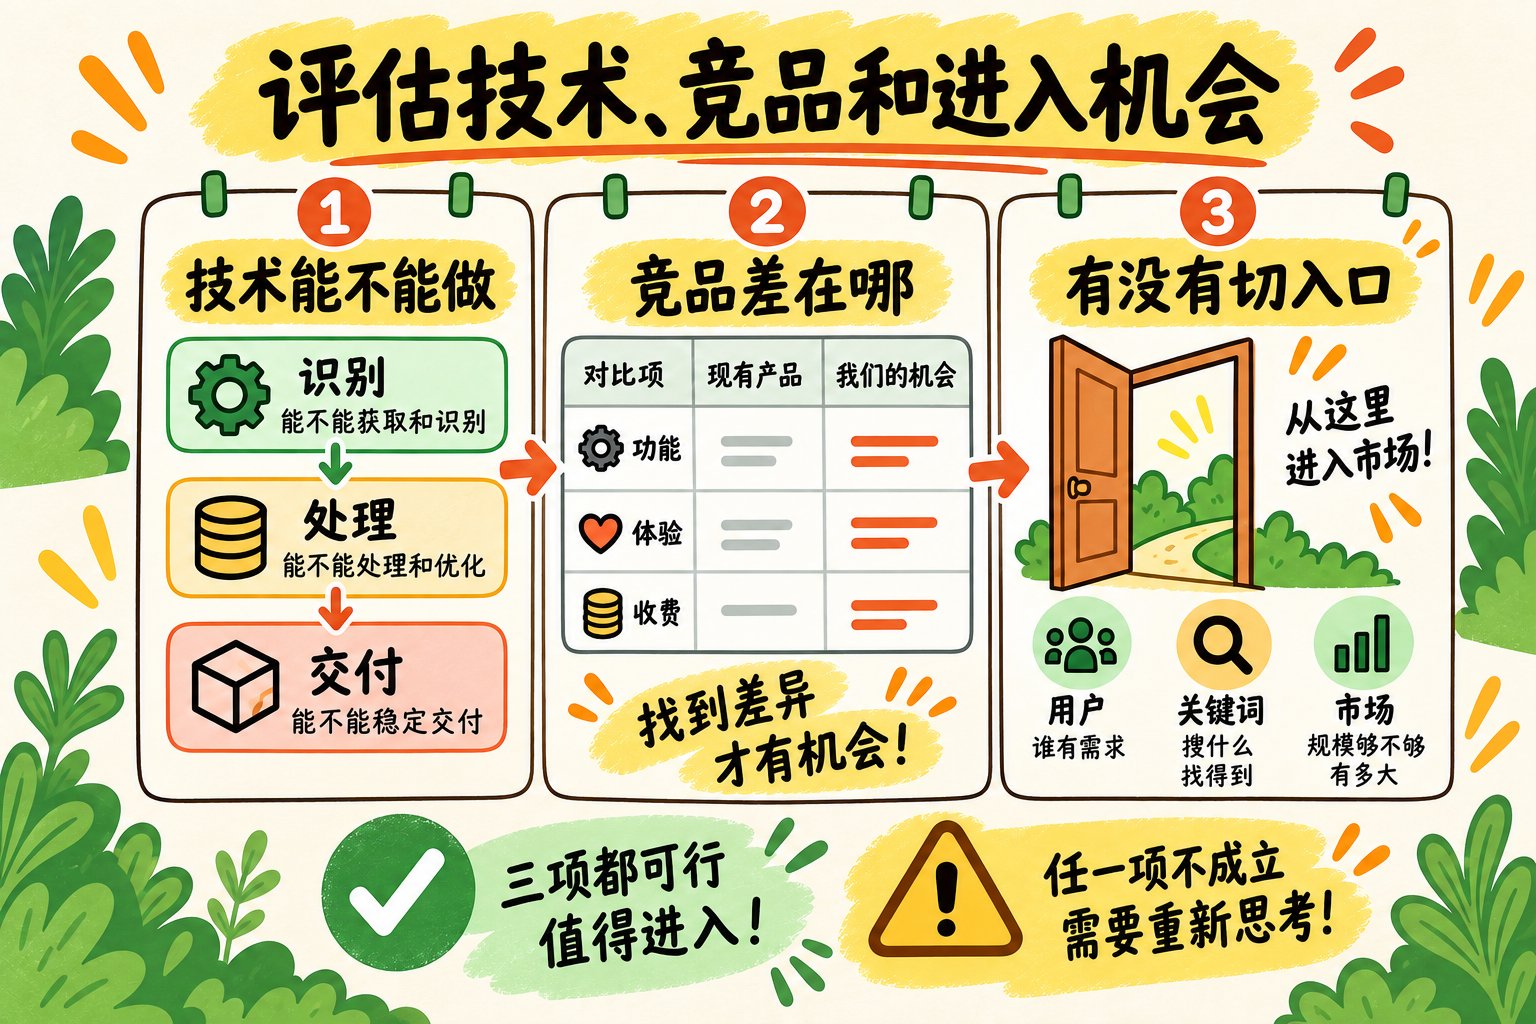
**再评估技术、竞品和进入机会**
|
||||
|
||||
需求看起来成立,还要继续判断能不能做。技术上,PDF Translator 至少涉及文本提取、扫描件 OCR、翻译接口、上下文处理、排版还原、文件生成和大文件处理。第一版如果只做文字型 PDF,技术难度是可控的;如果一开始就要求扫描件、复杂表格和论文双栏排版全部还原,成本会快速上升。
|
||||
|
||||
如果市场上已经有产品,但它们都只是顺手提供一个翻译入口,没有把识别、翻译、预览、下载和反馈做成完整体验,说明可能存在切入口。这个切入口还要结合关键词竞争判断,不能只凭“竞品体验不好”就开始开发。至于怎么系统拆功能、分析用户评价和寻找比竞品更好的位置,放到下一篇竞品调研里展开。
|
||||
|
||||
|
||||
|
||||
**第四步:开始关键词研究,确认有没有搜索入口**
|
||||
|
||||
**从需求里提炼种子词,再扩展候选词**
|
||||
|
||||
前面已经确认,用户想把外语 PDF 变成可以阅读、下载和复查的文件。所以这次不从“我还能想到哪些词”开始,而是先从产品动作和用户表达里提炼种子词。
|
||||
|
||||
第一批核心词先定为:
|
||||
|
||||
- pdf translator
|
||||
- translate pdf
|
||||
- pdf translation
|
||||
- online pdf translator
|
||||
|
||||

|
||||
|
||||
这几个词都直接对应“找 PDF 翻译工具”这个动作。再把它们放进 Google 自动联想、关键词工具和竞品页面里扩展,可能会出现 translate scanned pdf、translate academic paper pdf 这类场景词。
|
||||
|
||||
但这一轮先不把痛点词和长尾词全部纳入,目的是先验证这个产品最核心的搜索入口:用户是否会直接搜索“PDF 翻译工具”。
|
||||
|
||||
**判断搜索意图,并把相近的词归组**
|
||||
|
||||
这几个核心词的搜索意图不完全一样:
|
||||
|
||||
- pdf translator:更像是在找一个可以直接使用的工具;
|
||||
- online pdf translator:同样偏向在线工具,行动意图更强;
|
||||
- translate pdf:可能是找工具,也可能是找具体操作方法;
|
||||
- pdf translation:表达更宽,可能是在了解服务,也可能是在找工具。
|
||||
|
||||
最终不能只靠词面判断,还要看 Google 首页。如果 pdf translator 和 online pdf translator 的首页结果高度重叠,可以先归到同一个工具页主题;如果 translate pdf 的首页主要是教程,就要考虑它是否更适合用教程页承接,再把用户引导到工具。
|
||||
|
||||
这一轮先把核心工具词作为主线,场景词和教程词留到后续内容规划,不让第一版产品方向发散。
|
||||
|
||||
**从候选词里选出真正要做的核心词**
|
||||
|
||||
前两步已经把候选词找出来、按搜索意图分好组了。现在只做一件事:从里面选出 PDF Translator 第一版真正要做的核心词。
|
||||
|
||||
对这个工具,我会先用一个很直观的粗筛标准:**搜索量或流量潜力尽量在 10K 以上,KD 不超过 60,搜索结果里还要有用户可以直接使用的 PDF 翻译工具。** 新手不必照搬 10K,可以先从 3K 以上、KD 30—50 的词练手。
|
||||
|
||||
然后逐个核对:
|
||||
|
||||
- pdf translator 和 online pdf translator 的搜索结果是否高度重叠,能不能合并到同一个工具页;
|
||||
- translate pdf 是否更多是教程结果,如果是,就不要强行把它当成工具页的唯一核心词;
|
||||
- CPC 有没有显示出商业价值,排名靠前的页面有没有同时从相关词获得流量;
|
||||
- Google 首页是不是已经被强品牌占满,还是存在小站、功能缺口和用户吐槽。
|
||||
|
||||
这样筛完,PDF Translator 第一版就可以先围绕能直接接住工具需求的核心词做首页,其他教程词和场景词再作为后续内容入口,而不是一开始把所有词都做进去。
|
||||
|
||||
**复盘,判断能不能进入下一步**
|
||||
|
||||
到这里,我仍然不会直接说“PDF Translator 可以做”。更准确的说法是:它已经从一个产品想法,变成了一条可以继续验证的需求线索。
|
||||
|
||||
目前得到的是:
|
||||
|
||||
- 需求来源:自己处理外语 PDF 时遇到的卡点,以及 Reddit 上反复出现的类似问题
|
||||
- 用户场景:学生、研究人员和专业从业者,需要把外语 PDF 翻译成可阅读、可下载的文件
|
||||
- 验证证据:用户讨论、竞品差评、替代方案、付费成本和技术可行性需要互相印证
|
||||
- 基础功能对齐:至少确认竞品能完成上传、识别、翻译、预览和下载,自己也能做出第一版核心闭环
|
||||
- 产品闭环:上传、识别、翻译、保留基本结构、预览、下载、反馈
|
||||
- 核心关键词:先验证 pdf translator、translate pdf、pdf translation、online pdf translator
|
||||
|
||||
这才是从需求到关键词的完整过程:先发现一个具体任务,再确认它是否重复、用户是否在找办法、有没有付费理由,最后看它有没有搜索入口。中间任何一环证据不足,都不能急着进入开发。
|
||||
|
||||
## 五、复盘:从需求线索到关键词,完整流程是什么
|
||||
|
||||
这篇文章真正想讲的,不是怎么找一个听起来很酷的点子,而是怎么在动手开发之前,把一个方向逐层验证清楚。
|
||||
|
||||

|
||||
|
||||
整条路线可以压缩成五步:
|
||||
|
||||
1. **捞线索:** 从自己的卡点、用户讨论、竞品差评和付费行为里,找到一个真实发生的问题。
|
||||
2. **筛需求:** 确认这个问题是不是反复出现,用户有没有主动找办法,并且已经付出时间或金钱成本。
|
||||
3. **掂可行性:** 说清楚用户场景和服务闭环,走一遍竞品的基础流程,确认自己能不能做出不低于基础水平的版本。
|
||||
4. **查关键词:** 从需求里提炼种子词,判断搜索意图,再结合搜索量、流量潜力、CPC、KD、趋势和商业潜力排优先级。
|
||||
5. **做出判断:** 把需求、用户、基础功能、关键词和技术成本放在一起,判断这条方向是否值得进入下一轮。
|
||||
|
||||
所以,最后要回答清楚的不是一个问题,而是六个:**谁有问题?问题有多频繁?他们现在怎么解决?竞品的基础功能是什么?我能不能先做到同等水平?用户能不能通过搜索找到我?**
|
||||
|
||||
## 下一篇:研究竞品,知己知彼
|
||||
|
||||
这一篇只是完成了基础判断:需求是不是真实,用户有没有成本,产品能不能做,关键词有没有搜索入口。
|
||||
|
||||
下一篇我会**教你如何做竞品调研,并找到自己的机会点**
|
||||
|
||||
竞品调研的目的,不是找一个产品照着做,而是看清楚这个市场已经怎么服务用户、怎么收钱,以及还留下了什么空位。所以下一篇我们继续讲~!当然了,不会太快,我需要好好打磨内容。
|
||||
@@ -22,6 +22,21 @@ FgwV3@Pszx202503
|
||||
```
|
||||
|
||||
|
||||
|
||||
|
||||
aisotp:
|
||||
![[b02685b5772985d358ab7092c07d5058.png]]
|
||||
|
||||
vpn:
|
||||
|
||||
```
|
||||
Lixiaobing3905
|
||||
```
|
||||
|
||||
```
|
||||
Gxjrapid@2607
|
||||
```
|
||||
|
||||
### server password
|
||||
```password
|
||||
LNTwxy8%%7tE
|
||||
|
||||
@@ -0,0 +1,164 @@
|
||||
# 发改委登录信息
|
||||
|
||||
## VPN
|
||||
|
||||
零信任账号:chenzhq1453
|
||||
|
||||
密码:Bianhua@88
|
||||
|
||||
## 二期服务器
|
||||
|
||||
### 二期堡垒机
|
||||
|
||||
| | |
|
||||
| ---------- | ---------------------- |
|
||||
| 堡垒机地址 | https://10.208.36.152/ |
|
||||
| 账号 | gzsfgw04 |
|
||||
| 密码 | GzsFgw@0805 |
|
||||
|
||||
```sh
|
||||
# mimagengx
|
||||
GzsFgw@0905
|
||||
```
|
||||
|
||||
|
||||
|
||||
### 二期服务器
|
||||
|
||||
Gzzwy@%2020$
|
||||
|
||||
```sh
|
||||
Gzzwy@%2020$
|
||||
```
|
||||
|
||||
### 二期数据库
|
||||
|
||||
fgw
|
||||
|
||||
fgw_1QAZ2wsx
|
||||
|
||||
```sh
|
||||
fgw
|
||||
|
||||
fgw_1QAZ2wsx
|
||||
```
|
||||
|
||||
|
||||
|
||||
## 三期测试服务器
|
||||
|
||||
### 三期测试堡垒机
|
||||
|
||||
| | |
|
||||
| ---------- | ---------------------- |
|
||||
| 堡垒机地址 | https://10.201.201.201 |
|
||||
| 账号 | fgwsp_czq |
|
||||
| 密码 | Bianhua@88 |
|
||||
|
||||
```sh
|
||||
# 密码更新
|
||||
Bianhua@99
|
||||
```
|
||||
|
||||
| | |
|
||||
| ---------- | ---------------------- |
|
||||
| 堡垒机地址 | https://10.208.209.224 |
|
||||
| 账号 | fgwsp_czq |
|
||||
| 密码 | Bianhua@88 |
|
||||
|
||||
### 三期测试服务器
|
||||
|
||||
| IP | 账号 | 旧密码 | 新密码 |
|
||||
| -------------- | ---- | ------------ | ------------ |
|
||||
| 10.209.246.116 | root | Passw0rd@123 | LNTwxy8%%7tE |
|
||||
| 10.209.246.117 | root | Passw0rd@123 | LNTwxy8%%7tE |
|
||||
| 10.209.246.118 | root | Passw0rd@123 | LNTwxy8%%7tE |
|
||||
| 10.209.246.119 | root | Passw0rd@123 | LNTwxy8%%7tE |
|
||||
|
||||
```sh
|
||||
# Miami
|
||||
LNTwxy8%%7tE
|
||||
```
|
||||
|
||||
## 三期正式服务器
|
||||
|
||||
### 三期正式堡垒机
|
||||
|
||||
| | |
|
||||
| ----- | ---------------------- |
|
||||
| 堡垒机地址 | https://10.208.209.224 |
|
||||
| 账号 | gzsfgw23 |
|
||||
| 密码 | FgwV3@Pszx202607 |
|
||||
|
||||
### 三期正式服务器
|
||||
|
||||
| IP | 账号 | 旧密码 | 新密码 |
|
||||
| ------------- | ---- | -------------- | ------------------ |
|
||||
| 10.209.42.11 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.12 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.13 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.14 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.15 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.16 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.17 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.18 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.19 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.20 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.21 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.209.42.22 | root | Pass@XC#202304 | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.201.23.102 | root | 123!@#Qwe | 8VLtg#ZYA@AJSFJcPM |
|
||||
| 10.201.23.103 | root | 123!@#Qwe | 8VLtg#ZYA@AJSFJcPM |
|
||||
|
||||
|
||||
|
||||
```sh
|
||||
# mima
|
||||
# Pass@XC#202304
|
||||
# 新密码
|
||||
8VLtg#ZYA@AJSFJcPM
|
||||
```
|
||||
|
||||
```sh
|
||||
# es导入json文件
|
||||
curl -H "Content-Type: application/json" -XPOST http://elastic:FgwV3202403@10.209.246.118:9200/fgw_law_file_index --data-binary "@/opt/fgw_law_file_index_data.json"
|
||||
|
||||
# es备份
|
||||
elasticdump --input=/opt/fgw_law_file_index_data.json --output=http://elastic:FgwV3202403@10.209.246.118:9200/fgw_law_file_index --all=true --type=data
|
||||
```
|
||||
|
||||
```sh
|
||||
# es服务器用户账密
|
||||
elastic
|
||||
kL7@fJ5-wN3+
|
||||
```
|
||||
|
||||
```sh
|
||||
# harbor账号密码
|
||||
admin
|
||||
CP0!y3frC@
|
||||
```
|
||||
|
||||
```sh
|
||||
# nacos账号密码
|
||||
nacos
|
||||
HU#5Zzf7AtReUF3Hg
|
||||
```
|
||||
|
||||
#达梦dba
|
||||
SYSDBA/'"Hn@dameng123"':35239
|
||||
|
||||
#发改委投资处
|
||||
FGW_TZC
|
||||
Fgw2025@04Tzc
|
||||
|
||||
FGW_TZC_MBP
|
||||
Fgw2025@04Tzc
|
||||
|
||||
Lixiaobing3905
|
||||
Gxjrapid@2607
|
||||
|
||||
Asiainfo@0427
|
||||
|
||||
完成两个:
|
||||
广州医科大学新造校区科研中心
|
||||
广州市皮肤病医院业务用房改造工程(中山四路门诊部改造工程)
|
||||

Binary file not shown.
|
After Width: | Height: | Size: 31 KiB |
Reference in New Issue
Block a user